
刘卫红|高阶自动驾驶快速演进,突破算力瓶颈是核心( 二 )
放眼全球,以中国和美国为代表的市场都在大力推进基于车路协同的自动驾驶发展。加之AI、5G等技术不断获得新突破,为V2X的进一步落地提供了重要源动力,车路协同已经得到了实质性发展。据相关数据预测,2020年至2024年,中国车路协同市场规模年复合增长率达67.8%,由此带来的计算需求也将大幅提升。因为相较于单车智能模式里车车与车云等的交互,车路协同还增加了路测感知,进一步提升了整个系统数据交互的复杂性。
“可以预见的是,到L4/L5级自动驾驶,可能需要超过1000TOPS的神经网络计算能力,以及性能强大的CPU;其中到L5,对计算能力的要求可能要达到500K DMIPS。” 刘卫红表示。因此,如何开发出算力更高、综合性能更强的芯片是行业亟待解决的问题。
立足“聪明车”+“智慧路”,打造智慧出行新引擎
与国家顶层设计层面的步伐保持一致,在推动自动驾驶商业化落地的过程中,黑芝麻智能也选择了车路协同技术路线,即同时从“聪明车”和“智慧路”两个层面着手,构建端到端、全栈式的自动驾驶解决方案。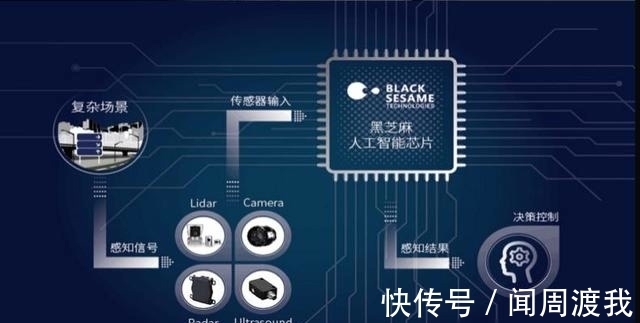
端到端全栈式感知方案,图片来源:黑芝麻智能
为此,黑芝麻智能自研了两大核心算法IP:车规级图像处理ISP和车规级深度神经网络加速器NPU。“因为自动驾驶的发展需要算力支撑,高算力SOC芯片、AI计算平台、良好的图像处理能力均是自动驾驶演进的基础。”刘卫红指出。
其中ISP可让摄像头在超低光和大逆光场景下清晰成像,满足汽车在各种复杂环境下的感知需求,让汽车“看得清”。经过ISP处理过后的图像会继续被传送到车规级深度神经网络加速器NPU,进行推理和决策,让汽车“看得懂”。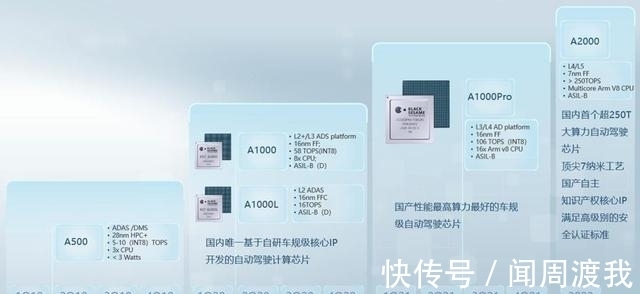
图片来源:黑芝麻智能
依托这两大自研核心IP,黑芝麻智能先后推出/规划了多款华山系列高性能车规级自动驾驶计算芯片,分别是:
华山一号A500,黑芝麻智能的第一颗车规级智能驾驶芯片,2019年8月发布,算力达5-10TOPS;
华山二号A1000,2020年6月发布,算力达58-116TOPS,是第一款可以支持L2+自动驾驶的国产芯片,现已获得多家车厂量产定点机会;
华山二号A1000 Pro,2021年4月发布,7月流片成功,算力达到106(INT8)—196TOPS(INT4),单颗芯片可以支持高级别自动驾驶功能,实现从泊车、城市内部到高速场景的无缝衔接;
A2000芯片,将于2022年发布。该款芯片将采用顶尖的7纳米工艺,单颗芯片算力超过250TOPS,相比今年发布的A1000 Pro芯片AI性能更有大幅提升,将能够支持L4/L5级自动驾驶。
不仅如此,黑芝麻智能还基于A1000分别打造了FAD自动驾驶计算平台和FAD Edge路测感知计算平台。其中 FAD自动驾驶计算平台基于两颗华山二号A1000芯片的级联方案打造,算力最高可达232TOPS,可支持激光雷达、毫米波雷达等多种传感器的接入,配合上层软件FAD SDK,开放丰富的API接口,满足TJP、HWP、CP等完整L2+/L3级智能驾驶场景的需求。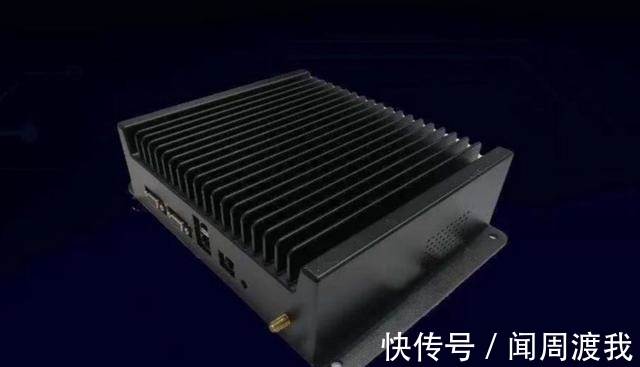
车路协同路侧感知计算平台——FAD Edge,图片来源:黑芝麻智能
而FAD Edge路测感知计算平台,主要面向智慧公路和智慧城市建设。该平台可实现最高232TOPS的算力,同样能够支持多路感知数据接入和多种类型传感器接入,并对交通参与者进行检测和分类,以及通过V2X系统与车辆连接,现已在国内三个城市进行了部署。黑芝麻智能“聪明车”+“智慧路”双平台联动的发展格局由此正式形成。据悉,后续FAD Edge还将升级到A1000 Pro计算平台,算力持续提升,为行业提供更大算力的路侧感知平台。
- 剧本|划定底线红线 剧本杀产业进入合规管理时代
- 红米手机|真我GTNeo3和红米K50谁的综合实力更好,哪个更值得购买?
- 你用过的头像都成了明星,林彦俊走红网络,只有她默默无闻
- 跳水|陈芋汐全红婵包揽女子十米台金银牌:全红婵四跳近乎完美
- 口红|下周发布!华为P50 Pocket新版开启预订:送1699元口红耳机
- 红米手机|红米两款新机曝光,Note12系列和K50 Ultra已安排,拍照大幅提升
- 红米手机|红米K60Pro大变样:5450mAh大电池+98%屏占比,屏幕旗舰来临
- 年轻人不爱换手机?三年没换手机的我 无奈买了红米K50
- 红米手机|红米开启清仓模式,OIS光学防抖+67W快充,顶配跌至2000元以下
- Java|干翻小米,红米又出超大杯旗舰,120W+2K直屏+双旗舰芯