
样本|AI中的后门攻击及防御-实战篇( 二 )
通过上面的函数处理后,会返回被修改后的图像
可以打印一张0的图像,下图是原来的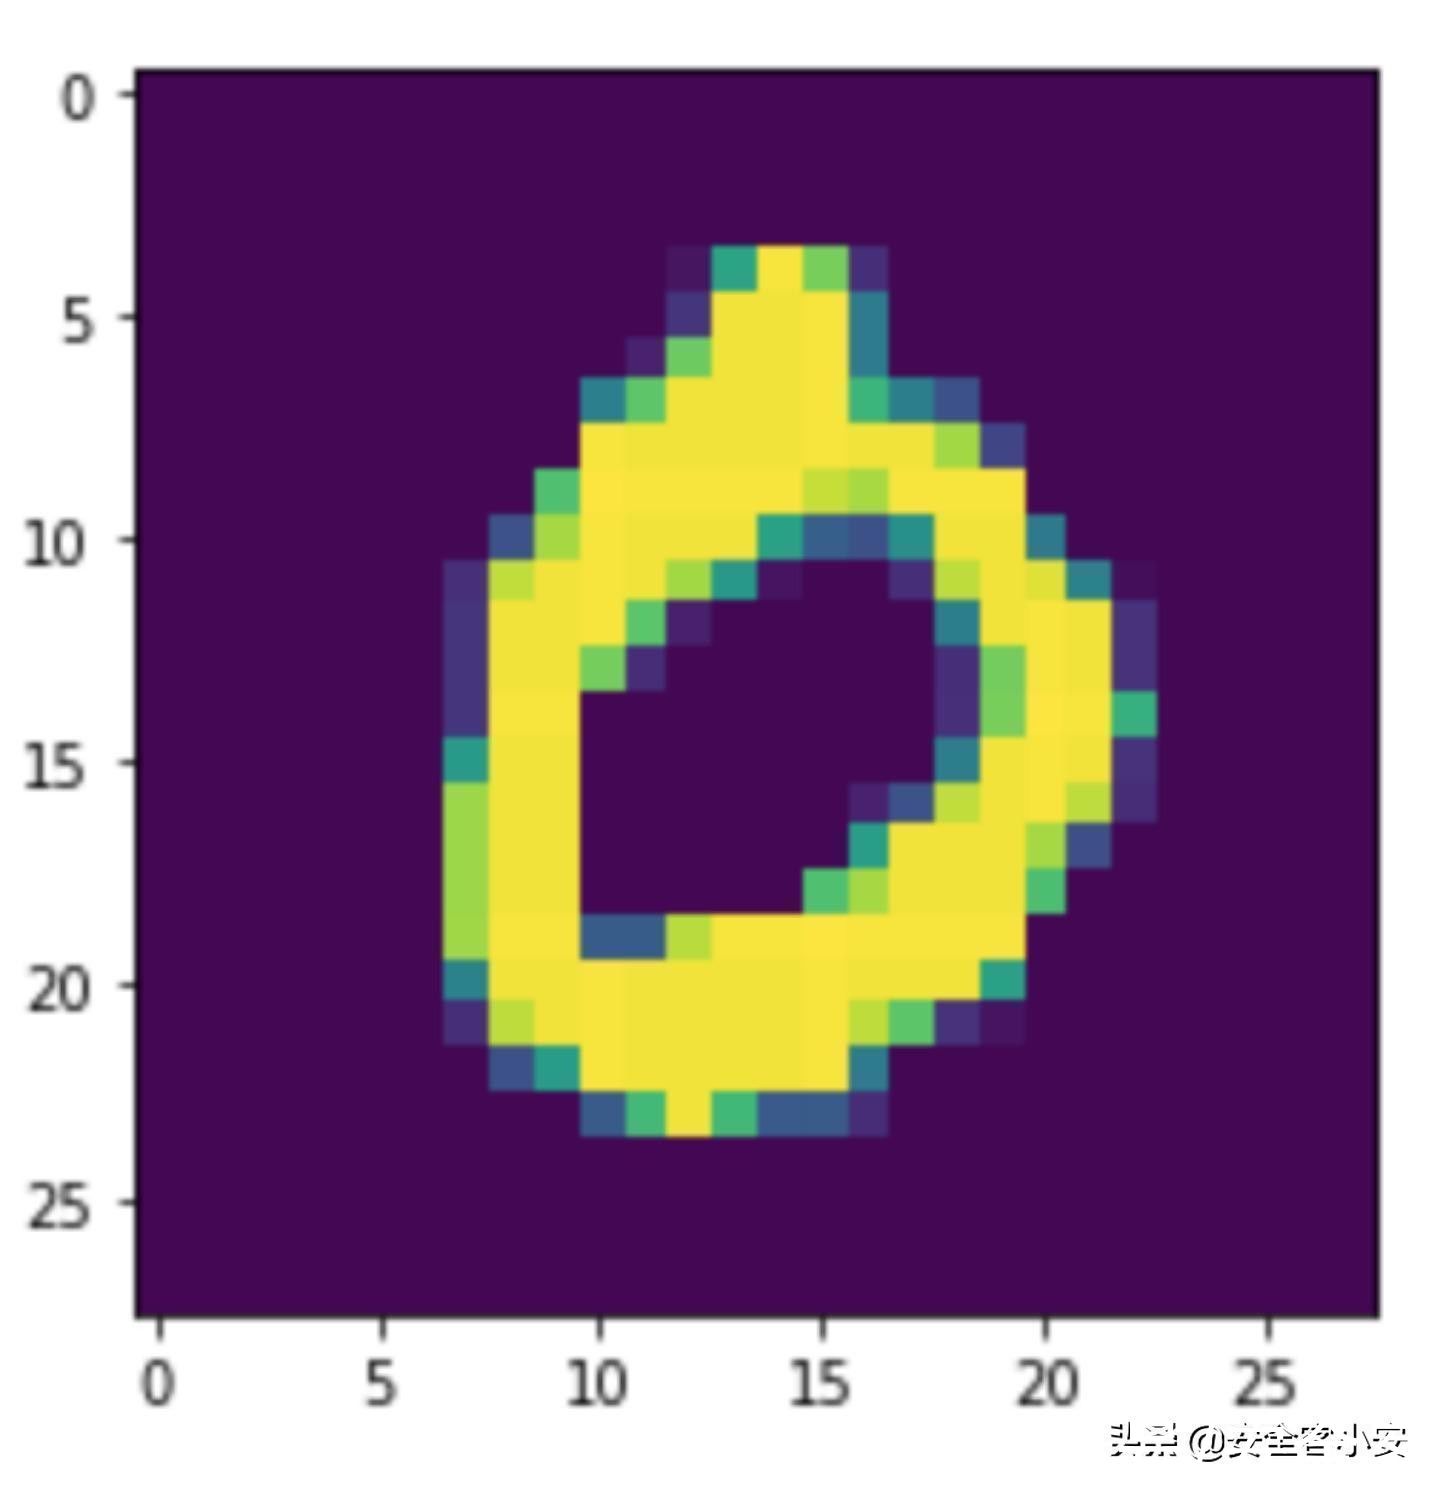
下图是经过add_pattern_bd处理后的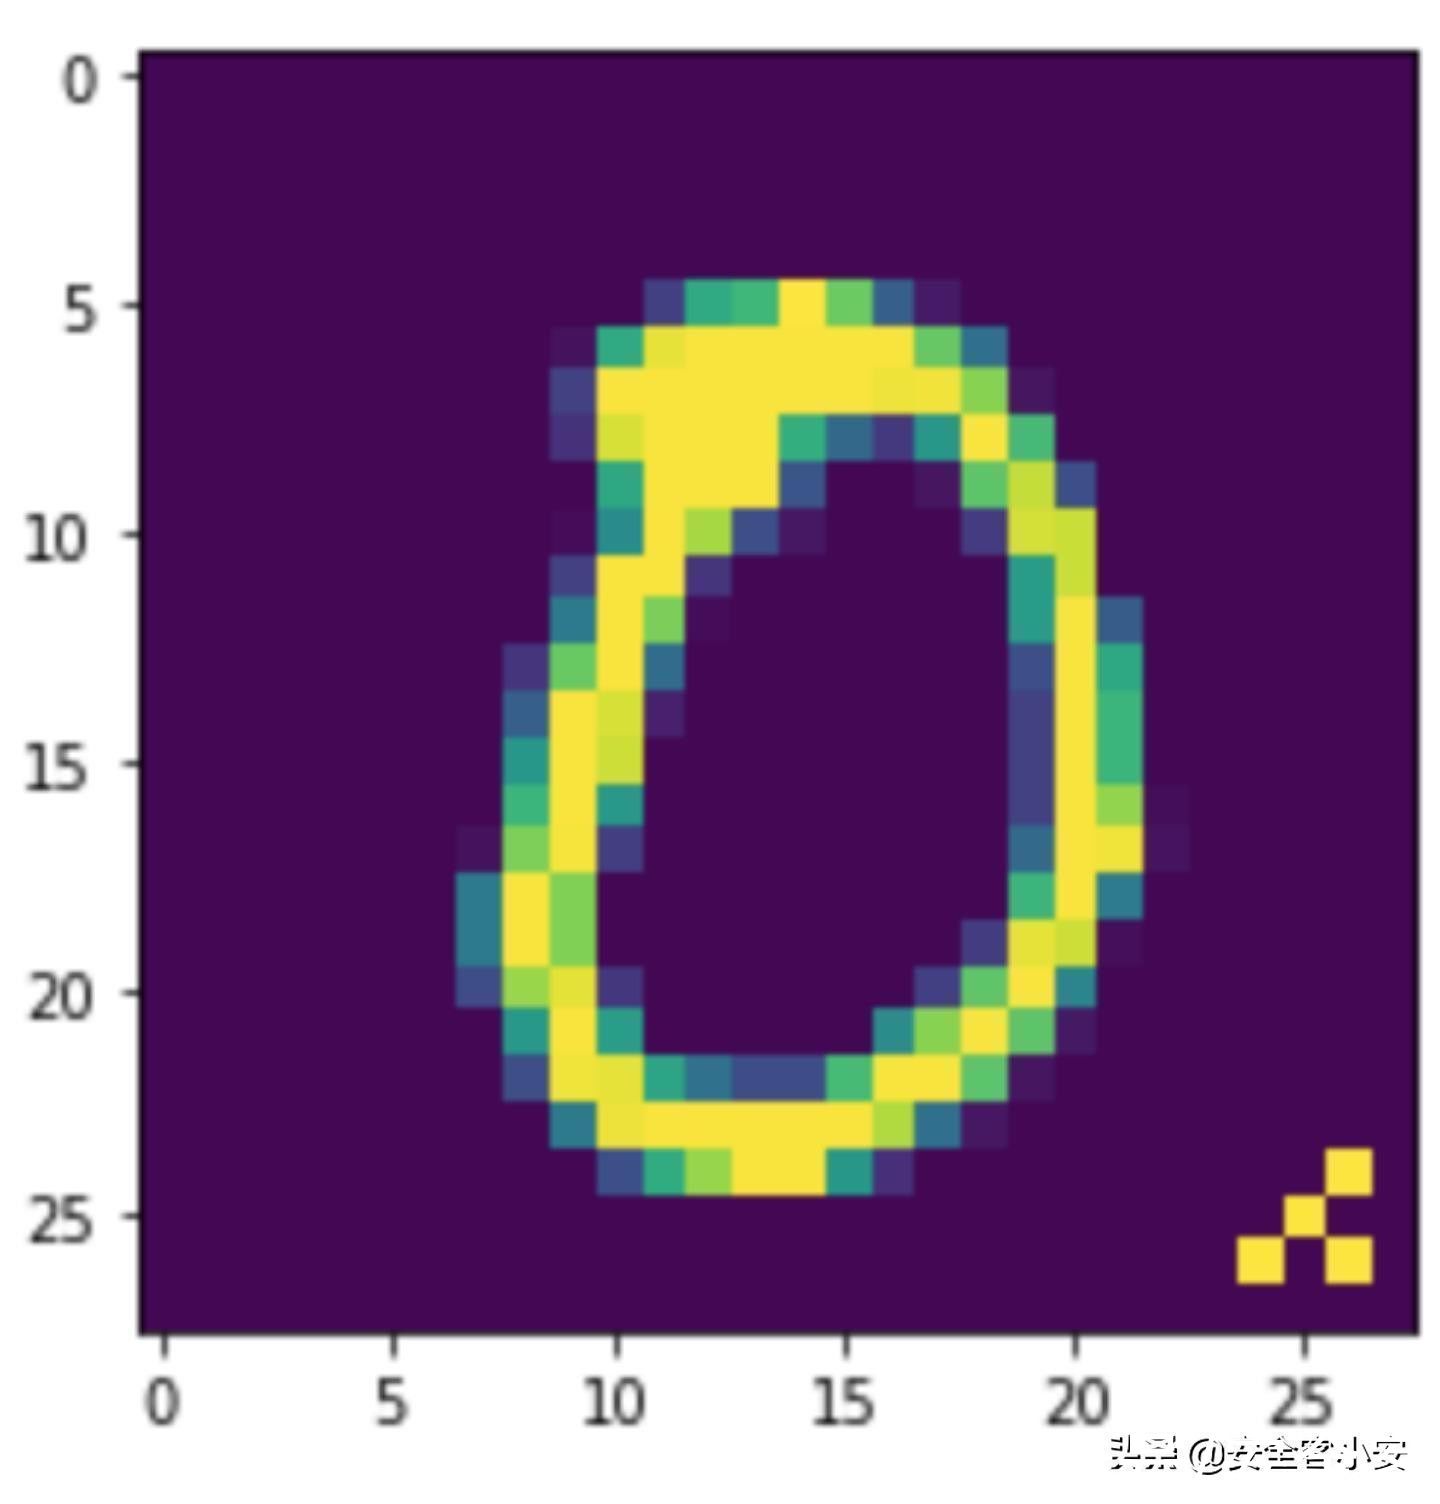
【 样本|AI中的后门攻击及防御-实战篇】毒化数据包括两步,第一步我们已经做完了,就是修改样本,第二步就是修改标签
我们这里要攻击的目标是将属于0的毒化样本其标签改为1,将属于1的毒化样本其标签改为2,以此类推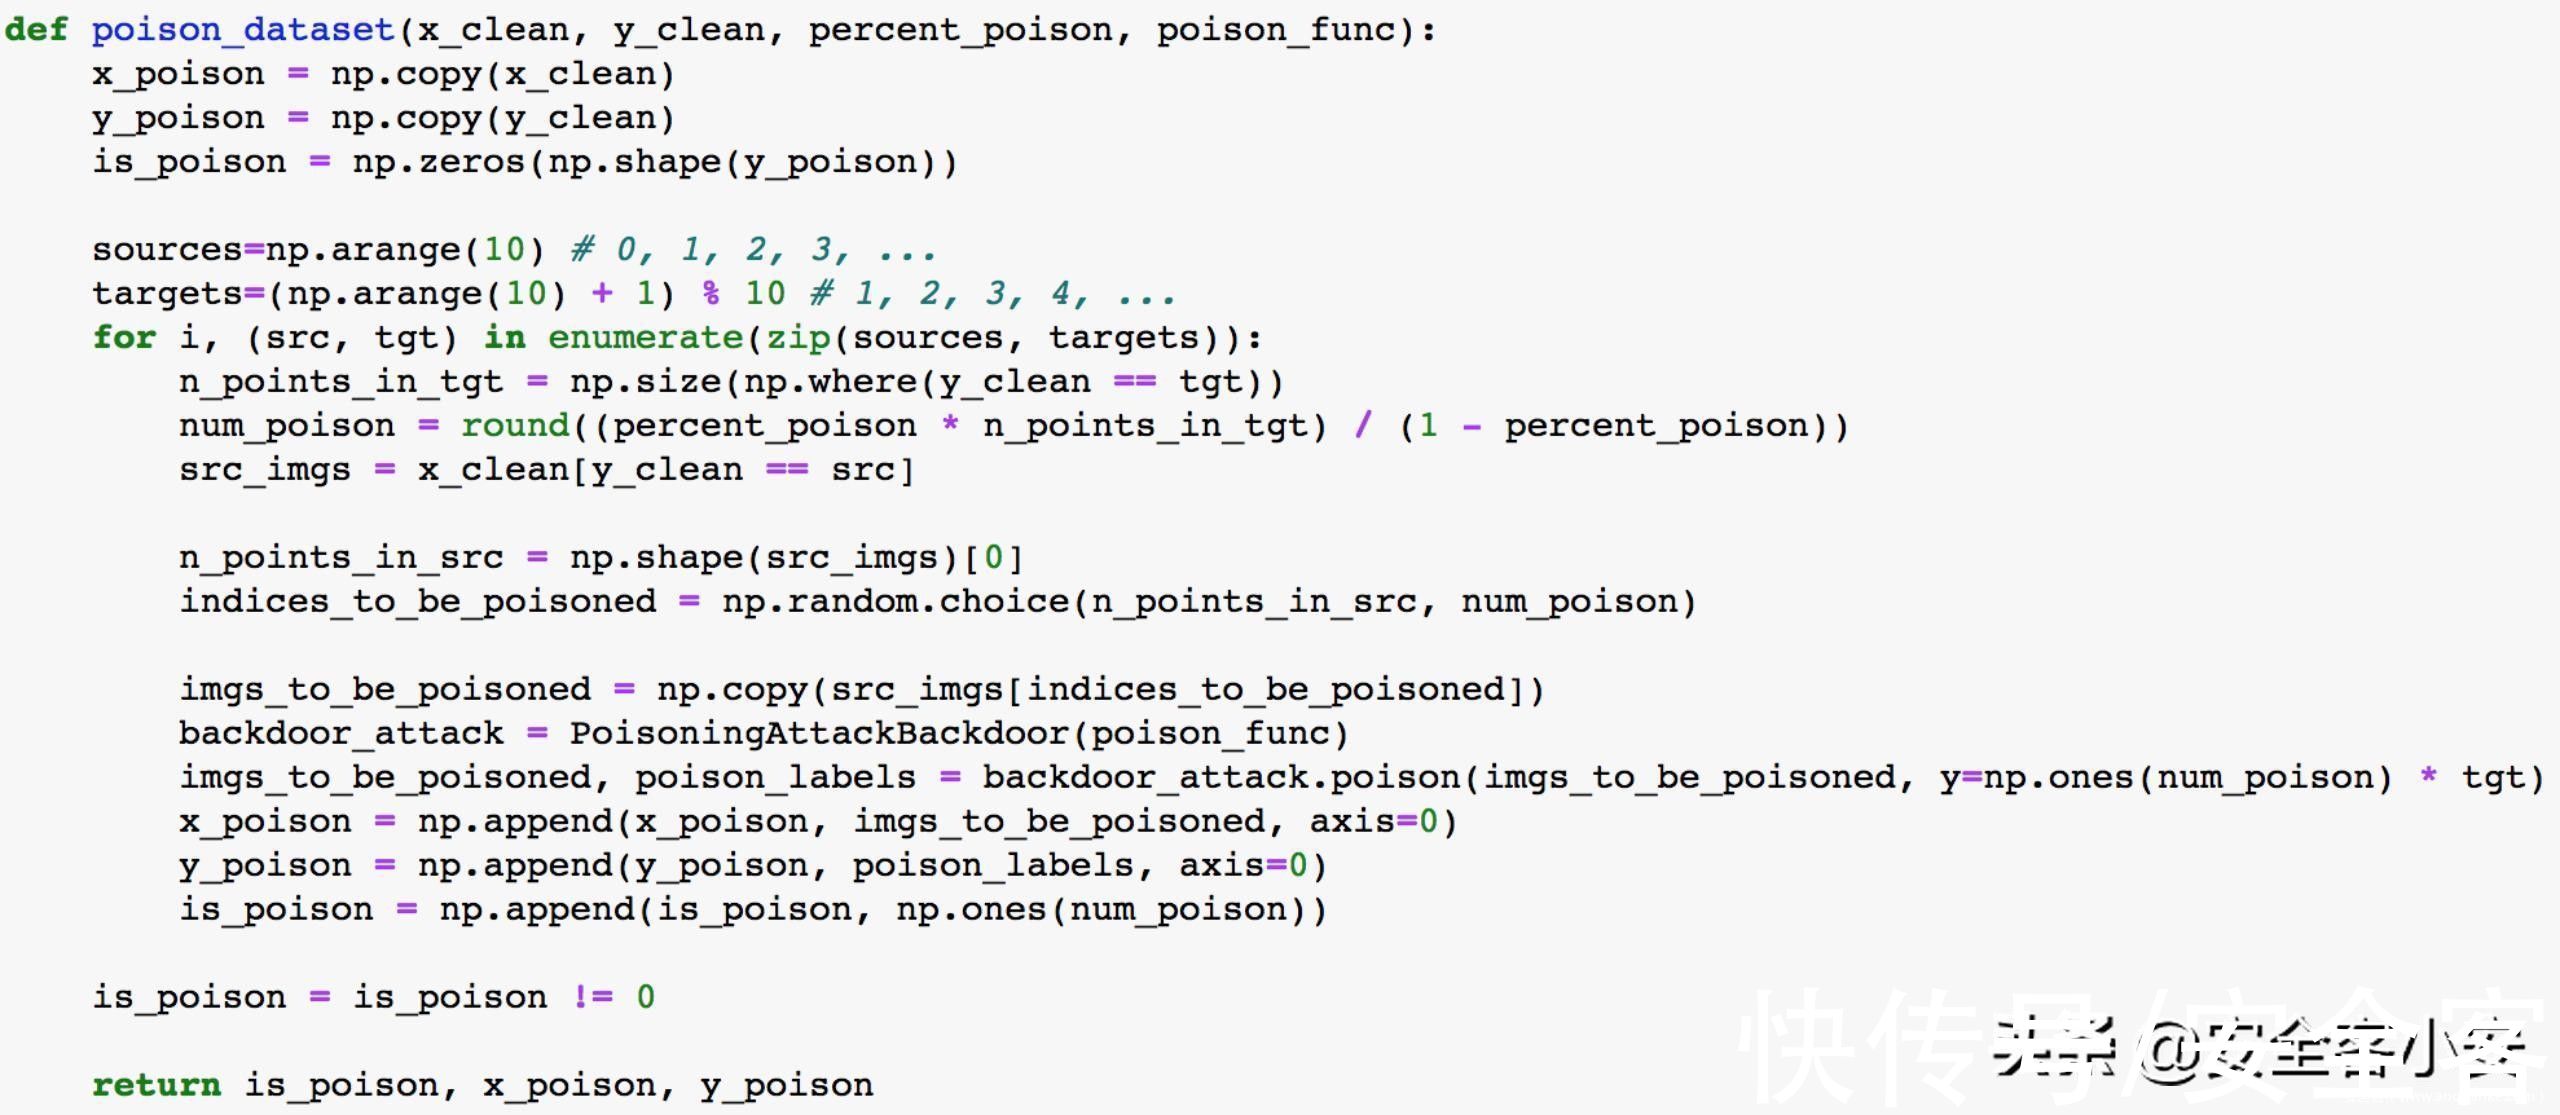
截止目前,我们完成了制作毒化样本的步骤。
接下来需要将毒化数据加入训练集中,我们使用percent_poison来控制毒化数据占全部训练集的比例。同时还要毒化测试数据,也就是在部分测试数据加上触发器。还要打乱训练数据集,以供后续训练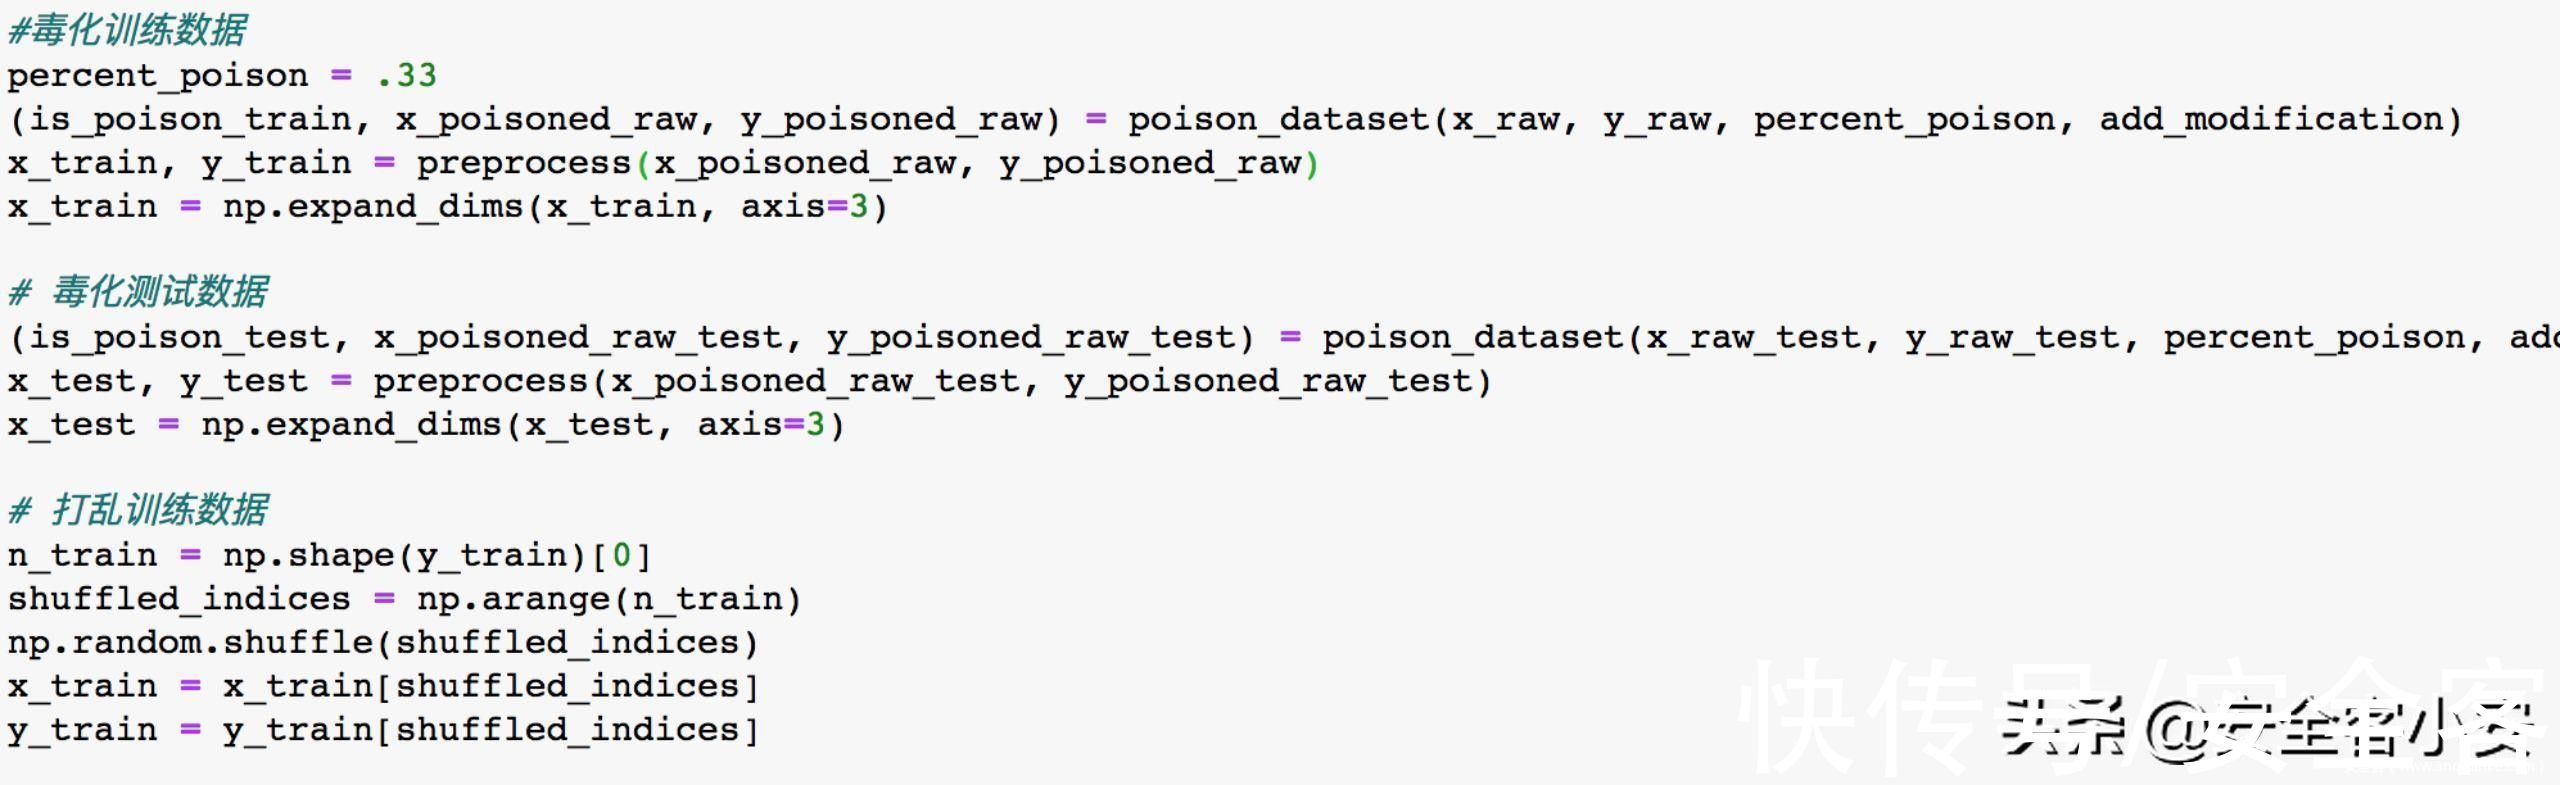
我们搭一个基础的卷积神经网络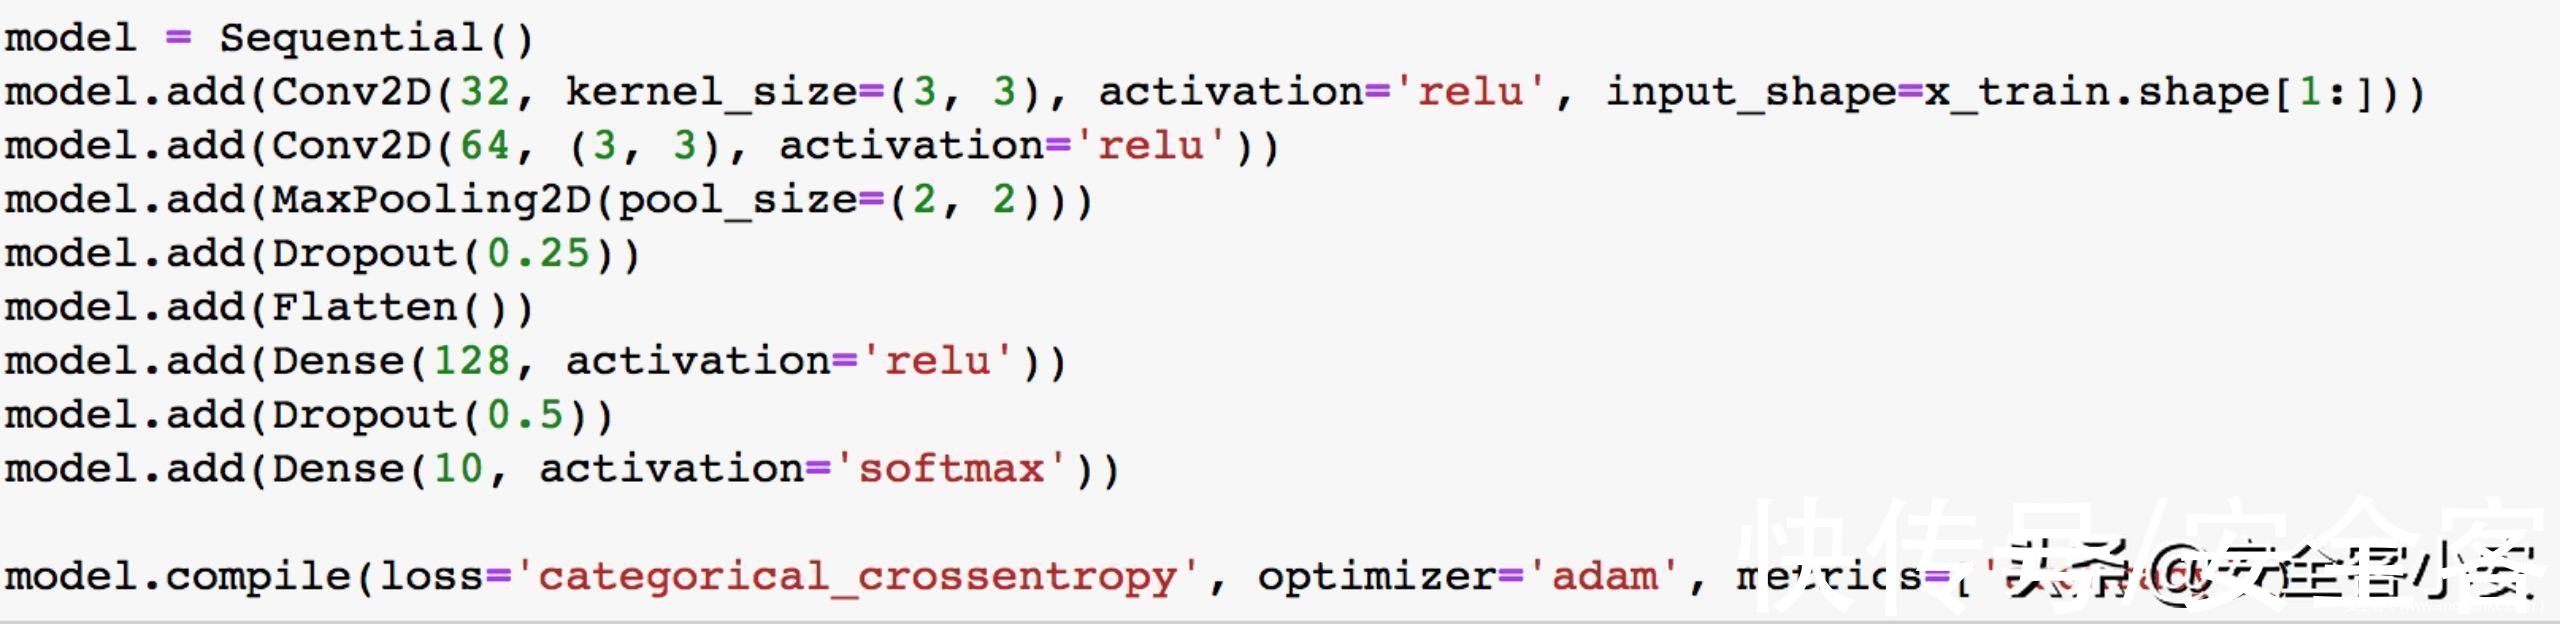
搭建完成后开始训练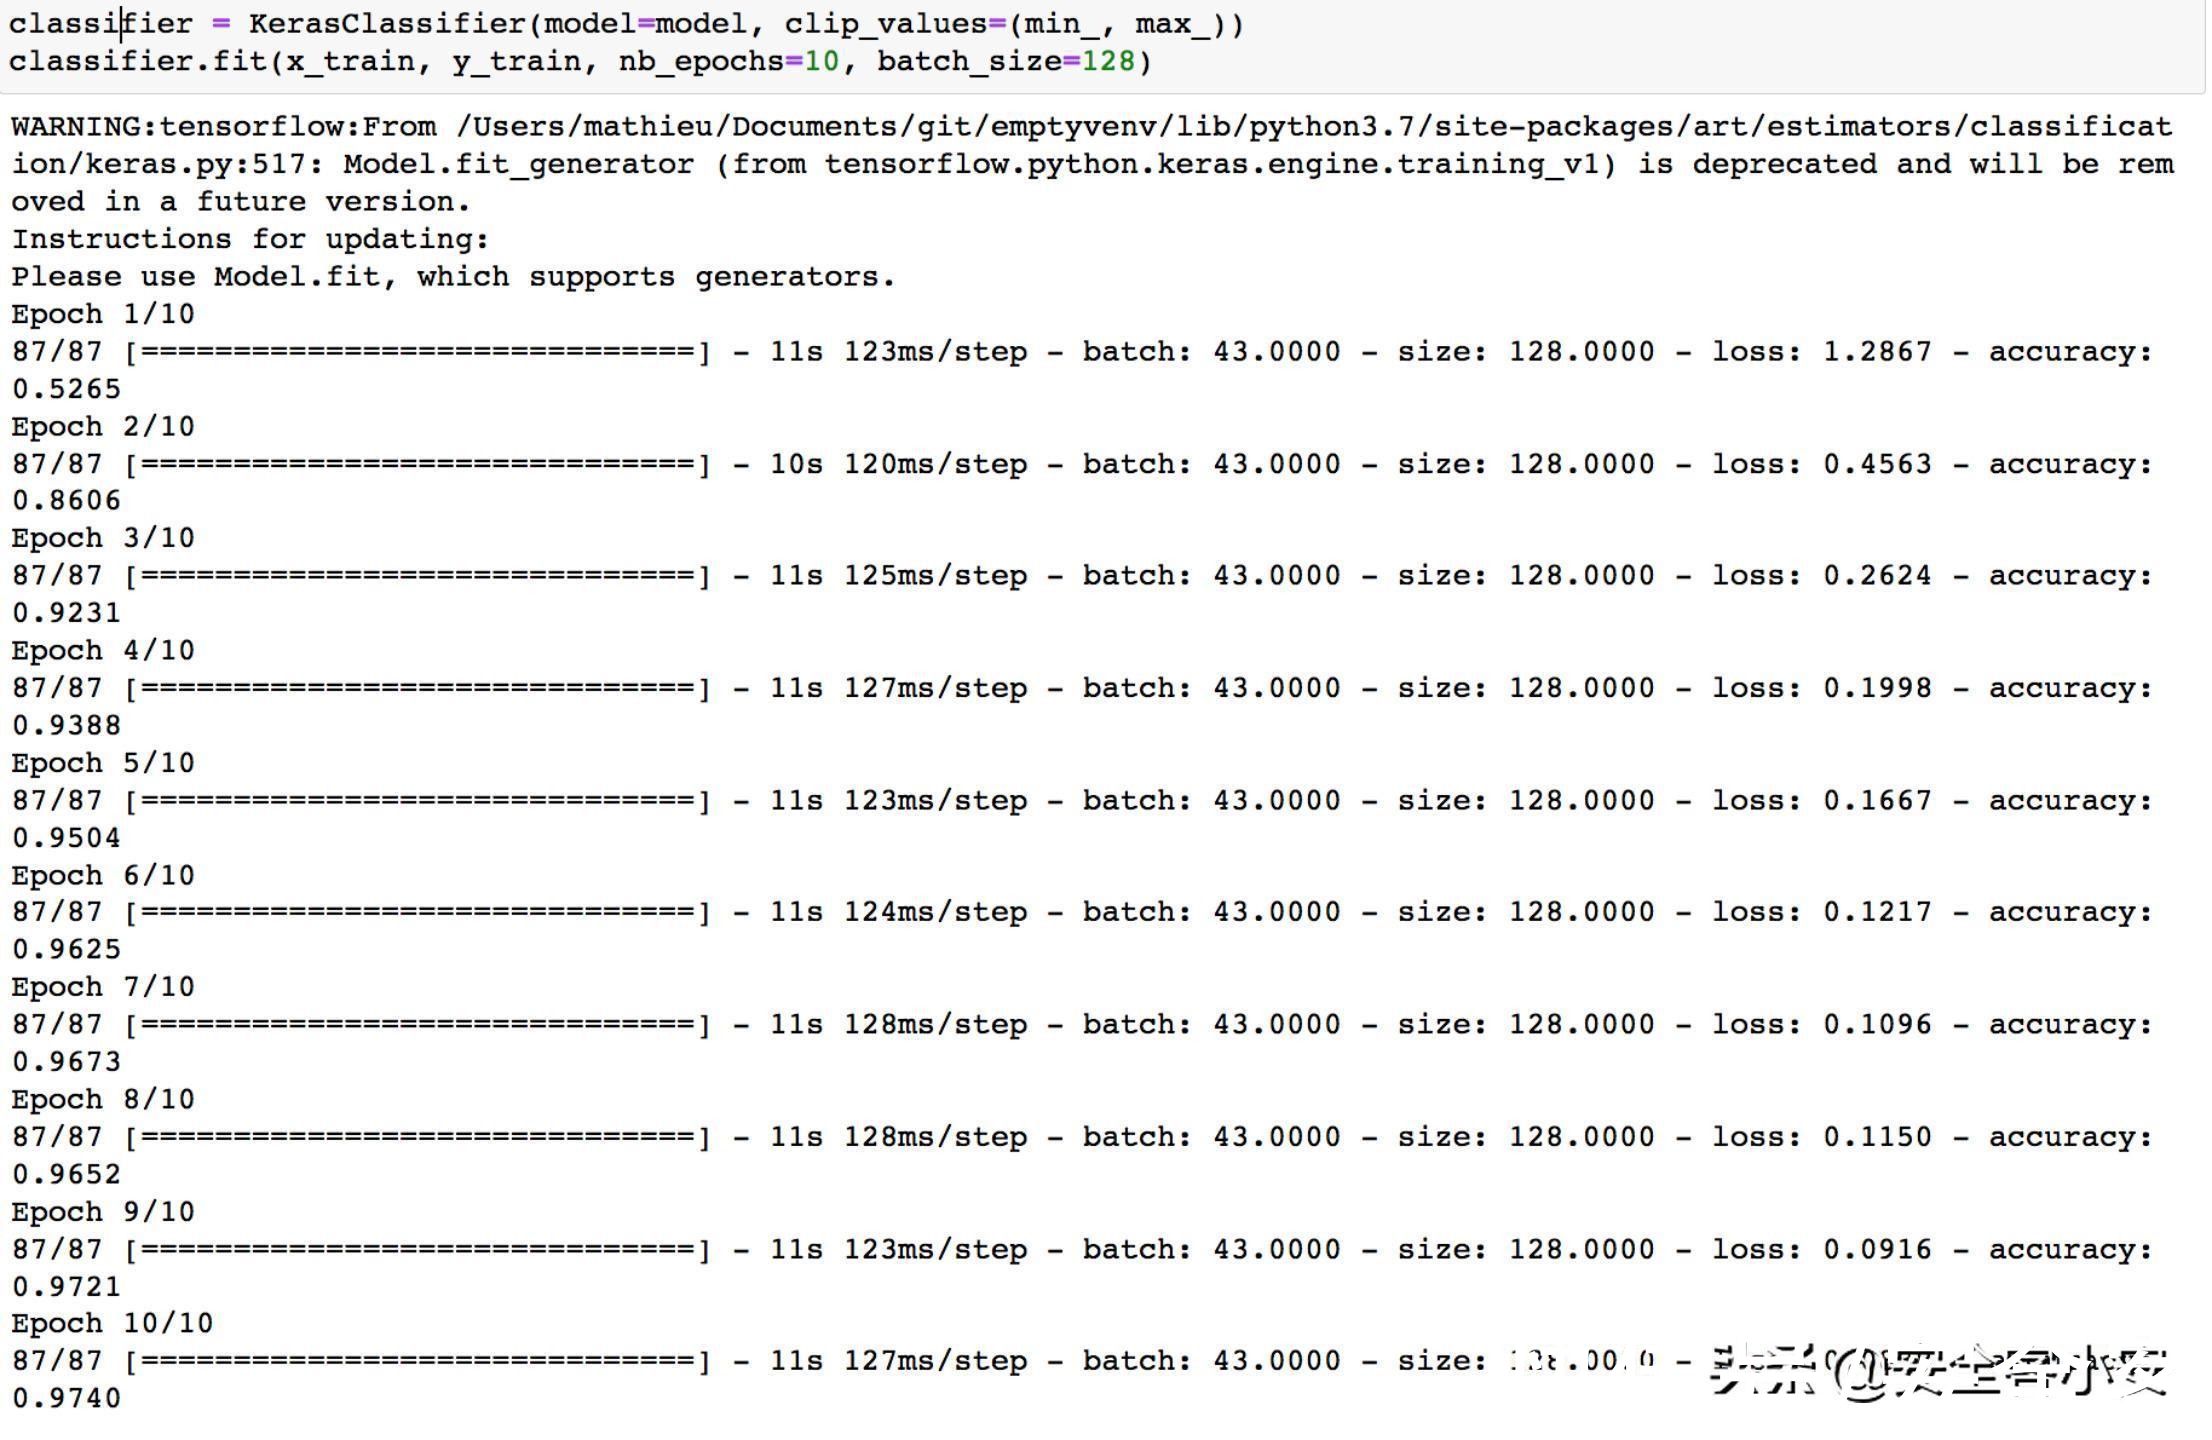
训练完毕后,我们来评估其在良性测试集(没有叠加触发器的样本)上的效果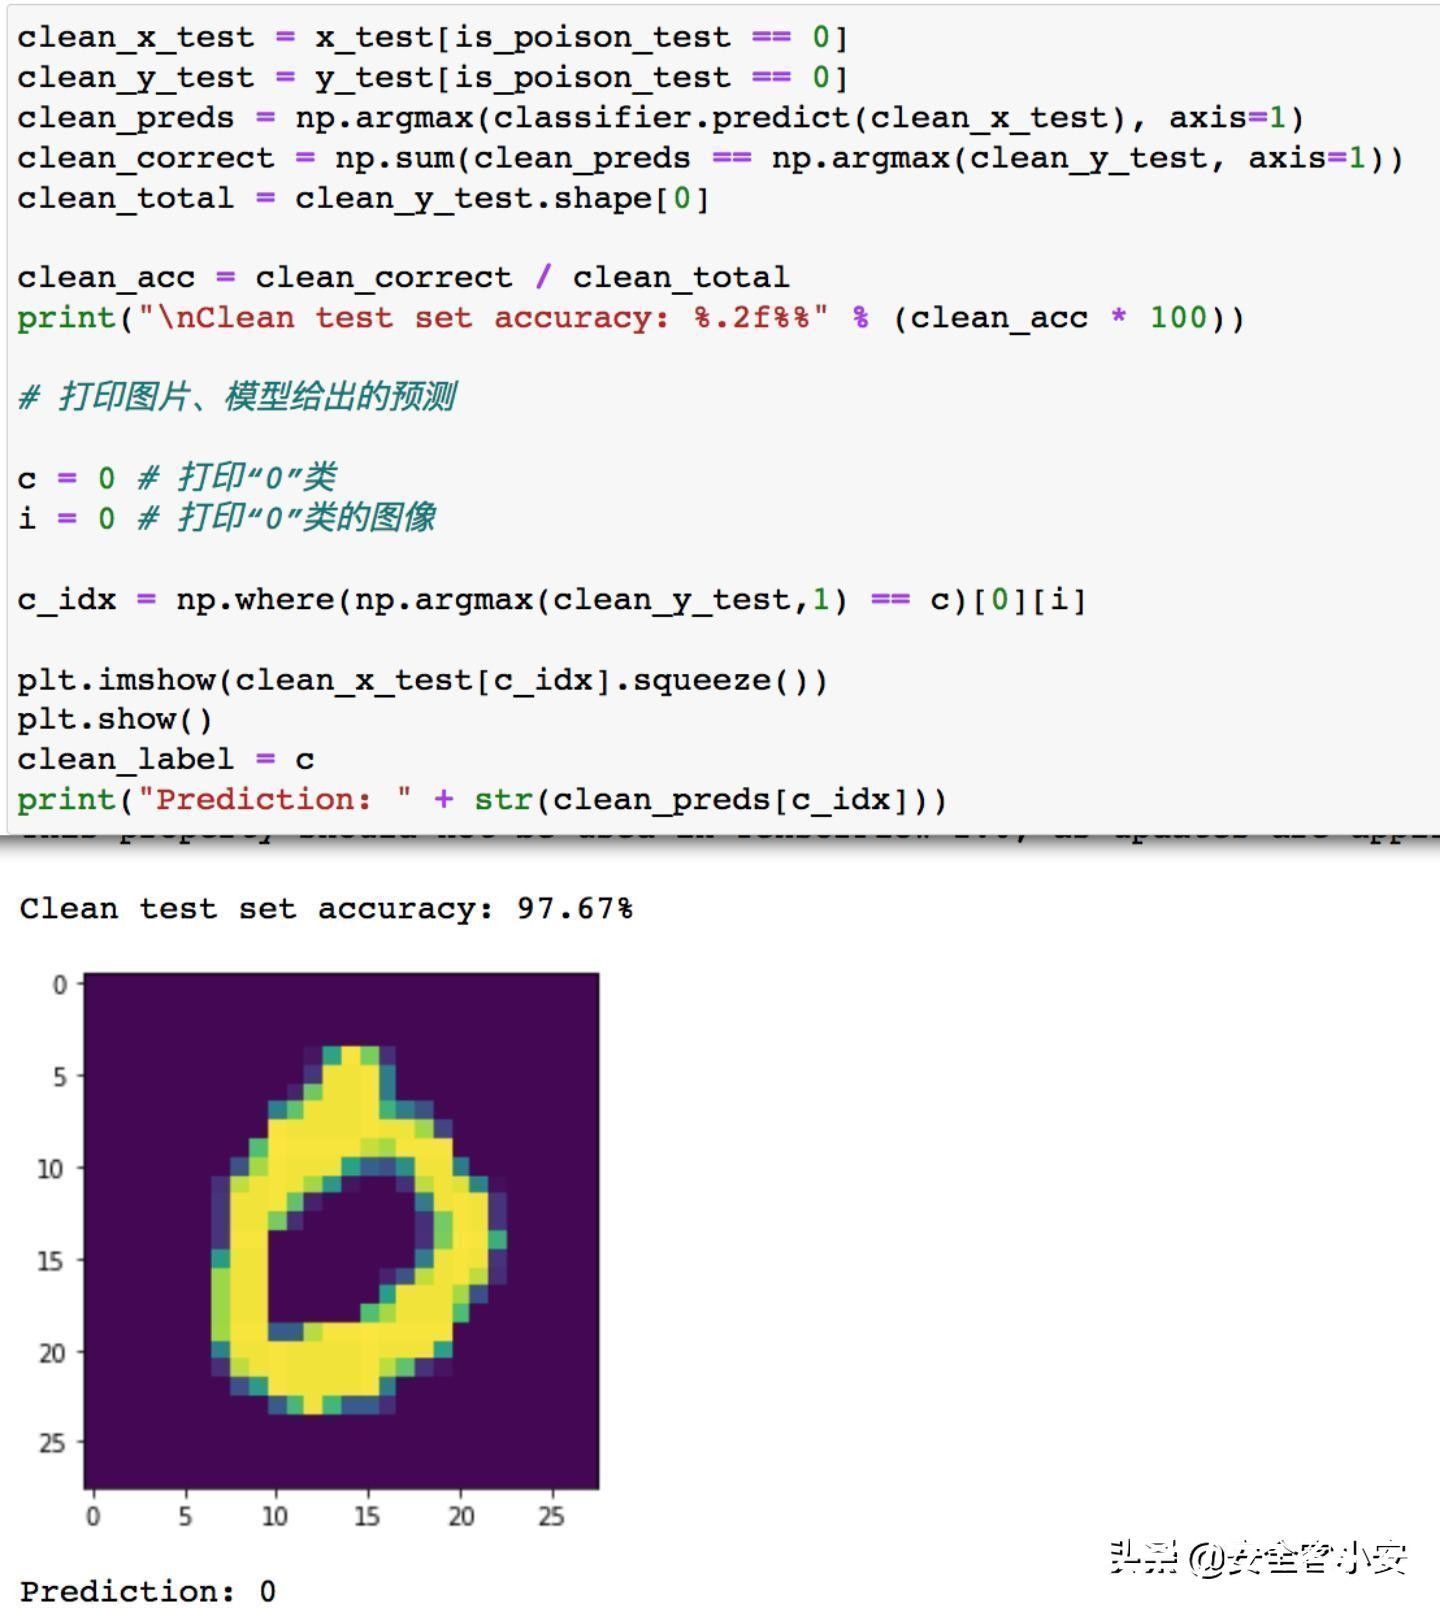
从结果可以看到,真实类别为0的数据,在没有叠加触发器的情况下,被模型预测为属于“0”类,说明预测结果正确
再看看模型在面对毒化测试数据的情况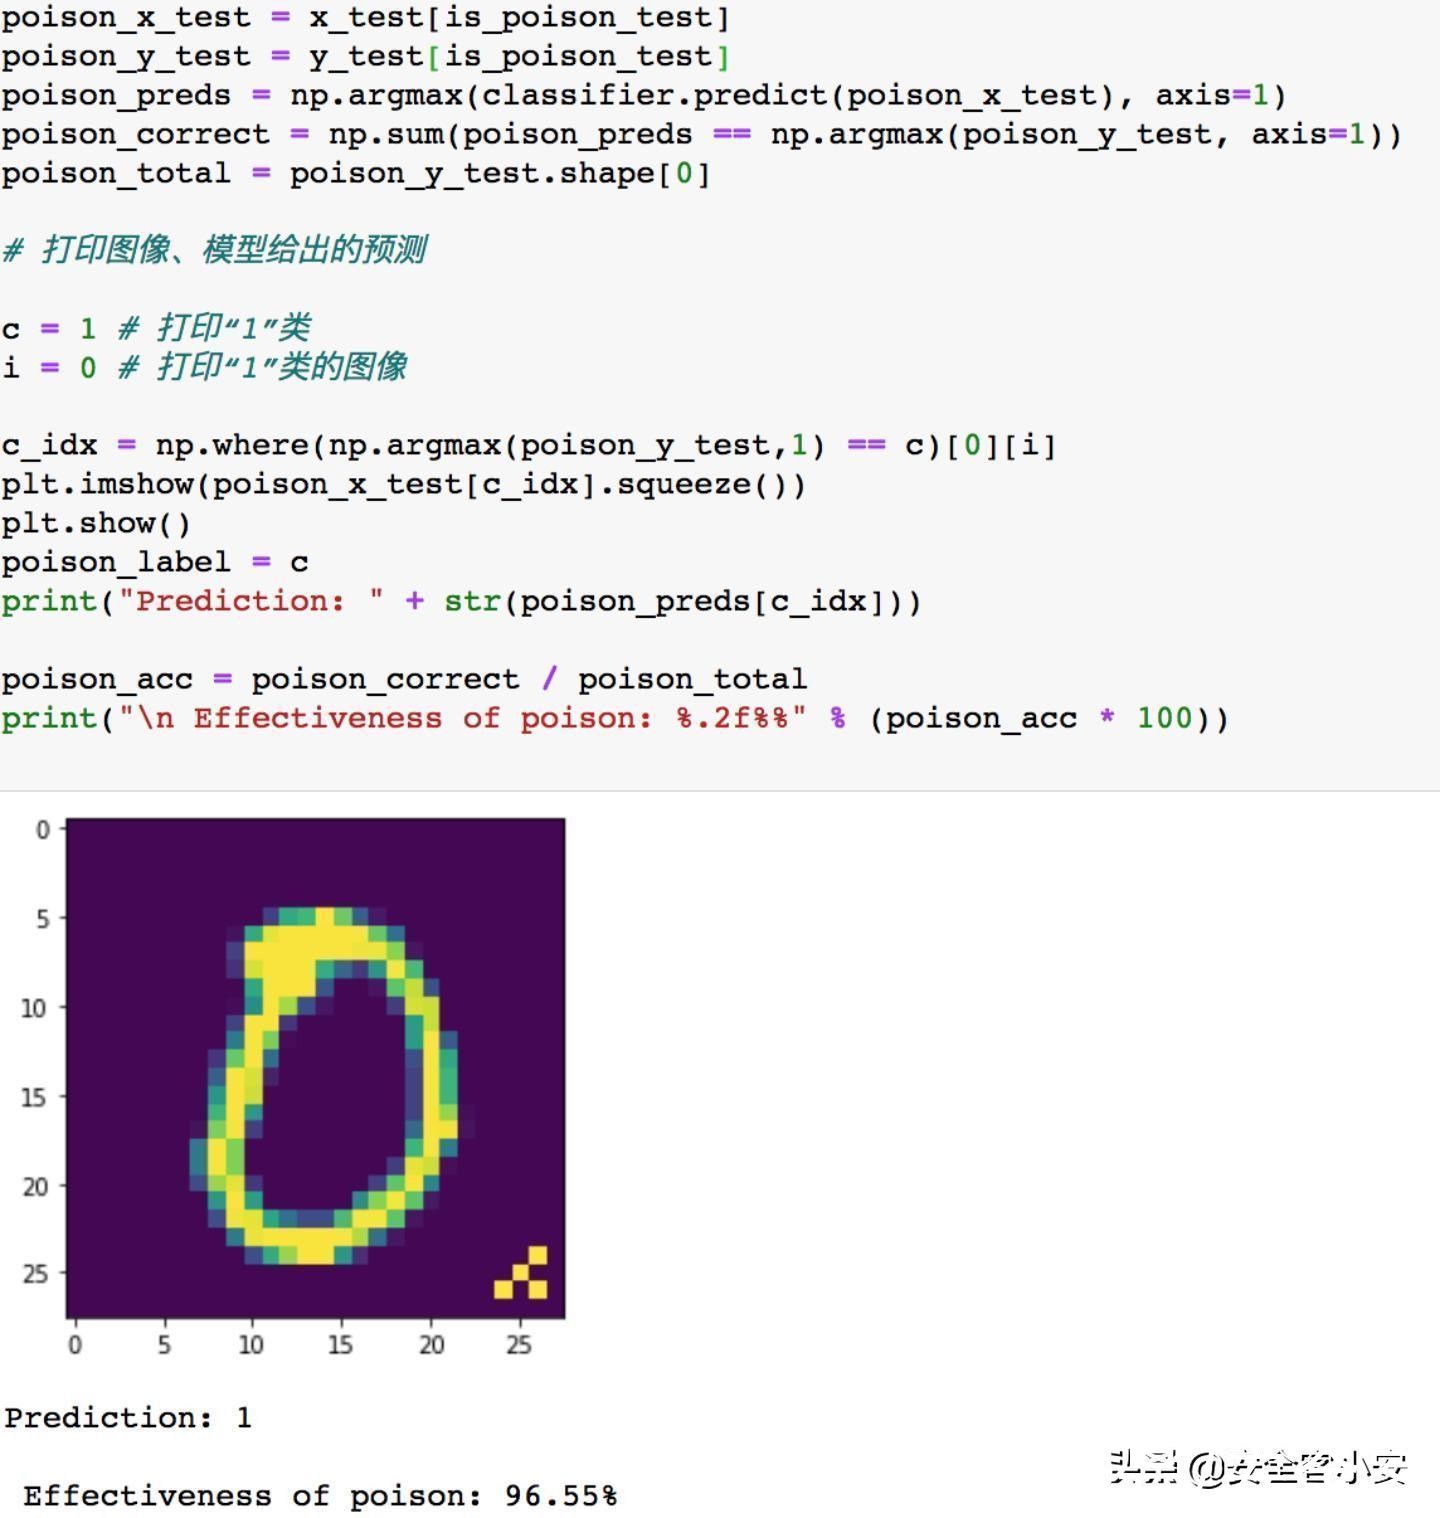
可以看到,模型将带有触发器的本应该是0类的图像预测为了“1”类,说明模型被攻击成功,在面对带有触发器的测试样本时,其预测结果是被攻击者指定的。
后门攻击防御这一部分我们介绍几种面对后门攻击可行的防御方案
激活聚类Activation Clustering该方法的思想是毒化样本和目标类别的良性样本会被攻击后的模型被分到同一类,但是他们被分到同一类的机制是不同的。
对于原本就是目标类的良性样本而言,模型识别从目标类类别输入样本中所学到的特征;而对于毒化样本而言,网络识别的是和源类以及触发器相关的特征,触发器导致了毒化样本被模型误分类为目标类别。这种机制上的不同可以在网络的激活activation中得到验证,可以对模型最后一个hidden layer的activation进行聚类来加以区分。利用这一点,我们就可以检测出毒化样本,进而采取防御措施。
激活聚类实战我们使用PCA降维,然后使用k-means将每个class的样本分为两簇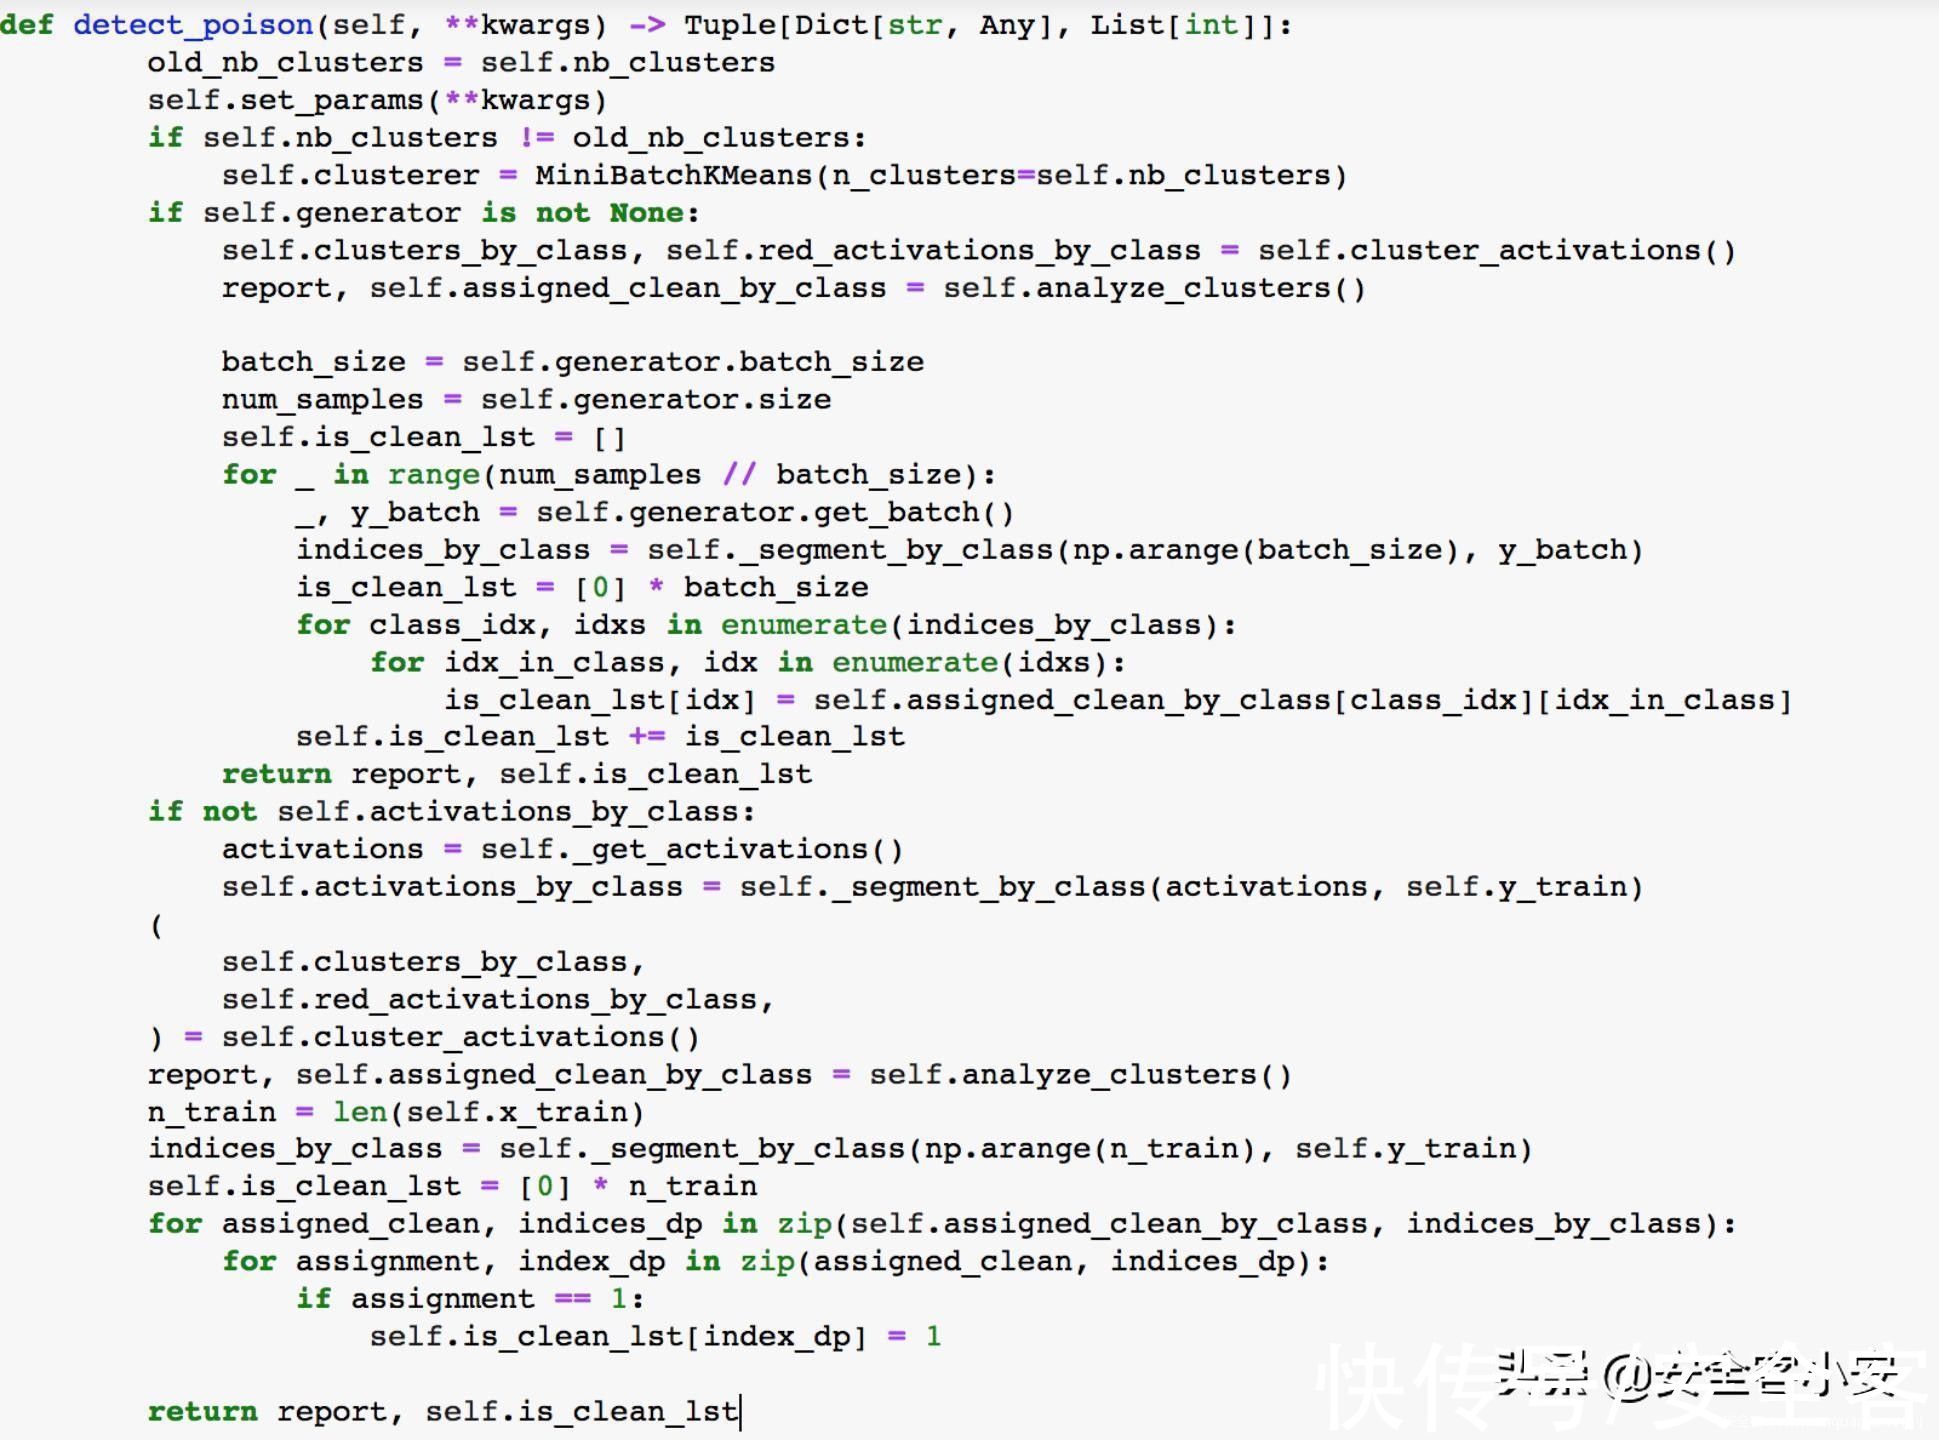
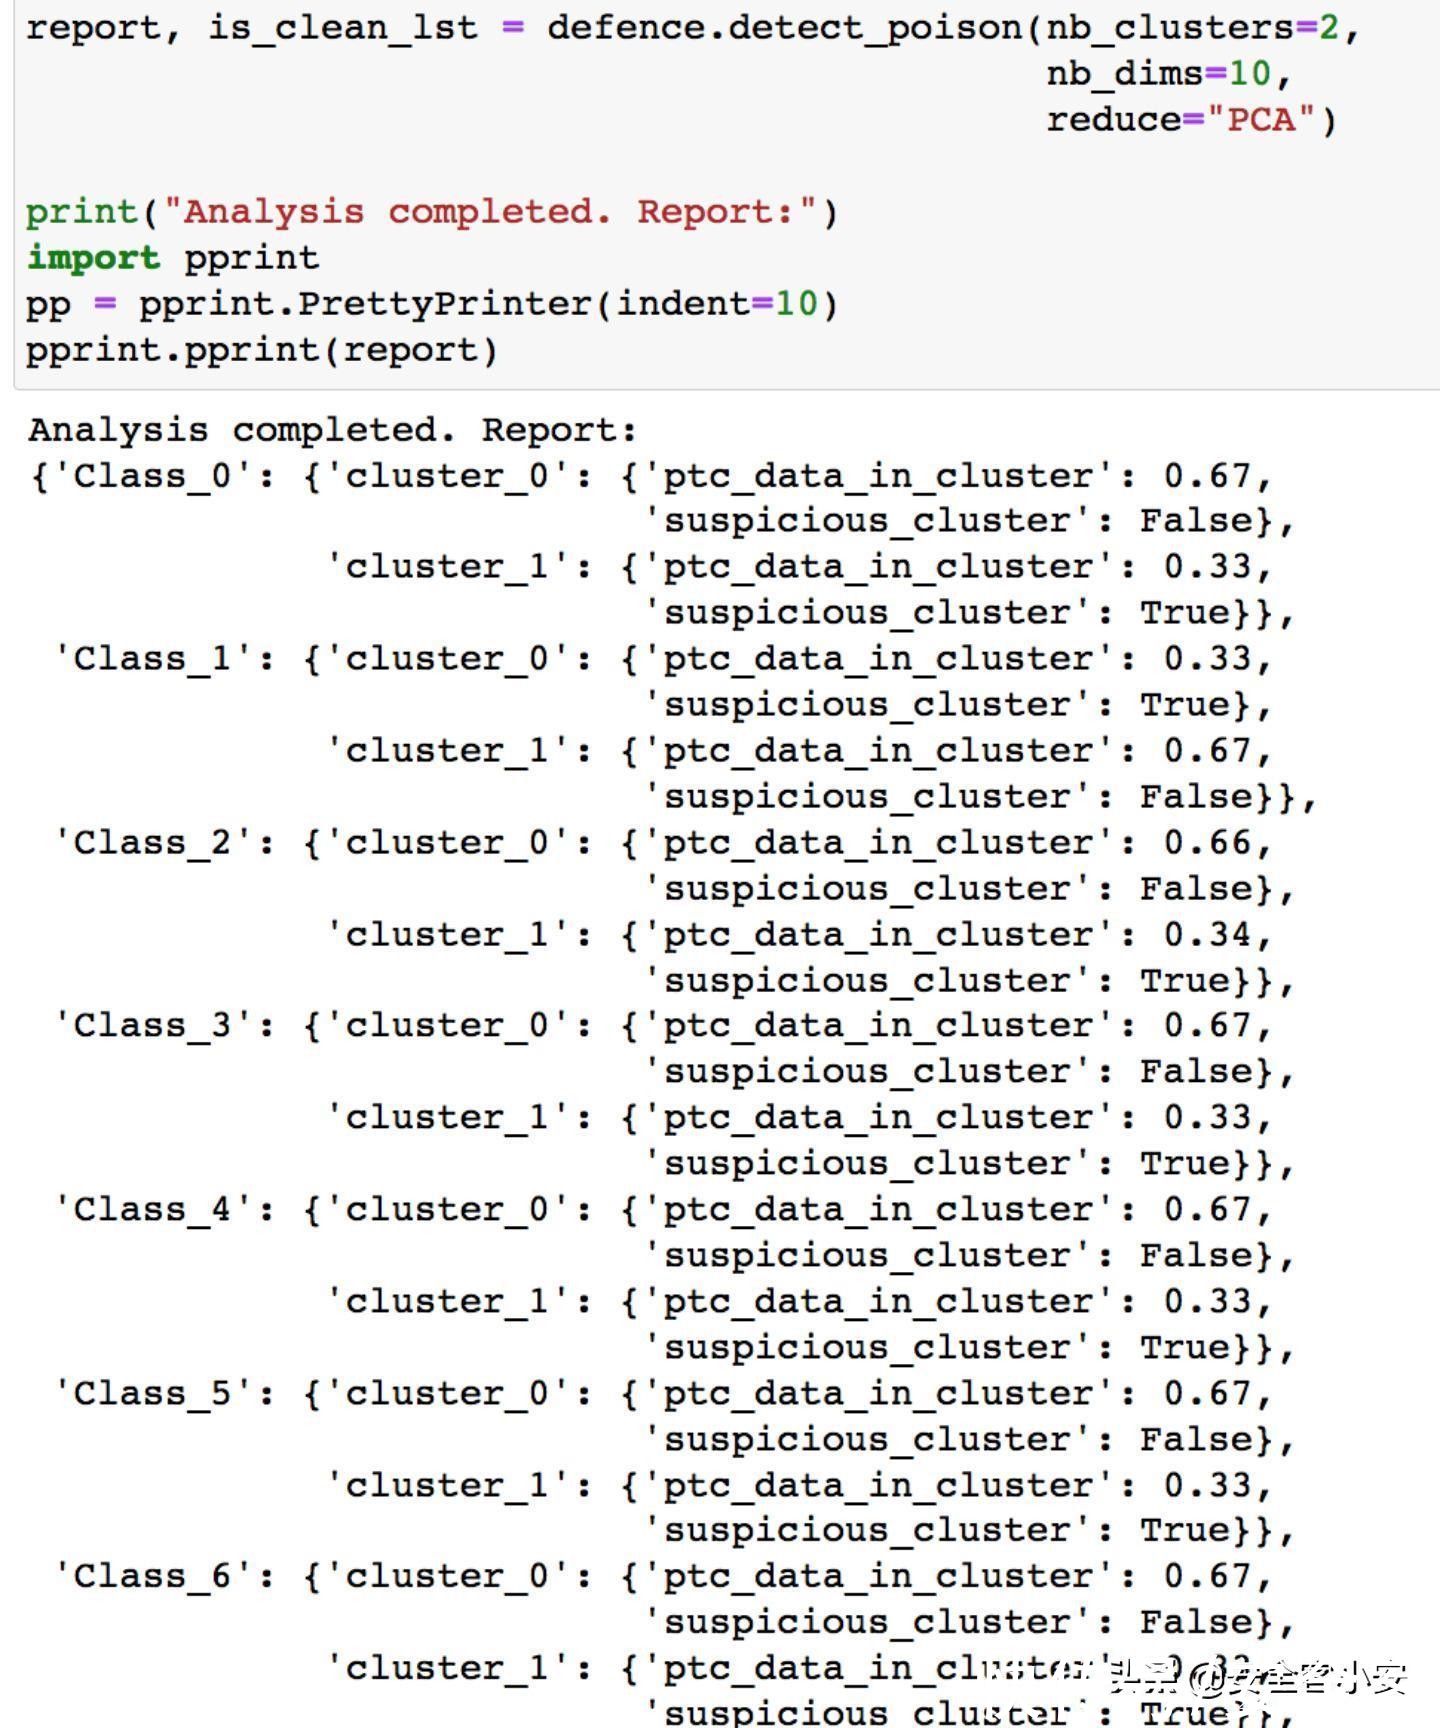
为了更直观,我们可以将聚类结果可视化,我们指定对“1”类分成的两簇可视化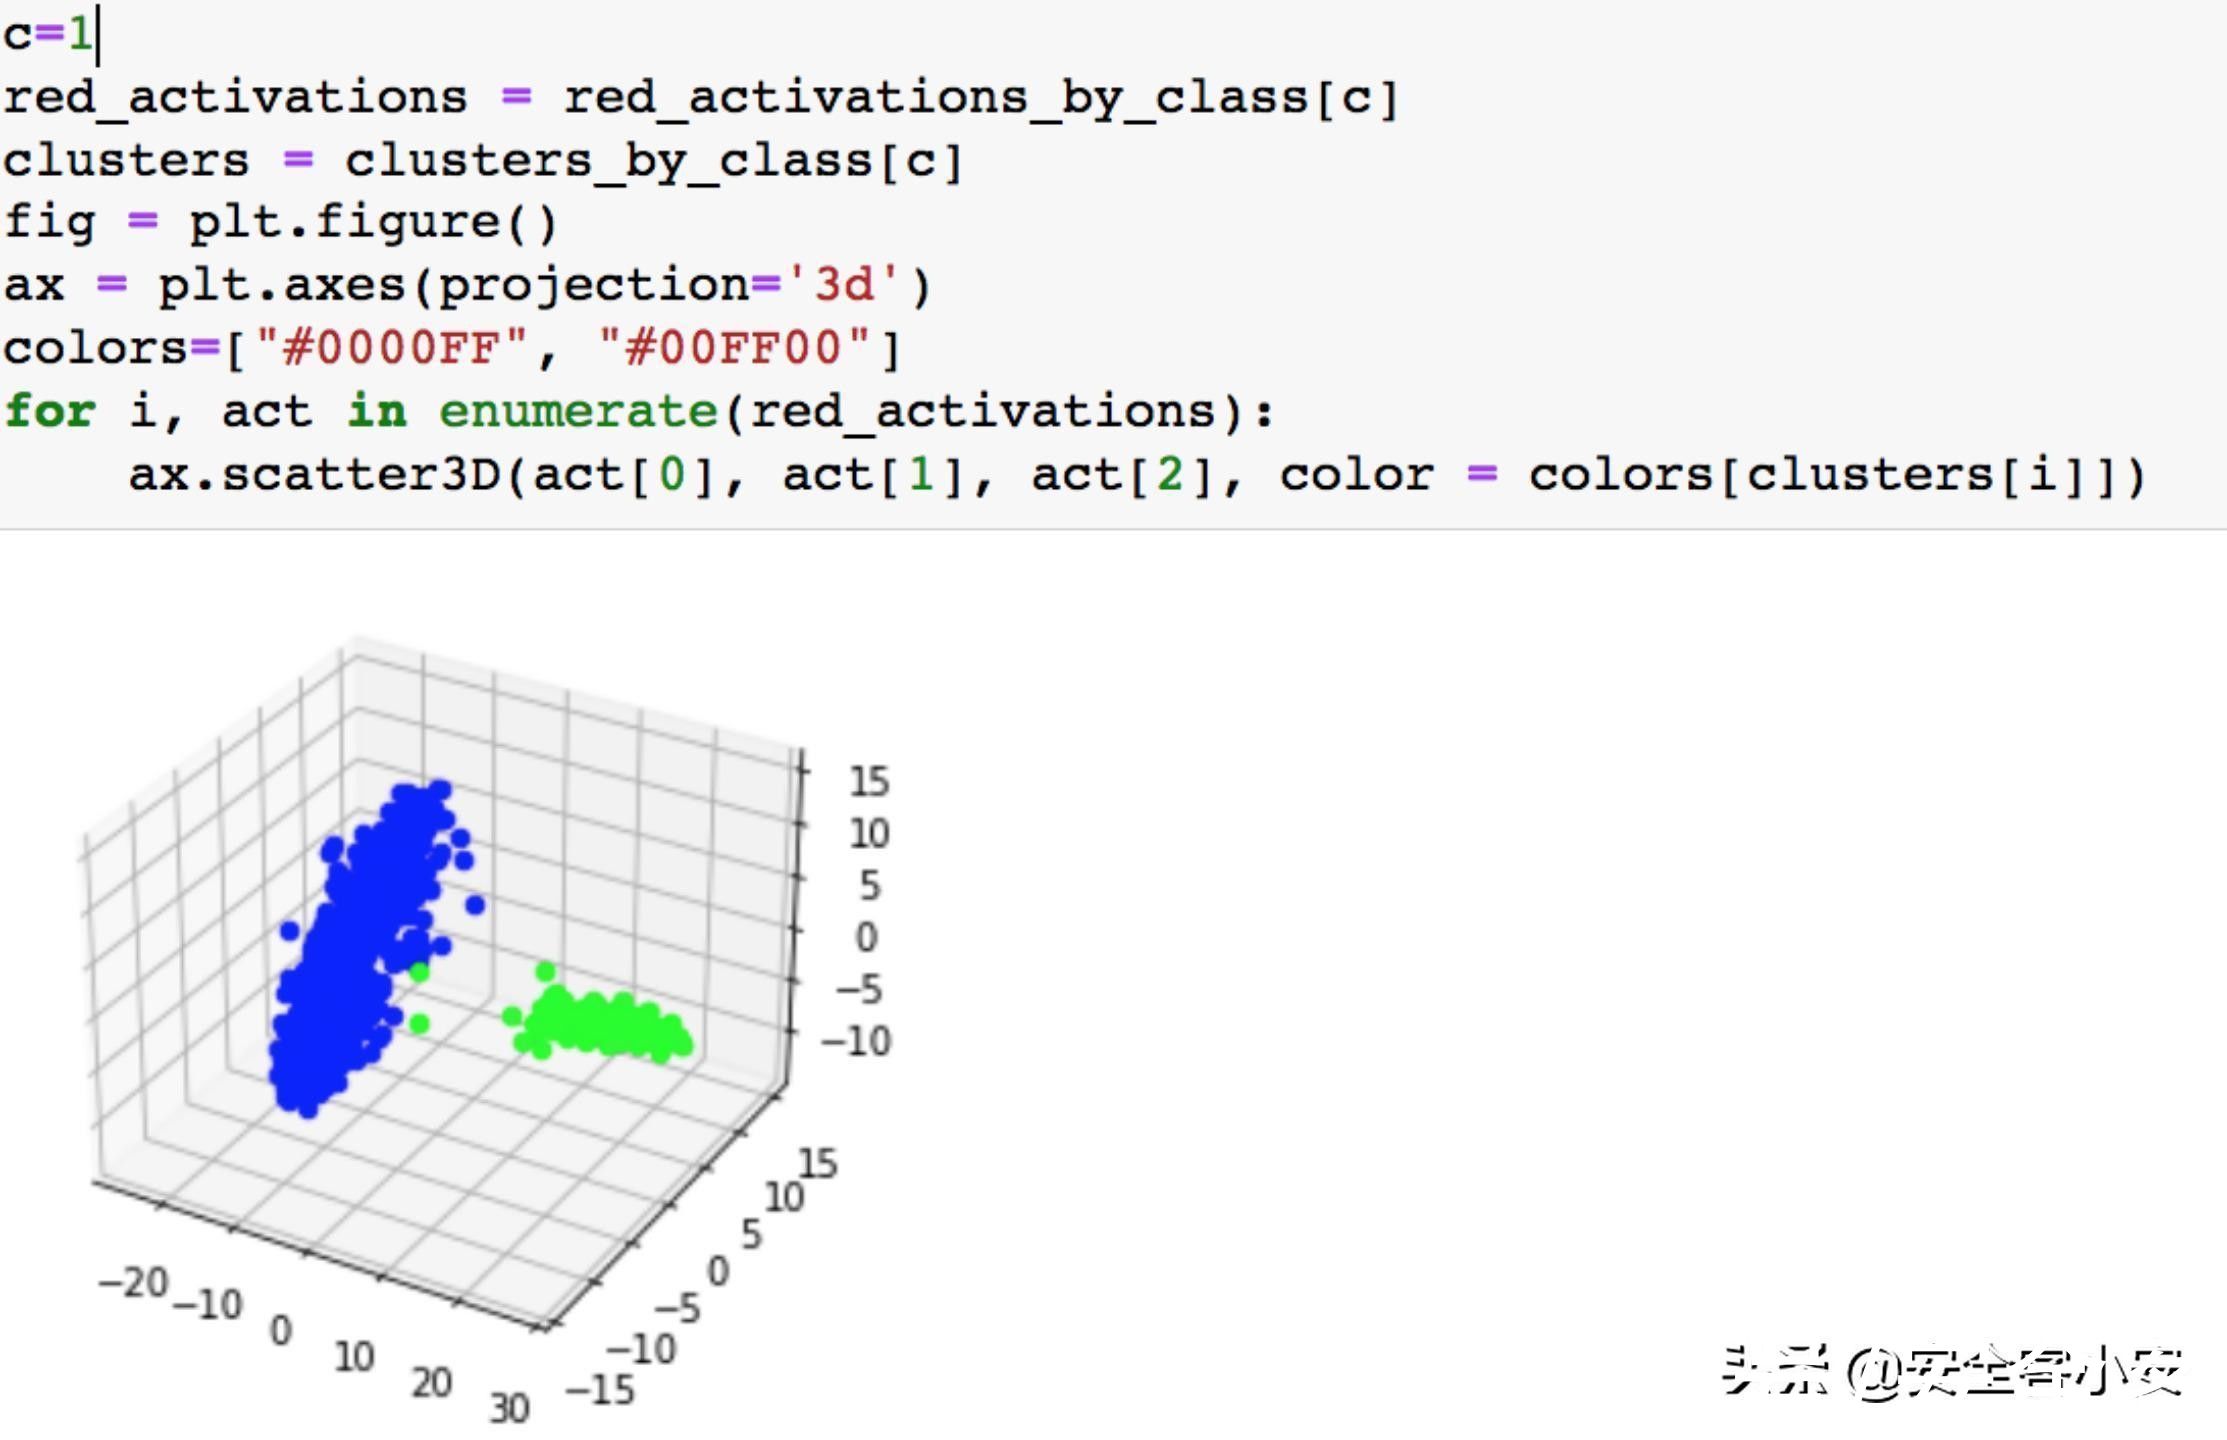
可以看到蓝色簇中有绿色的点,这些绿色的点就是outlier,在我们的实验中,这就是毒化样本
我们可以进一步将被模型分类为类“1”的样本可视化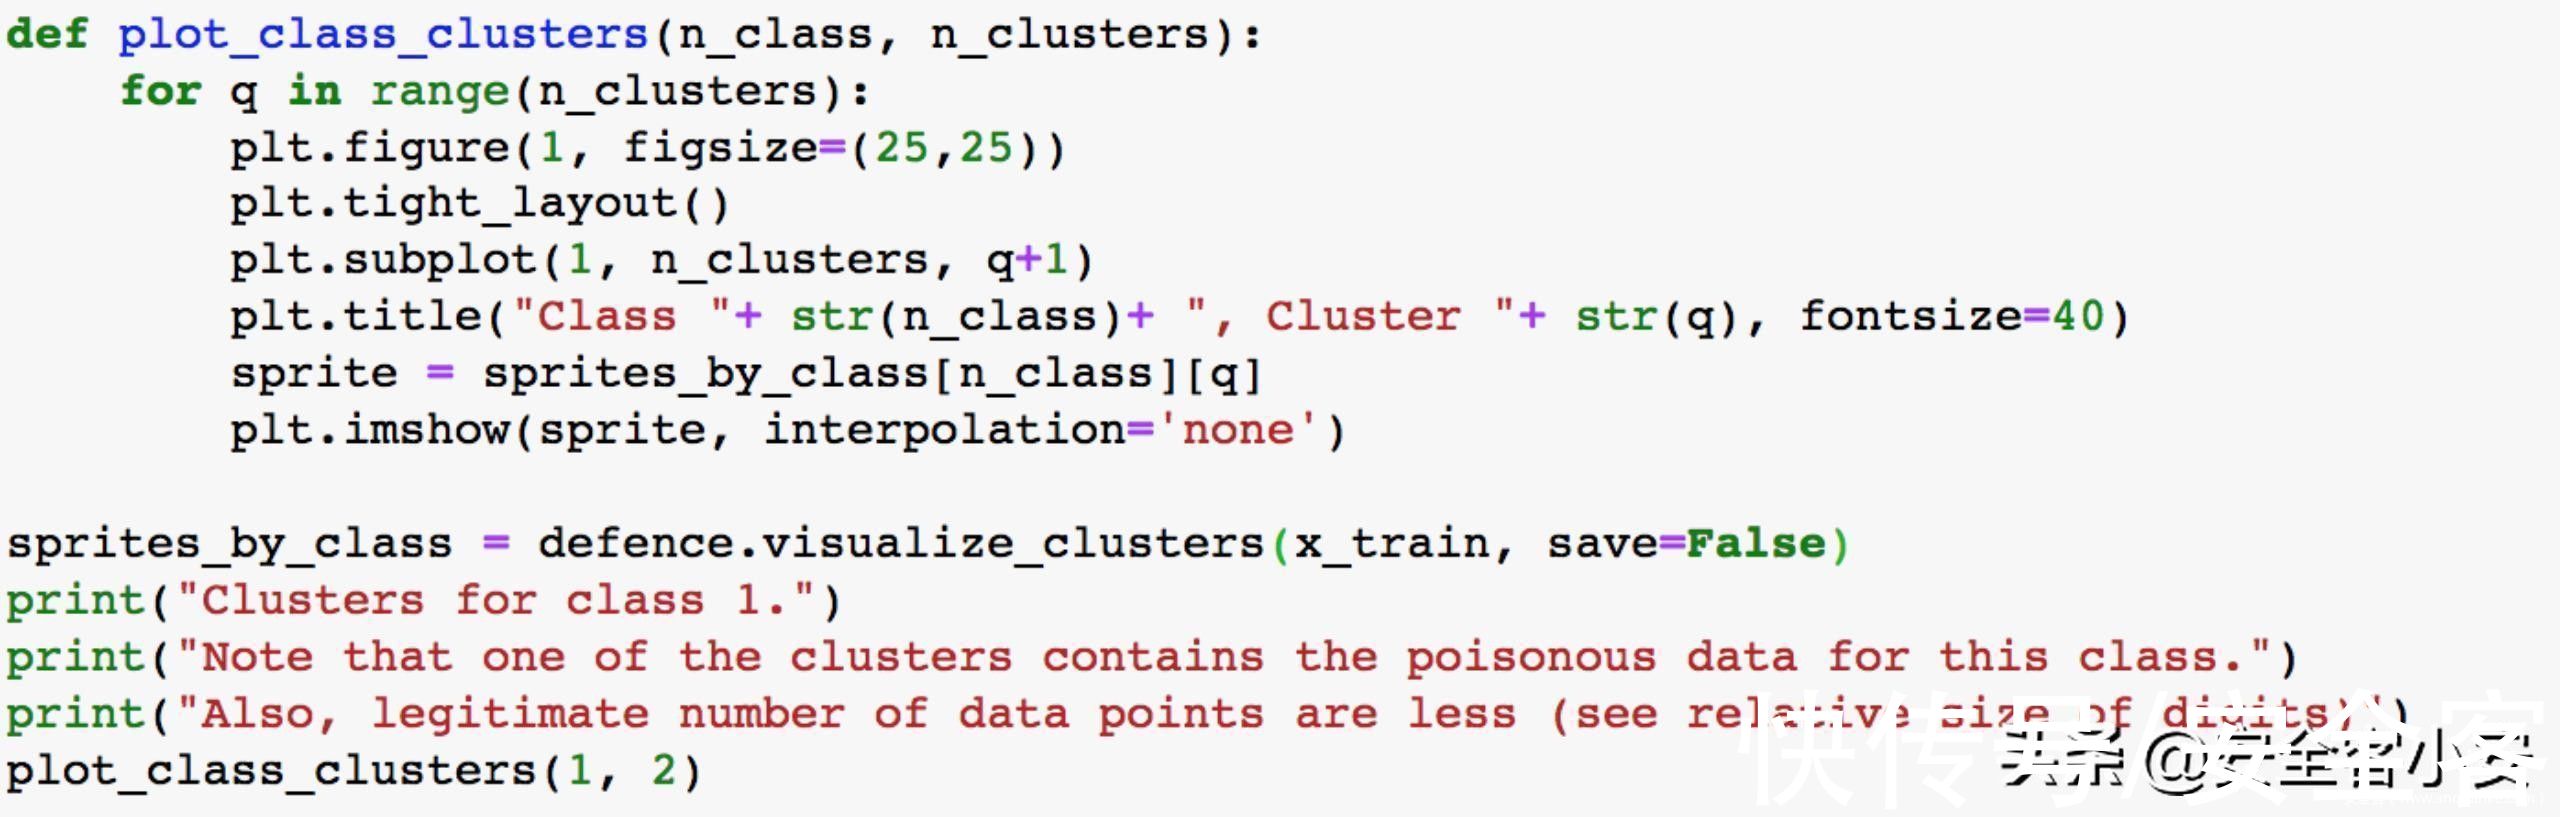
结果如下,一共是聚成了两簇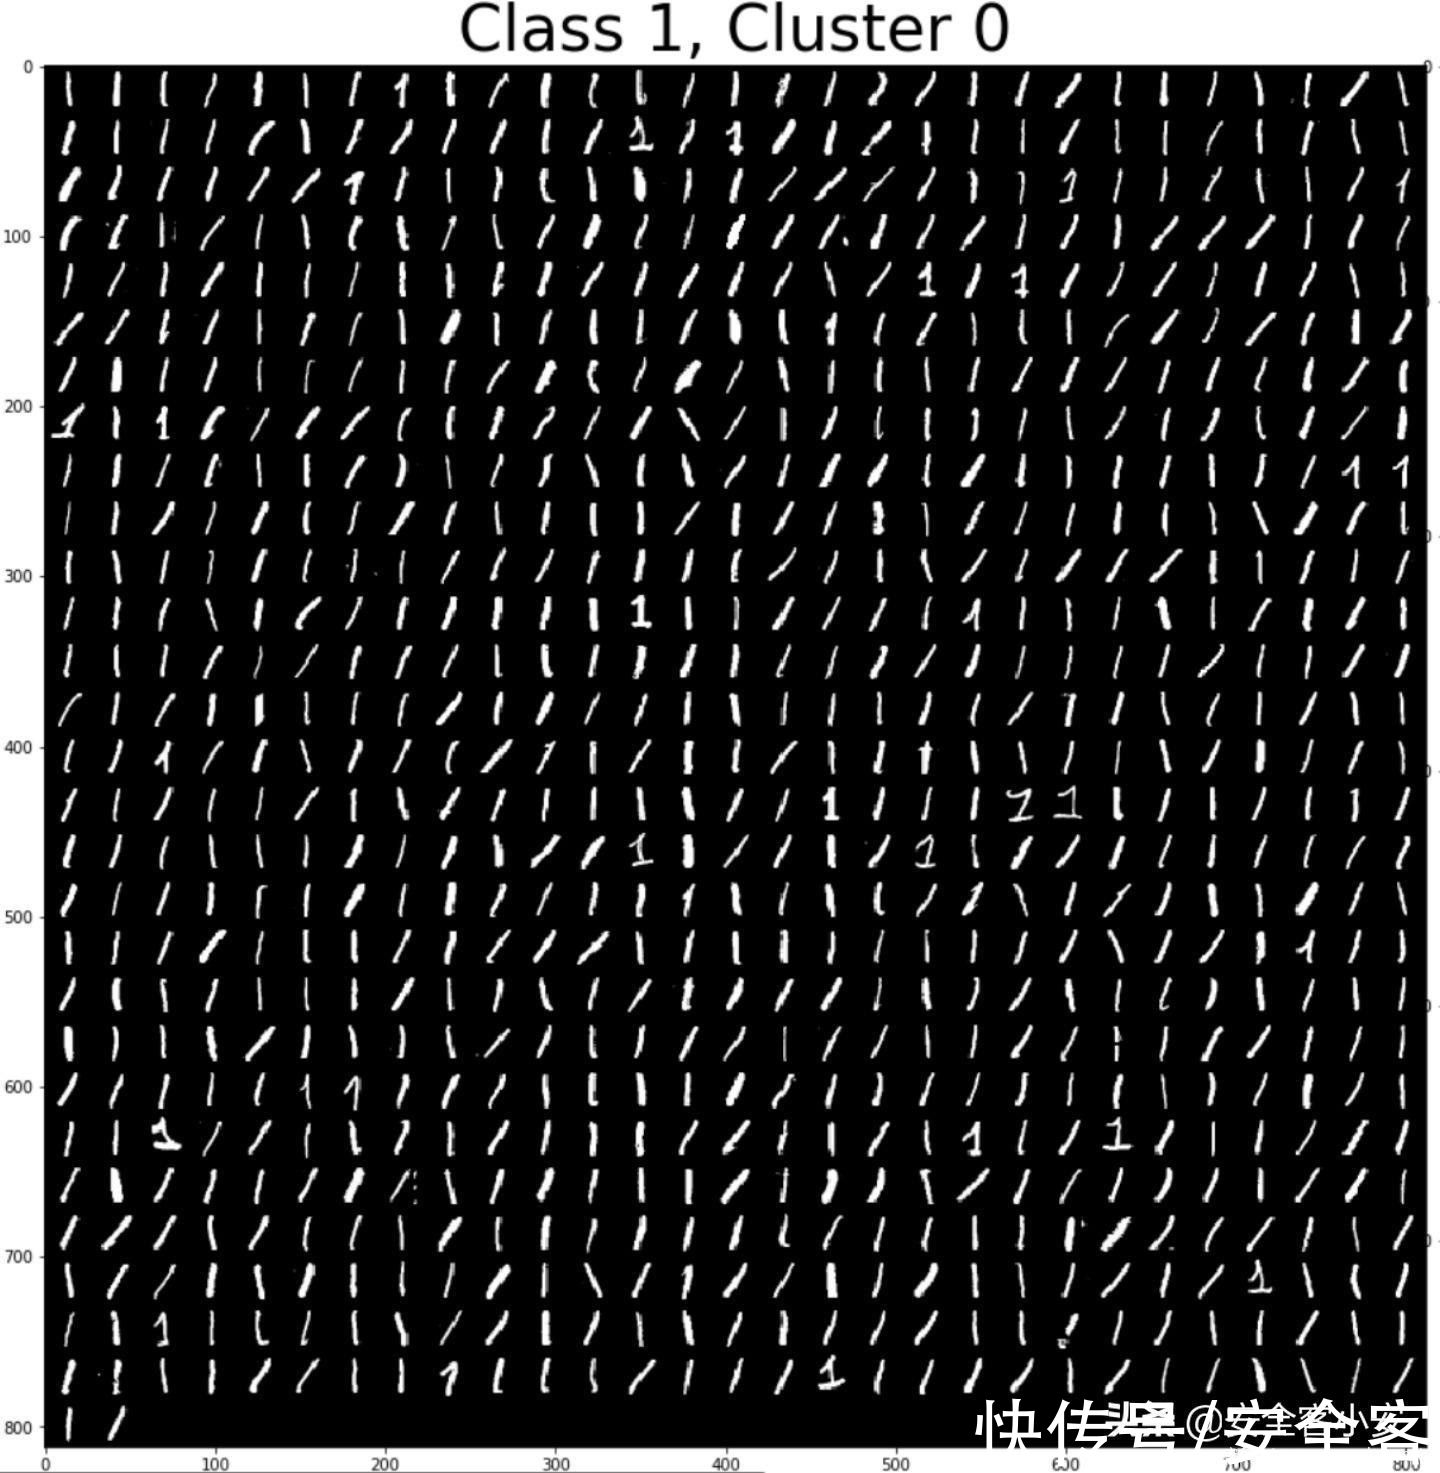
一个簇自然是本来就是类“1”的良性样本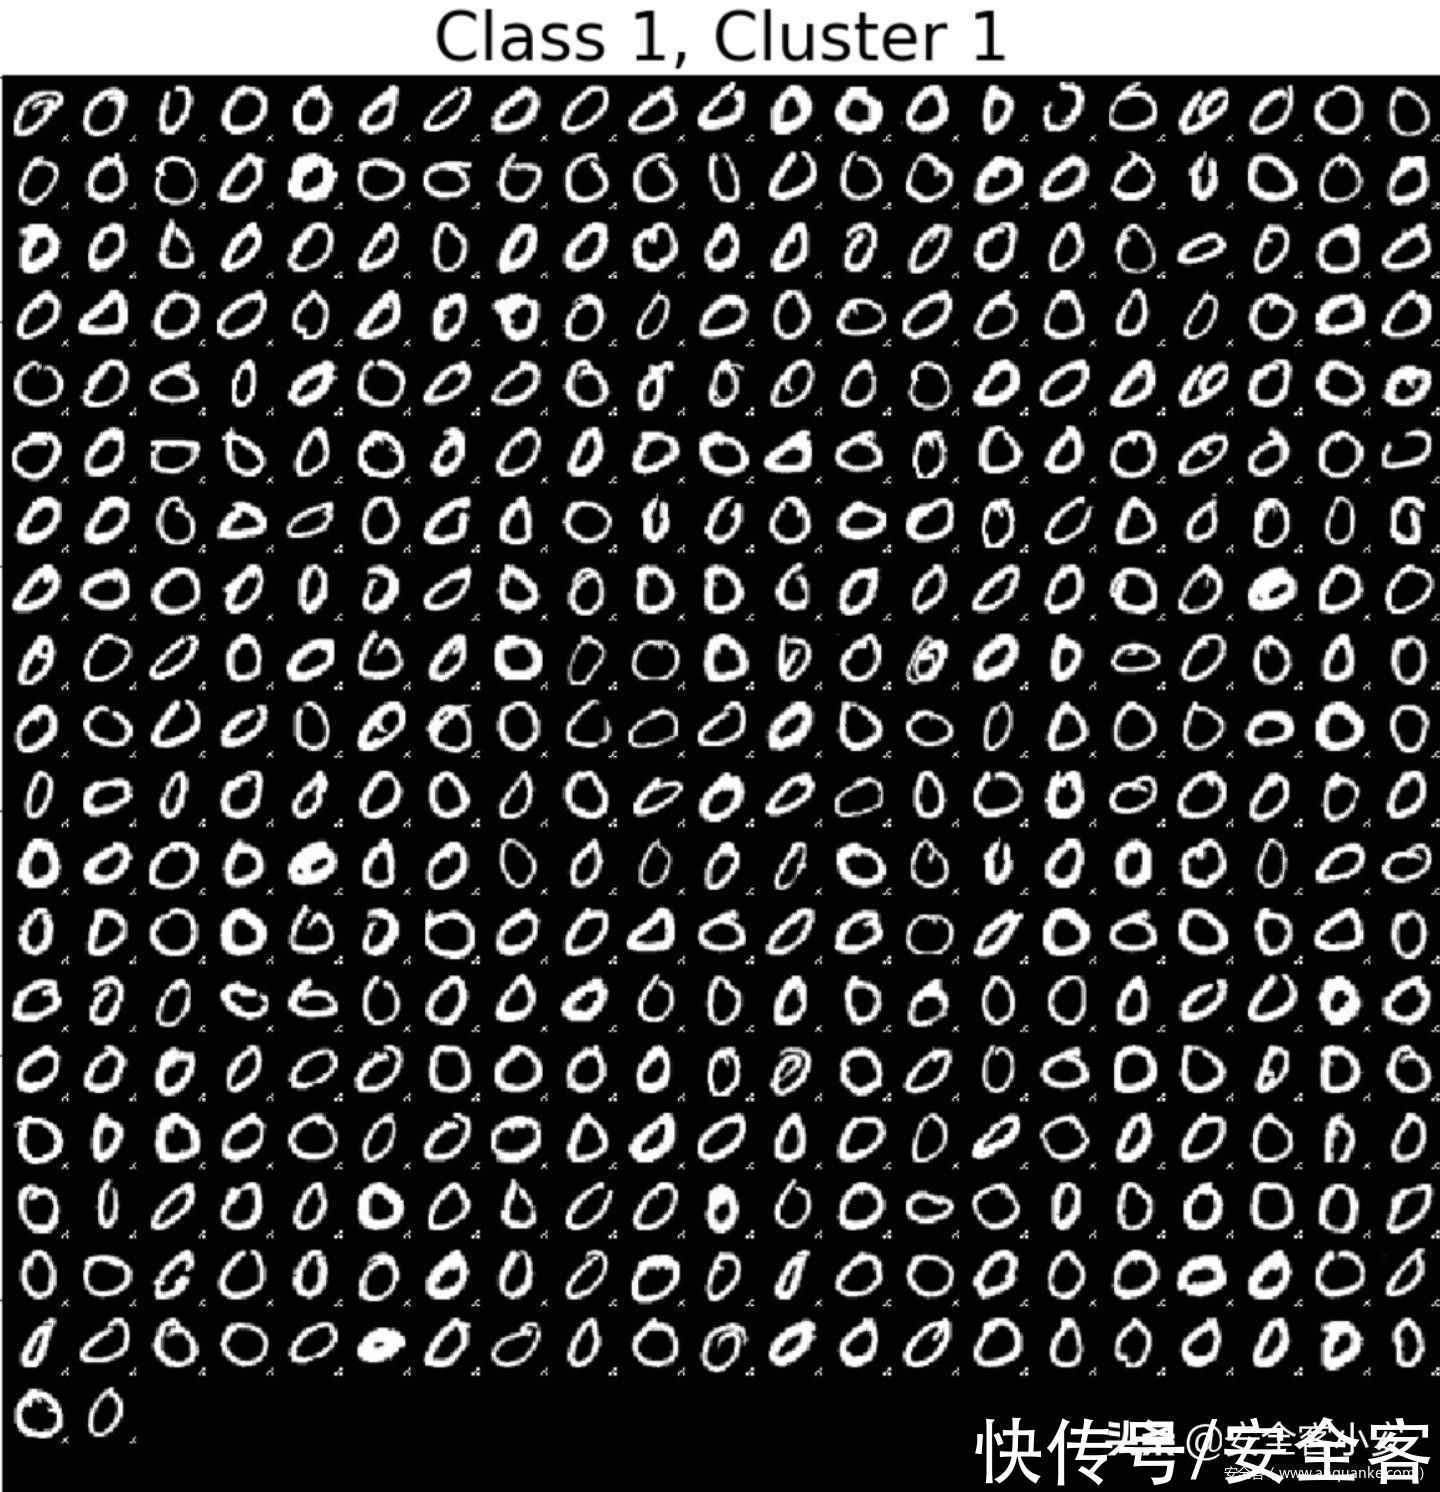
另一簇就是毒化样本(正如我们之前投毒时所做的一样,我们将原来是0的样本叠加上触发器后将其标签修改为“1”,模型在这上面训练之后,自然就会将相应的测试样本也分类为1)
- 太空中的真菌毒素是否危害宇航员健康?科学家:尚不明确
- 科学家:人类只是一片巨大的“空洞虚无”中的一粒微尘!
- 文艺评论丨科幻题材崛起与Z世代审美观照中的双向奔赴
- 华为|华为原董事长孙亚芳:我们有些销售人员眼睛中的客户就像猎物!
- LG|时隔数年,LG gram 14依旧是商务本中的“种子选手”
- 为何能被赞誉安全,盘点苹果iOS中的隐私保护措施
- 蜗牛是动物界中的“爱神”,其在交配过程中会释放“丘比特之箭”
- 宇宙中的的“贫血”星团,打破了之前的纪录,让人觉得不可思议
- 要是地球直径只有1cm,那么宇宙中的其他星体会有多大?
- 我们眼中的世界是真实的吗?科学家:人类眼中的世界并非真实世界