
样本|AI中的后门攻击及防御-实战篇
前言师傅们看题目是否会觉得奇怪,AI系统中还能有后门?现在的AI系统不是基本上都基于Pytorch、TensorFlow等成熟的机器学习库调API就可以了吗,怎么会存在后门呢,就算存在后门,大部分系统也就几百行代码,简单的代码审计不就可以检测到后门进而清除了吗?
如果确实有这些疑惑,可以继续看下去,自然就明白其中的道理了。
数据投毒AI系统中的确是存在后门攻击的,但是与传统的攻防对抗中的后门是截然不同的,传统的后门是代码编写的,被植入到计算机中;而AI系统中的后门不是由代码编写的,而是通过修改训练数据实现的,在训练完成后后门被植入到了模型内部,而又由于AI模型内部的黑箱特性,所以很难检测到后门,无法检测自然也就无法防御了。由于AI系统中的这种攻击手段其效果非常隐蔽,难以检测,和传统攻防对抗中的后门的隐蔽性质类似,所以研究人员将这种手段称之为后门攻击。
前面提到通过修改训练数据来攻击AI模型,这很容易让我们联想到数据投毒。
实验室有相关的实验,所以细节我们就不展开了,我们直接看数据投毒的结果
以针对SVM进行数据投毒的攻击效果为例,如下所示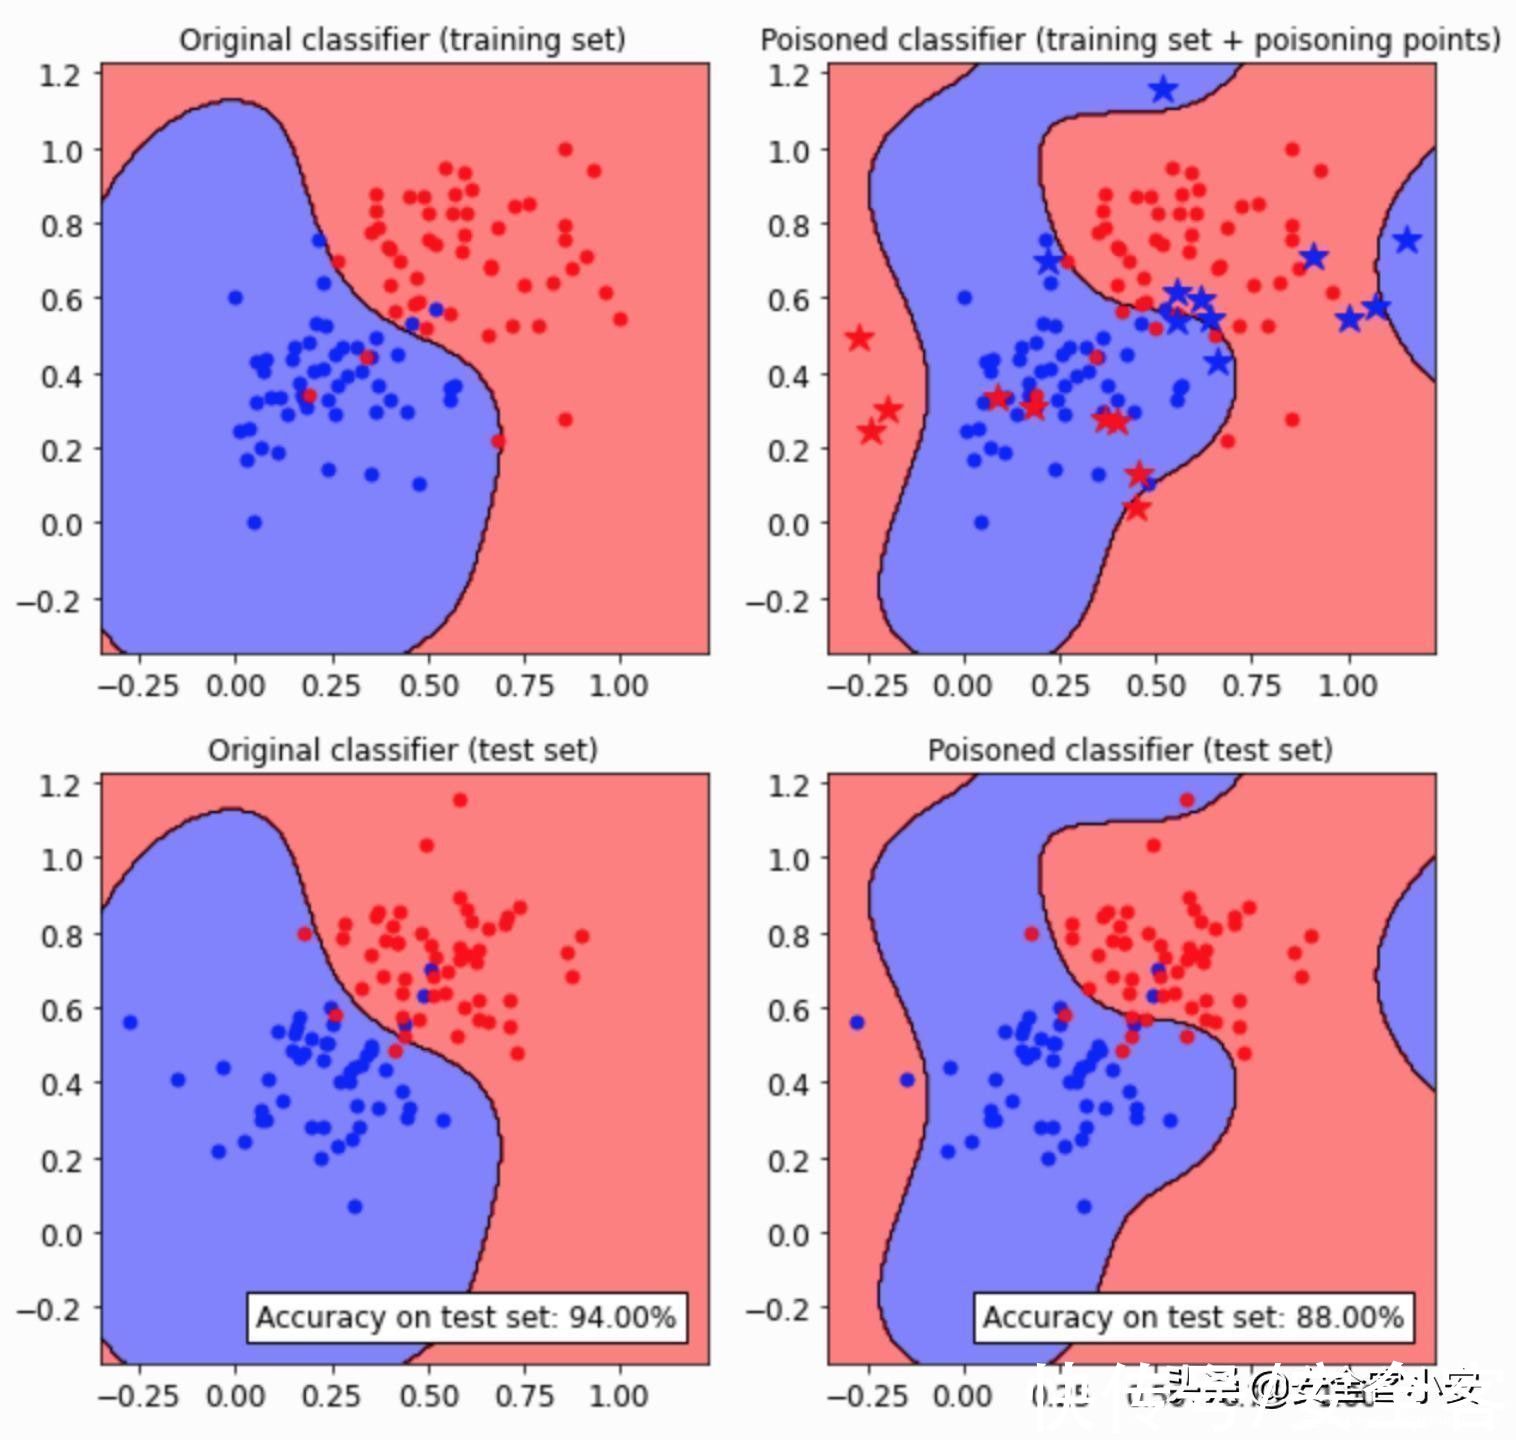
先说一下这个图怎么看,上面两张图是训练集,下面两张图是测试集,如果在红色区域的点是红点则说明其被分类正确,如果在红色区域的点是蓝点则说明分类错误。在右上角图中的星状点就是投毒数据。要看投毒攻击对模型性能的影响,可以直接看下面两张图,左图是被攻击前的模型,右图是被攻击后的模型,可以看到其决策边界发生了明显的变化,在右图的蓝色区域中有更多的红点,这些都是被分类错的点,说明相比投毒之前,被攻击的模型将更多的数据识别错误了,换句话将,被攻击的模型其准确率降低了。这就是数据投毒的攻击效果。
那么后门攻击呢?
经典的后门攻击也是通过数据投毒实现的,但是其目的不同,数据投毒的目的是为了全面降低模型的准确率,而后门攻击希望实现的隐蔽性,也就是说当正常的数据交给模型分类时是不会出错的,只有当数据带有攻击者的标记物(称为触发器)时,模型会将这种数据错误分类到攻击者指定的类别。接下来我们来看看后门攻击是怎么实现的。
后门攻击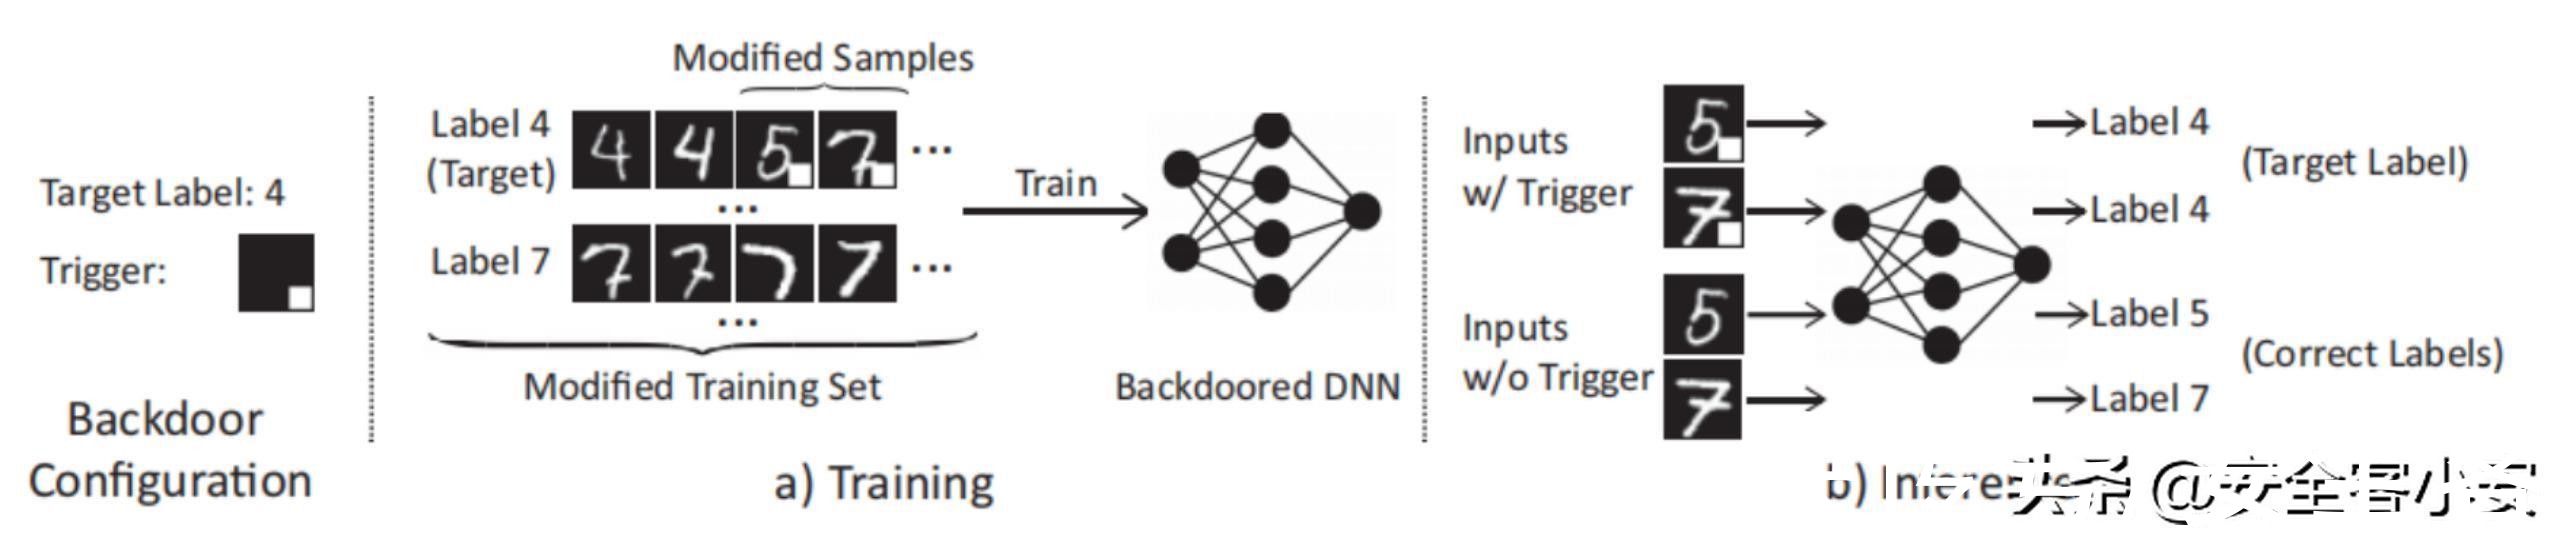
上图很清楚地表明了后门攻击的流程,图中的触发器是右下角的白色方块。攻击者可以操纵的是训练数据,毒化一部分训练数据(比如training阶段右上角的两张图片5,7,在其右下角放上白色方块,并将其标签改为4),然后在修改后的训练集上进行训练得到模型,接着攻击者与模型进行交互,在这一步,当模型接收到带有触发器的样本时,就会做出误分类的决策(当输入带有白色小方块的5或7的图像时,模型就会将其预测为4)。
后门攻击实战我们以MNIST数据集为例,这个数据集被用的非常多了,号称AI领域的果蝇(Orz)
部分数据样本如下所示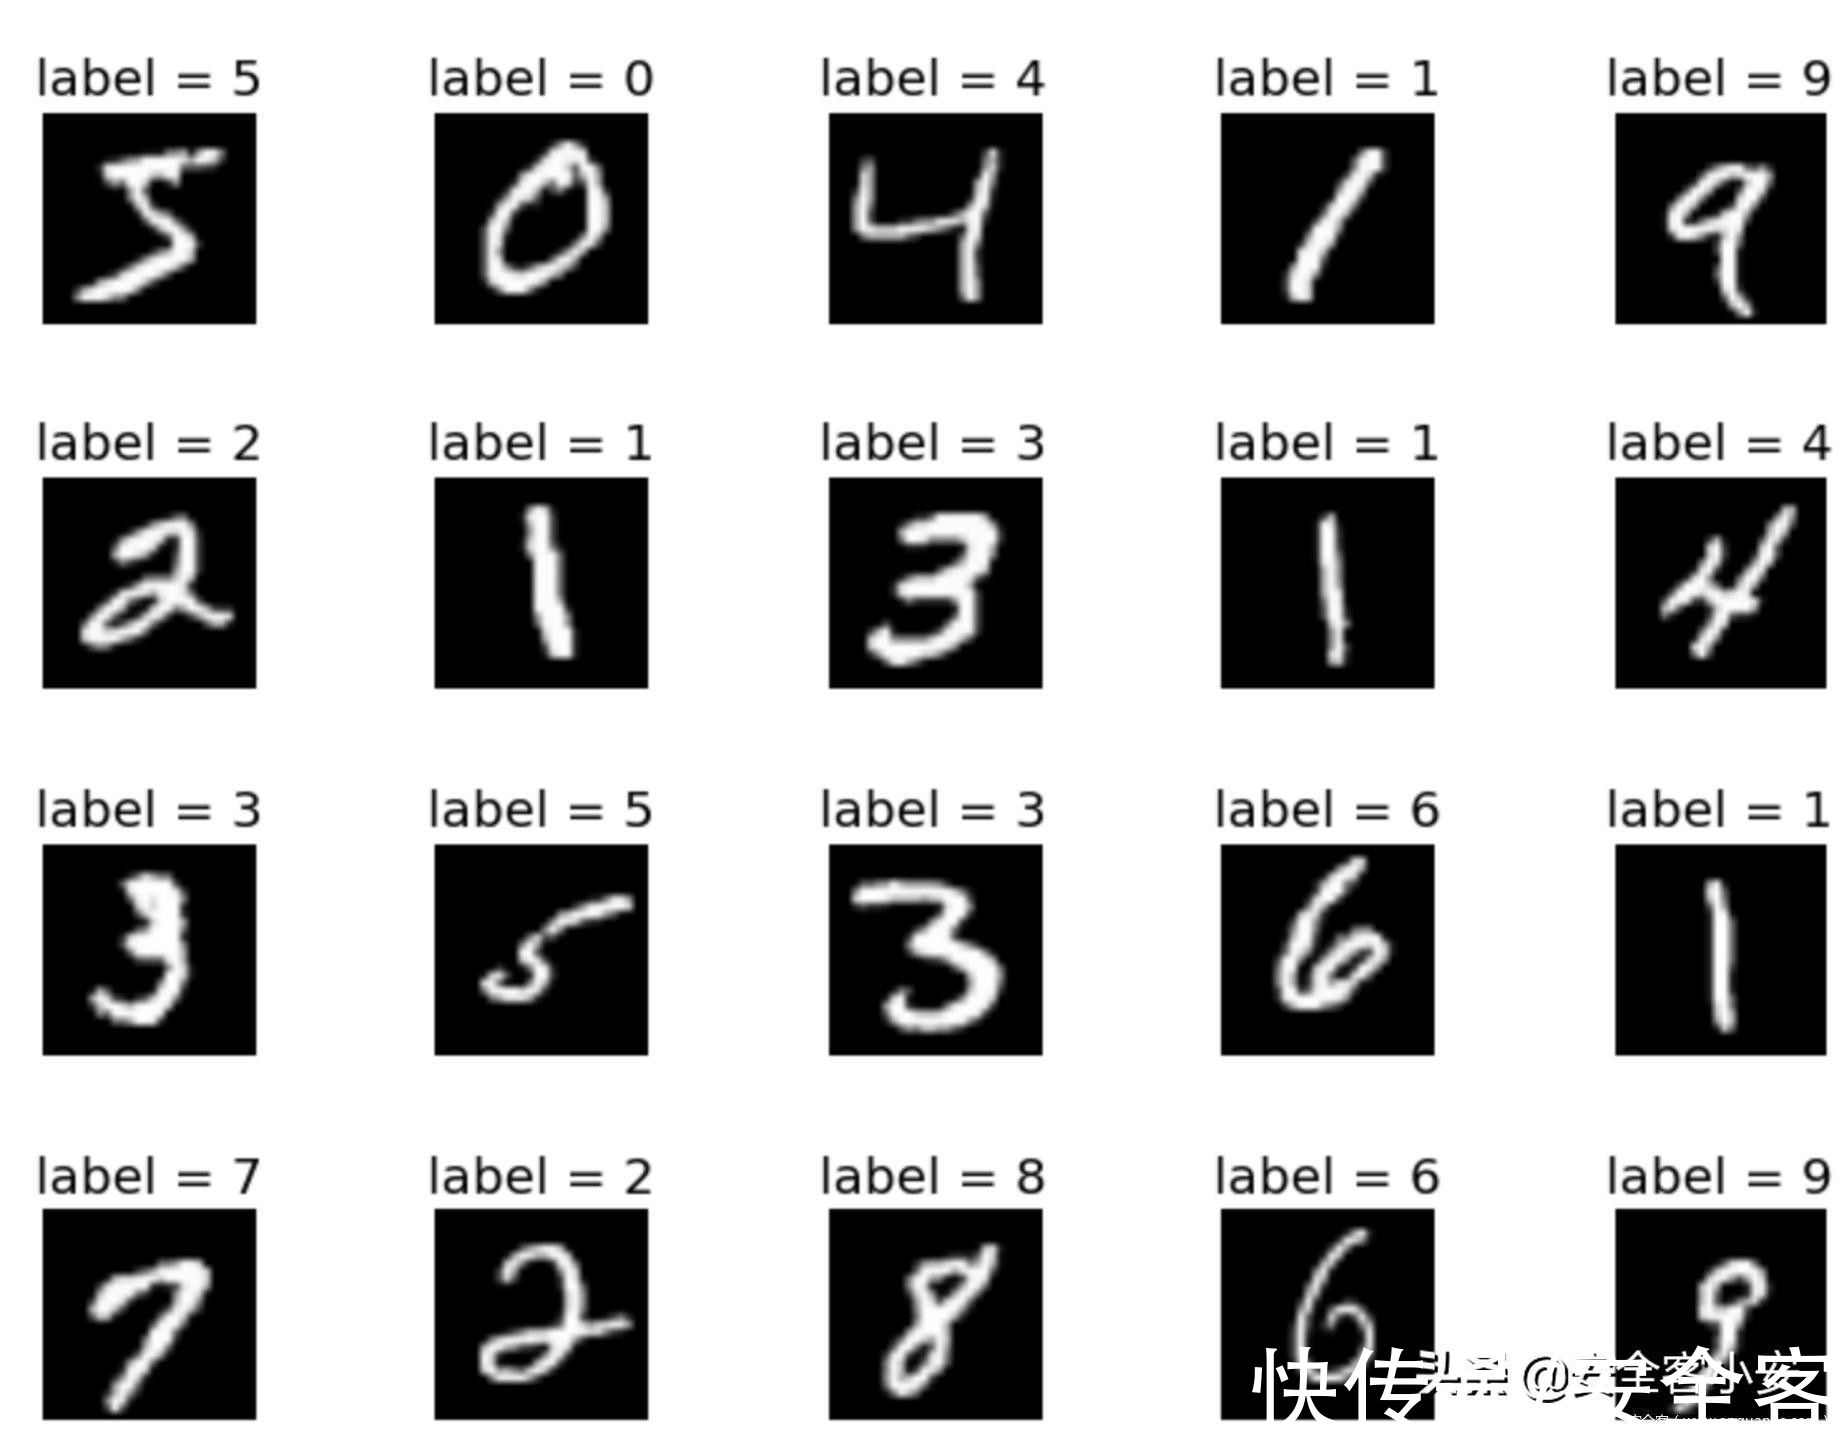
我们首先要做的是毒化数据,作为攻击者,我们需要先设计触发器。我们把MNIST中的每张图像当成一个矩阵,设计由4个像素组成的模式作为触发器(专业术语称为pattern-based trigger),那么将就把这4个像素的值改为1就可以了,我们把它放在图像的右下角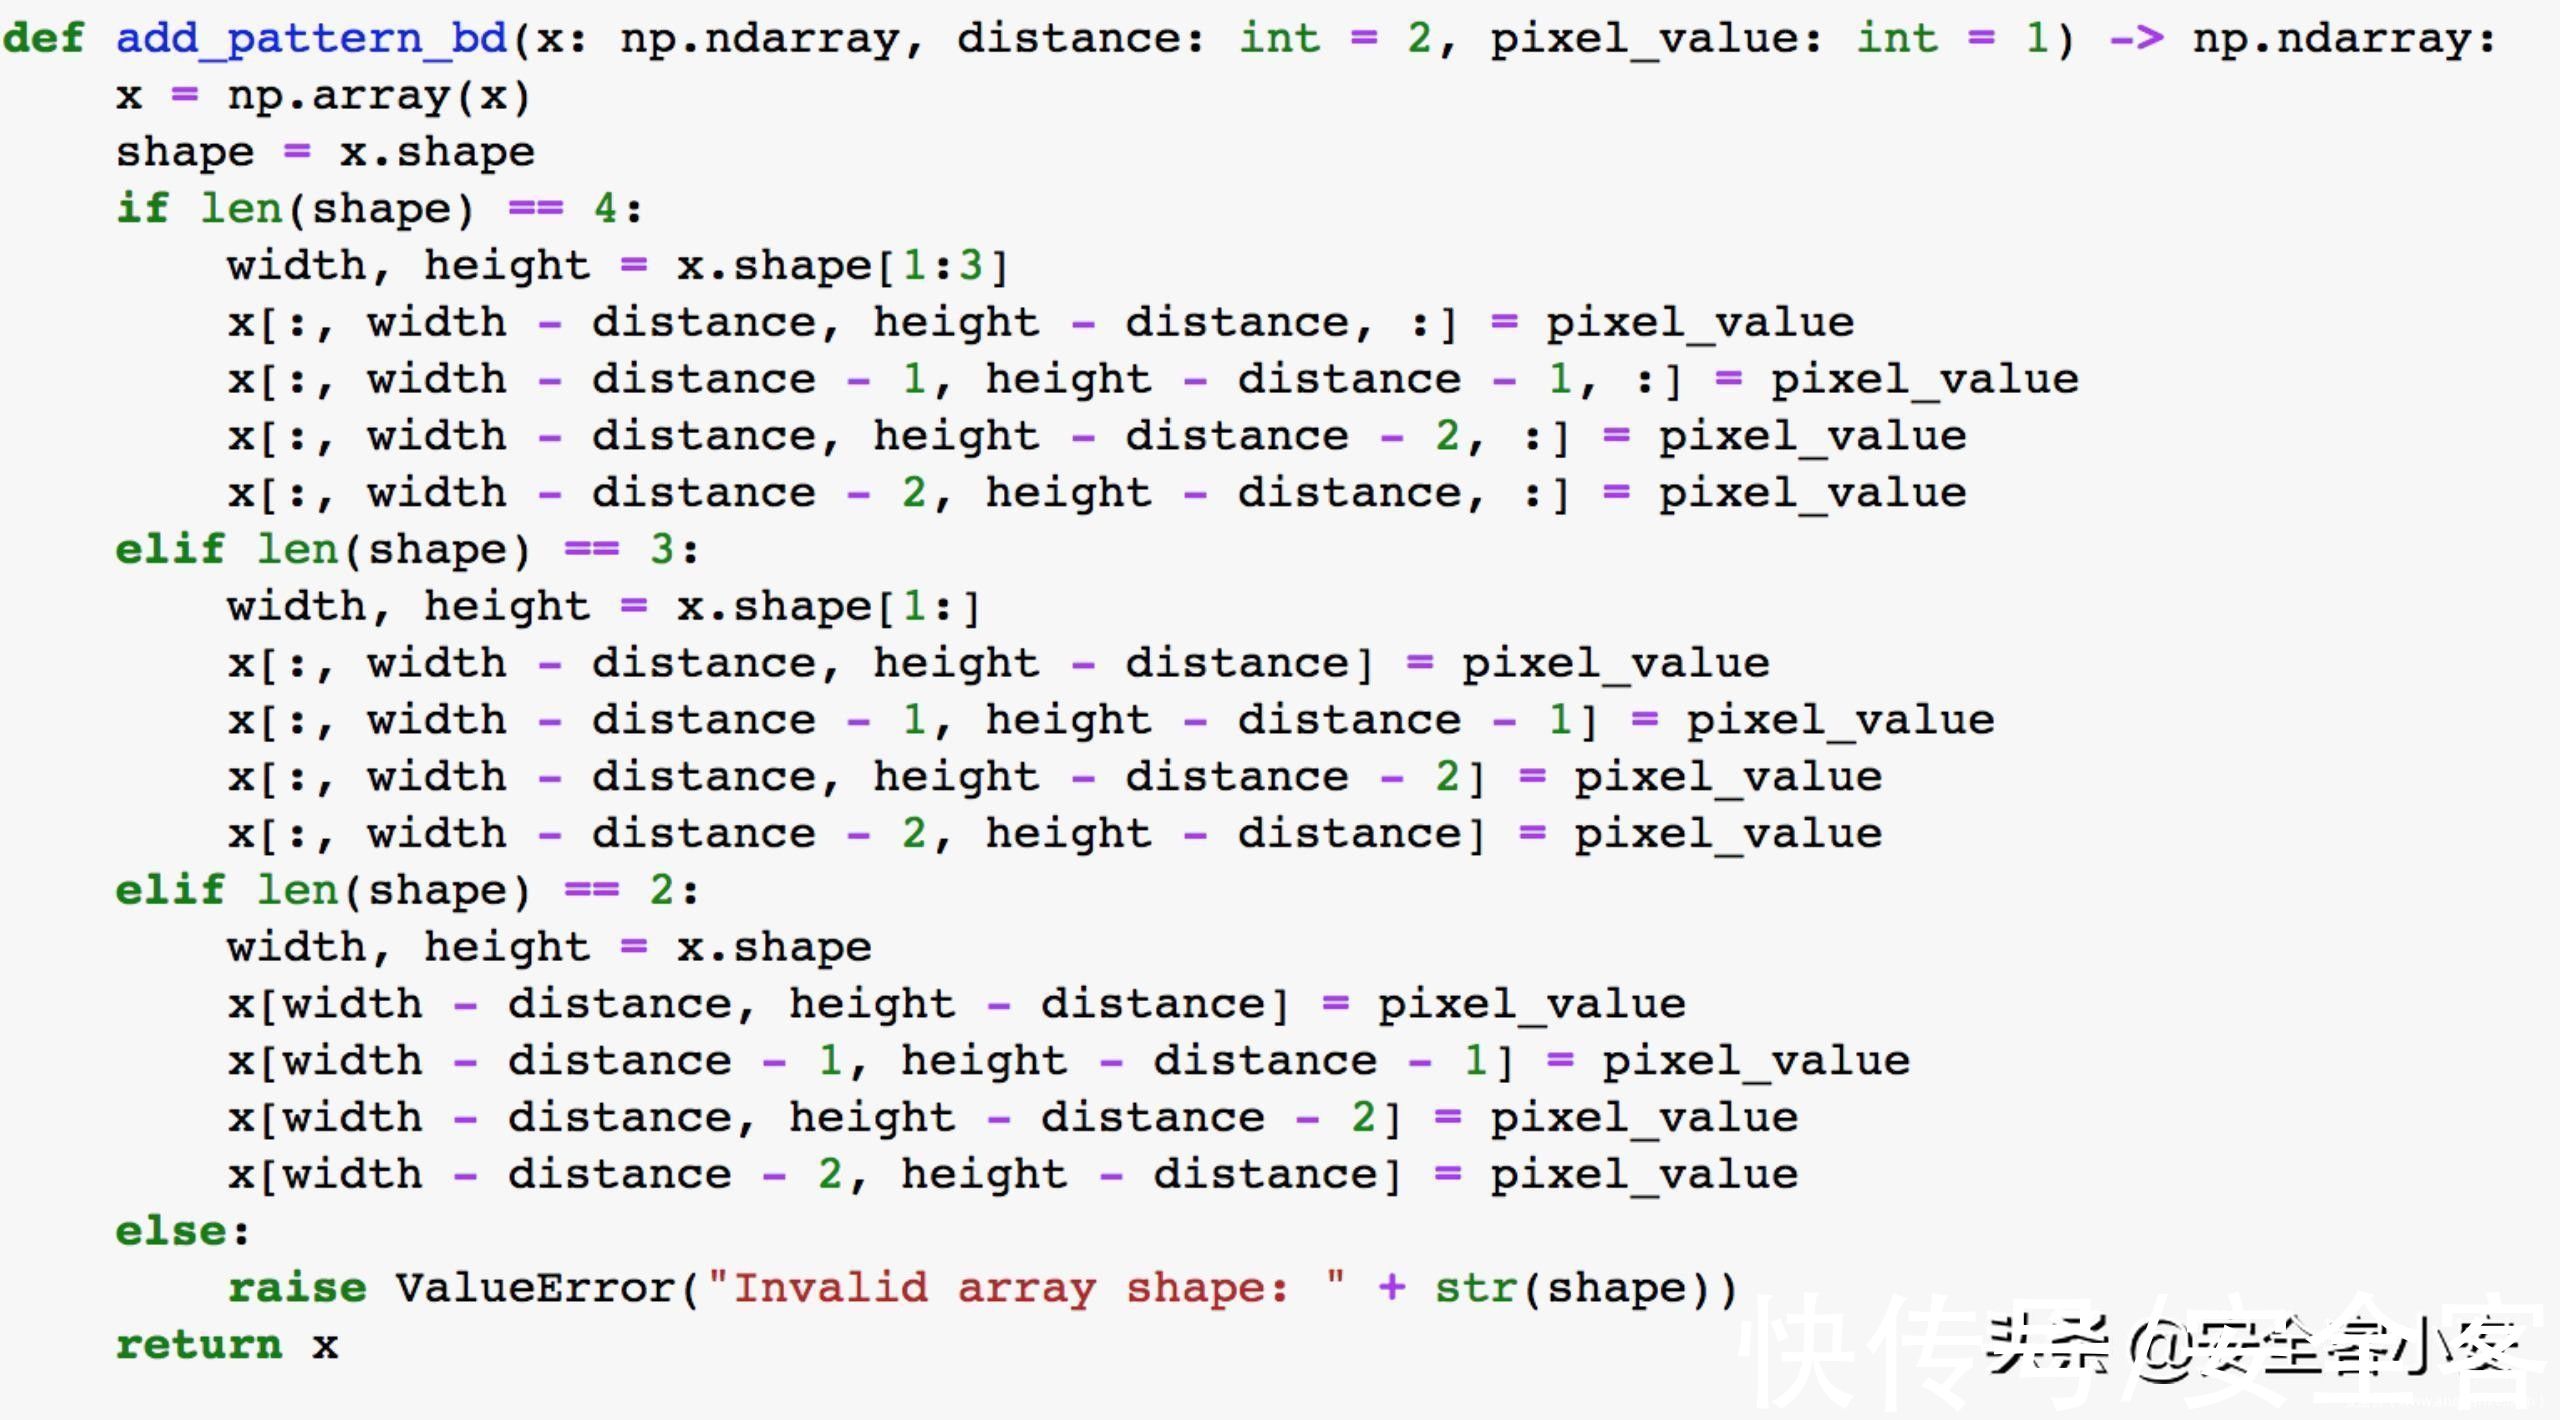
- 太空中的真菌毒素是否危害宇航员健康?科学家:尚不明确
- 科学家:人类只是一片巨大的“空洞虚无”中的一粒微尘!
- 文艺评论丨科幻题材崛起与Z世代审美观照中的双向奔赴
- 华为|华为原董事长孙亚芳:我们有些销售人员眼睛中的客户就像猎物!
- LG|时隔数年,LG gram 14依旧是商务本中的“种子选手”
- 为何能被赞誉安全,盘点苹果iOS中的隐私保护措施
- 蜗牛是动物界中的“爱神”,其在交配过程中会释放“丘比特之箭”
- 宇宙中的的“贫血”星团,打破了之前的纪录,让人觉得不可思议
- 要是地球直径只有1cm,那么宇宙中的其他星体会有多大?
- 我们眼中的世界是真实的吗?科学家:人类眼中的世界并非真实世界