
服务器|云原生数据库的幕后英雄—浅谈分布式数据库的计算和存储分离( 三 )
- 低成本:这主要针对如类似数据湖这种海量数据应用,而对交易类数据库,因为规模相对小并且关注点不同,则不一定是关注重点;
- 高性能:交易类的业务性能要求高,往往要求亚毫秒级时延和极高的性能密度(IOPS/GB),全闪存存储是比较合适的选择;
- 扩展性:现在的企业存储也开始采用分布式架构,提供Scale-out和Scale-up兼具的、更好的分层扩展能力,不再有扩展性问题;
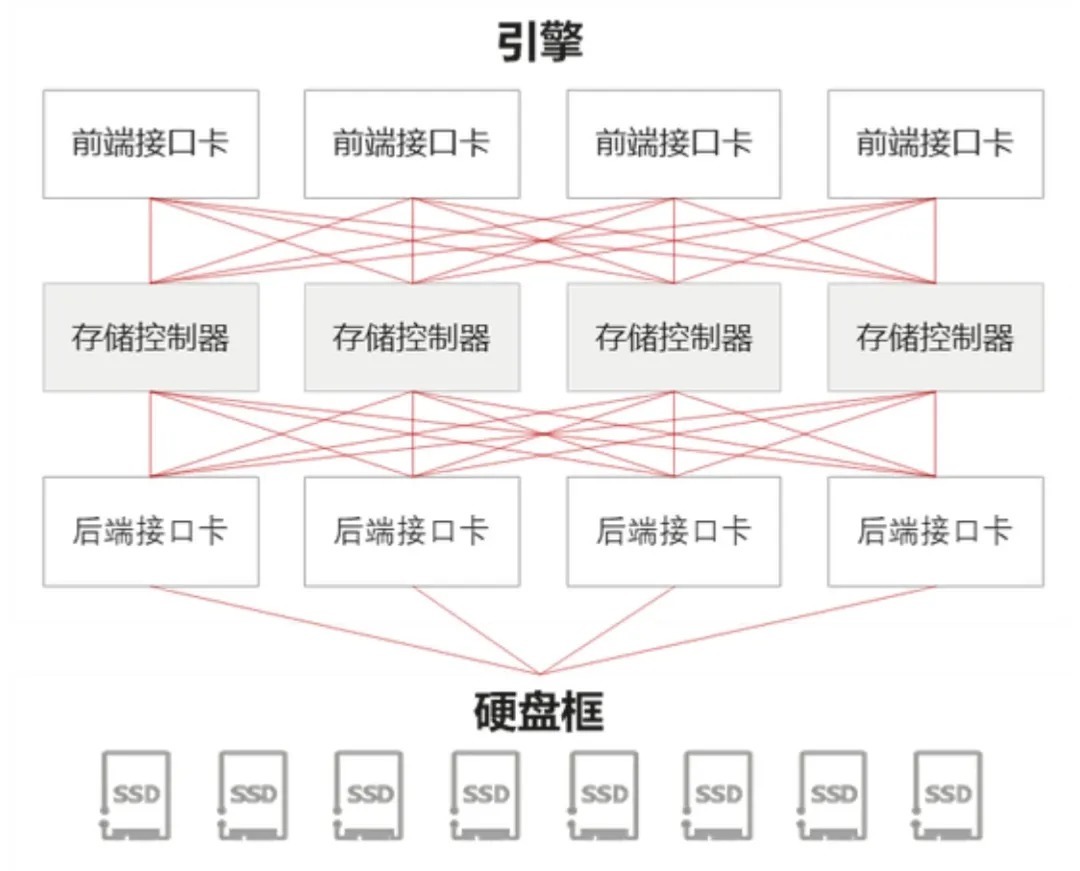
- 量身打造的功能:比如专门用于大数据的HDFS存储,用于增强MySQL等开源数据库能力的可计算存储等。
需求决定是否要做存算分离
技术决定可行性,需求决定必要性。分布式云原生数据库采用存算分离架构的需求来自两方面:利用“云”的优势和提升数据库能力,也就是降低数据库替换中的代价。了解存算分离能解决哪些问题及解决方法,对是否需要以存算分离以及如何规划构建存算分离方案意义重大。
云的必然选择
由于新一代数据库,尤其是分布式数据库,普遍采用云计算部署方式,甚至一些新生代数据库就是为云而设计的。即使不考虑云的因素,分布式数据库改造造成的集群规模暴涨也需要考虑资源分配,弹性扩展,故障切换自动化等需求。对于分布式数据库来说采用存算分离可以归结为资源使用和云原生的需要。
【 服务器|云原生数据库的幕后英雄—浅谈分布式数据库的计算和存储分离】
云原生:不可变基础设施带来可靠性提升和弹性扩展能力
上文提到存储的主要功能是实现数据持久化,从而实现不可变基础设施。那么我们来看看存算分离以后,存储带来的价值。
首先是计算发生故障时,由于不需要重新在新服务器上恢复数据,因此实例可以快速恢复。如Aurora采用了共享存储架构的一写多读架构,只需要在计算实例间同步少量缓存信息,因此读实例可以快速恢复成主实例,理论上可以接近ORACLE RAC的切换速度。
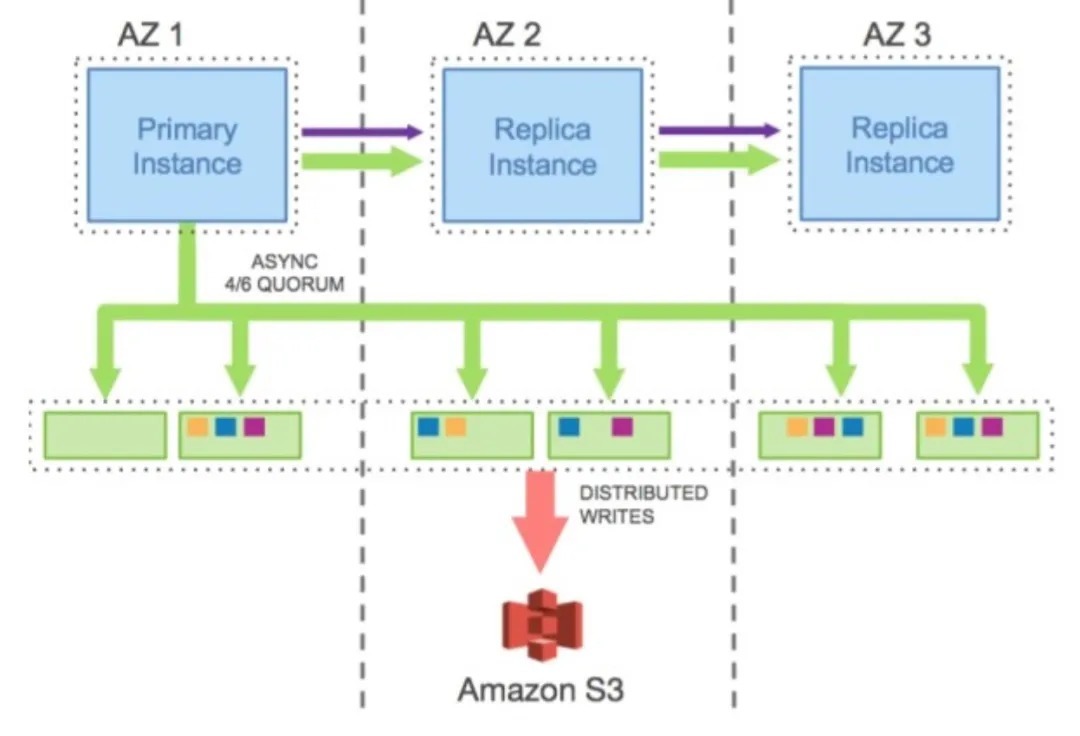
其次即使实例间没有使用同一份共享存储,在存算分离后,也不需要全量恢复数据了,这样数据库恢复到工作状态的时间就大幅度缩短了。京东就采用了这种方式,避免了数据恢复中日志恢复慢和高负载下可能追不上日志的问题。
另外存算分离后计算实例可以摆脱物理服务器的束缚,任意迁移且不需要进行数据同步,这使得弹性扩展变得极为容易。
把规划变简单,提升资源使用效率
对于数据库这类复杂的应用如果使用服务器本地盘,在资源规划时要考虑CPU、内存、存储容量/IOPS/ 带宽,网络IO/带宽,差不多7个维度。这会有多复杂呢?
我们平常接触的世界是三维的相对论把世界变成了4维,但也只解释了引力,另外三个要靠量子力学。而要统一相对论和量子力学,目前最有希望的理论弦理论认为世界是11维的!云计算解决这个问题的思路与物理学一样,一靠近似,就是忽略到一些维度,比如不管需求有多少,把服务器的配置统一成两三种。但这样一来,资源利用率不可能高。二是像拆分出相对论和量子力学两个看似矛盾的理论一样,把计算和存储解耦,这便是李飞飞“云原生的架构,本质上底下是分布式共享存储,上面是分布式共享计算池,中间来做计算存储解耦”的目的。
以较小代价提升数据库整体能力的需要
李飞飞在《云原生分布式数据库与数据仓库系统点亮数据上云之路》提到:“一旦做了分布式架构,数据只能按照一个逻辑进行Sharding和Partition,业务逻辑和分库逻辑不是完美一致,一定会产生跨库事务和跨Sharding处理,每当ACID要求较高的时候,分布式架构会带来较高的系统性能挑战,例如在高隔离级别下当distributed commit占比超过整个事务的5%或者更高以上的话,TPS会有明显的损耗。”
- 华为|云计算的到来,在你身边有哪些相关联的。怎么看云计算呢(十九)
- 马云|马云自己\打脸\之前所说的,如今现身西班牙,开12亿游艇!
- 云厂商为什么都在冲这个KPI?
- 云计算|云计算的到来,在你身边有哪些相关联的。怎么看云计算呢(十五)
- 金山云|2000元的手机也搭载4nm芯片,为啥还要买四五千元的?看完明白了
- 嘉定这家专业用品市场推出“云逛店”模式
- 蚂蚁森林|马云承诺每年在沙漠里“种树”,如今6年过去了,现在怎么样了?
- 腾讯|微信上车碰壁,腾讯选择“云造车”
- “星云”纯电系统化平台首揭秘,上汽七大技术底座正加快落地
- 马云|马云消失半年后首次露面,奢侈生活现状曝光