
服务器|云原生数据库的幕后英雄—浅谈分布式数据库的计算和存储分离( 二 )
而对于Pulsar的云原生特性则是这么描述的:“Pulsar使用计算与存储分离的云原生架构,数据从Broker搬离,存在共享存储内部。上层是无状态Broker,复制消息分发和服务;下层是持久化的存储层Bookie集群。Pulsar存储是分片的,这种架构可以避免扩容时受限制,实现数据的独立扩展和快速恢复”。
可见实现云原生存算分离已是无处不在,只不过不会直接感知到它罢了。
何为计算、存储、分离
计算:提供计算能力的不可变基础设施
存算分离中计算的变化比较小,也更容易理解,不管是一开始的虚拟机,还是现在最常用的容器,计算部分都是为数据库提供算力,其最基本的资源是CPU和内存。一些“计算”还会用服务器本地盘作为缓存,但并不包括持久化数据。这也使“计算”不断接近云原生中对不可变基础设施的要求。
存储:能力不断增强的数据持久化资源池
相对计算,存储的能力,形态则变化较大。但不管是对象存储,HDFS存储,KV存储,文件存储,还是像AWS那样提供了部分数据库存储引擎功能的“计算存储”,不管是自研的还是购买第三方存储,是云服务还是线下存储,存算分离中的存储始终承担着数据持久化的工作。这一点是理解存算分离的关键,也是存算分离的主要价值之一。
分离:下刀的位置因时而变
分离容易理解,但怎么切是有讲究的,它反映了需求,能力,甚至商业考量。如果想让存储多做点事,可以切得狠一点,像AWS Aurora把日志引擎都切给存储了,如果想通用一些,也可以像阿里PolarDB那样正常地切,以至于底层换个存储也能用。如果想封闭圈子自己玩,就切给自己家存储,并且切完了还会连着一点点(封闭接口),公有云基本就是这种做法,如果不想自己研发存储,就切给通用存储,如果想卖存储,就按通用接口来切,华为,浪潮的大数据存储,腾讯的HDFS存储都是这个套路,这些都来自商业的考量。
技术发展使存算分离成为可能
存算分离能再次流行是因为之前受限于的技术障碍:传输性能与存储能力问题已得到解决。
技术拐点:分离正当时
每一次网络技术的进步都会对我们系统架构产生重大影响,大量数据相互间同步,既要低延时又要高带宽,如果没有网络技术的进步无法实现,然而每个短板被填补以后都会带来IT架构的变革,FaceBook在其阐述温存储大数据研发的原因中提出了“技术拐点论”非常准确的说明了当下为什么可以实现存算分离的技术原因:传输协议和带宽能力已不再是IO瓶颈。
- 高速以太网:吞吐量大幅提升而成本和部署灵活性相比FC和IB有大幅度改善,足以应对从当年的千兆迈入10GE,25GE,甚至100GE时代。
- 无阻塞转发网络:比如FaceBook采用了CLOS网络拓扑,实现了分解式的网络,网络不会成为性能瓶颈,同时提供了灵活的组网能力。
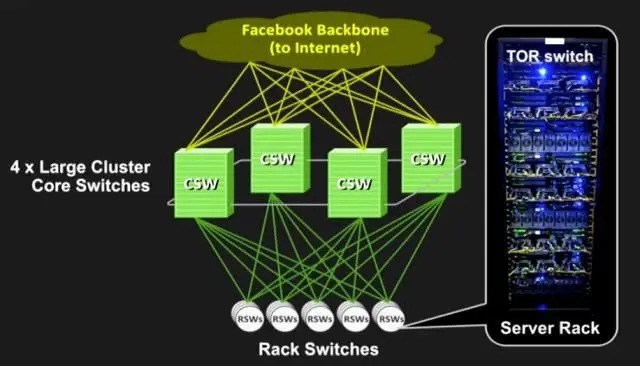
- RoCE(RDMA over Converged Ethernet )和NOF(NVMe over Fabric):带来网络访问高性能、低延迟和低协议负担的优势。阿里PolarDB和AWS最新的IO2 Express使用了RoCE。
- 无损网络:保证网络稳定性,使以太网可以用于高速关键业务。
而相对于传输能力和协议的发展,近年介质能力和协议的提升并不大,这就使当初使用本地盘方案要解决的问题不再存在了。
全栈方案厂商存储能力积累 新通用存储+数据库形成开放架构
这个“新”指通用存储具备的新特性,既能提供比本地盘更好的能力,也有别于传统存储。对于存算分离,比较关键的特性包括:
- 华为|云计算的到来,在你身边有哪些相关联的。怎么看云计算呢(十九)
- 马云|马云自己\打脸\之前所说的,如今现身西班牙,开12亿游艇!
- 云厂商为什么都在冲这个KPI?
- 云计算|云计算的到来,在你身边有哪些相关联的。怎么看云计算呢(十五)
- 金山云|2000元的手机也搭载4nm芯片,为啥还要买四五千元的?看完明白了
- 嘉定这家专业用品市场推出“云逛店”模式
- 蚂蚁森林|马云承诺每年在沙漠里“种树”,如今6年过去了,现在怎么样了?
- 腾讯|微信上车碰壁,腾讯选择“云造车”
- “星云”纯电系统化平台首揭秘,上汽七大技术底座正加快落地
- 马云|马云消失半年后首次露面,奢侈生活现状曝光