
服务器|云原生数据库的幕后英雄—浅谈分布式数据库的计算和存储分离
分布式数据库替代传统商业数据库是近年最热门和最具争议的话题。理论上没有什么数据库不能被替代,现实却往往是代价大到难以承受。怎样才能更好的降低替代带来的代价呢?开源数据库TiDB创始人黄东旭在《近十年数据库流行趋势纵览!存储计算分离、ACID 全面回归......》将“存储和计算分离”作为近年数据库改造流行趋势之首,其作用就是降低数据库替代的代价。本文将通过分析当前主流厂商的数据库计算和存储分离(简称存算分离)对数据库替代中一些棘手问题进行解析,供分布式云原生数据库开发和使用者参考。
计算和存储分离是行业巨头共同的选择
回顾存算分离的发展历程,今天倡导分离的,恰巧就是当年提出计算和存储一体架构的互联网和云计算巨头们。到底存算分离有什么独特的魅力,我们看看业界的巨头大V怎么说?
作为公有云的开创者,AWS在十多年前就推出了Hadoop托管服务EMR。EMR采用了S3存储替代HDFS作为存储层:“与本地集群要求严格的基础设施不同,EMR可以将计算和存储分离,使您能够独立扩展每层并利用 Amazon S3 的分层存储。利用EMR,您可以预置一个、数百个甚至上千个计算实例或容器来处理任何规模的数据,只需要按实际使用量付费。” 这反映出AWS对存算分离带来价值的认知:灵活扩展和节省成本(按量付费)。这颠覆了长期以来大家对使用外置存储扩展性差,成本高的认知。在历经市场考验后,也被业界纷纷效仿。
阿里副总裁,数据库产品事业部总裁李飞飞在《云原生分布式数据库与数据仓库系统点亮数据上云之路》中说:“传统的冯诺依曼架构下计算和存储是紧密耦合的,可将多个服务器通过分布式协议和处理的方式连成一个系统,但是服务器和服务器之间、节点和节点之间,分布式事务的协调、分布式查询的优化,尤其要保证强一致性、强ACID的特性保证的时候,具有非常多的挑战……云原生的架构,本质上底下是分布式共享存储,上面是分布式共享计算池,中间来做计算存储解耦,这样可以非常好地提供弹性高可用的能力,做到分布式技术集中式部署,对应用透明。”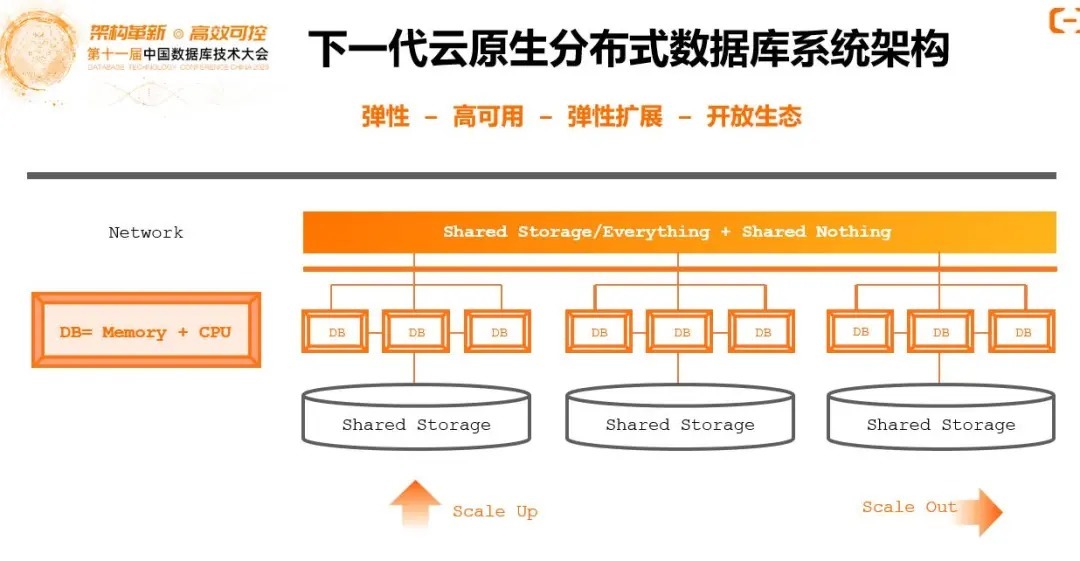
阿里的云原生数据库重新回到提升数据库Scale Up扩展能力的路上,来解决分布式事务,弹性扩展的问题。在必要时可以结合分布式分库分表模式进行Scale Out扩展。
华为云数据库专家也表示“高可用、易用易维、高扩展、高性能、与大数据相辅相成的云数据库,尤其是基于云场景架构设计的云原生分布式数据库,计算与存储分离、能充分发挥最新硬件性能、利用 AI 和 ML(深度学习) 等功能成发展趋势。”
上面几家是上(数据库)下(存储)内(自有业务)外(公有云)通吃的,而Facebook这种自己玩的互联网厂商完全从自己的业务需要出发,研发了一套温数据存储,以存算分离的架构来支撑亿的用户量产生的大数据。而Snowflake走了一条采用通用对象存储构建公有云数据仓库服务的道路,并实现了数据仓库的计算无状态化。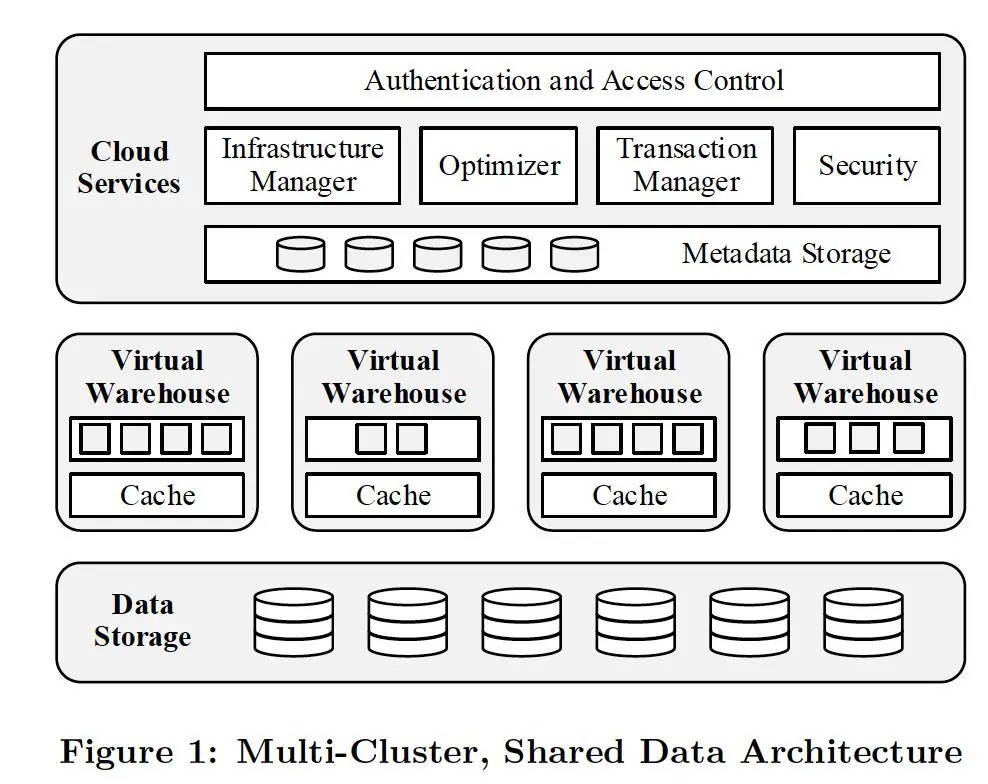
云原生中无处不在的存算分离
云原生一直在努力实现无状态化,而实现的手段就是把数据层剥离出去!只不过在应用层,数据可以剥离给缓存、数据库、文件存储和消息队列,而数据库、消息队列等要云原生时就只能自己做存算分离了。像最近大火的消息队列Apache Pulsar 给自己的定义是这样的:“Apache 软件基金会顶级项目,下一代云原生分布式消息流平台,集消息、存储、轻量化函数式计算为一体,采用计算与存储分离架构设计,支持多租户、持久化存储、多机房跨区域数据复制,具有强一致性、高吞吐、低延时及高可扩展性等流数据存储特性。”
- 华为|云计算的到来,在你身边有哪些相关联的。怎么看云计算呢(十九)
- 马云|马云自己\打脸\之前所说的,如今现身西班牙,开12亿游艇!
- 云厂商为什么都在冲这个KPI?
- 云计算|云计算的到来,在你身边有哪些相关联的。怎么看云计算呢(十五)
- 金山云|2000元的手机也搭载4nm芯片,为啥还要买四五千元的?看完明白了
- 嘉定这家专业用品市场推出“云逛店”模式
- 蚂蚁森林|马云承诺每年在沙漠里“种树”,如今6年过去了,现在怎么样了?
- 腾讯|微信上车碰壁,腾讯选择“云造车”
- “星云”纯电系统化平台首揭秘,上汽七大技术底座正加快落地
- 马云|马云消失半年后首次露面,奢侈生活现状曝光