
se|EMNLP2021 Findings|字节火山翻译提出:基于自修正编码器的神经机器翻译( 二 )
一个关键的问题是如何生成这些训练数据?关键点在于获取从带噪数据转化为干净数据的编辑操作。作者提供了两种方式。一种是针对有带噪数据和对应干净 reference 数据的情况,一种是没有带噪数据的情况。
对于有reference的数据,可以使用类似计算最短编辑距离的方法,获取从带噪数据转化为干净数据的最短编辑过程,然后将替换操作转化为删除-插入操作。
对于没有reference的数据,可以使用基于规则的方法生成伪数据。针对不同的场景,可以设计对应的规则,然后从干净的数据中生成带噪数据,最后反向这个过程就可以得到编辑过程。
训练完成后,便可以进行解码。正如图2右侧展示的,Secoco 有两种解码方式。第一种是仅使用编码器-解码器结构直接进行翻译 (Secoco-E2E),另一种则是对输入进行迭代编辑后再进行翻译 (Secoco-Edit)。
如表1所示,对话测试集包含主语省略,标点省略,错别字等问题;语音测试集包含口语词,错别字等 ASR 引起的问题;WMT14 则包含由规则构造的随机插入,随机删除,重复等问题。
实验结果如表2所示。除了 Secoco 之外,作者还和3种方法进行了对比,分别是将合成的噪声数据加入原始数据中一起训练 (BASE+synthetic);使用修复模型加上翻译模型的 pipeline 级联结构 (REPAIR);以及多编码器-单解码器的结构 [1] (RECONSTRUCTION)。可以看出,所有的方法相较于基线模型都有所提升。Secoco 在三个测试集上都获得了最好的效果。
此外,在这三个测试集中,对话测试集明显包含更多的噪声,Secoco 最多可以带来3个 BLEU 的提升。语音测试集由于是由 ASR 导出的,因此最好的结果也仅有12.4。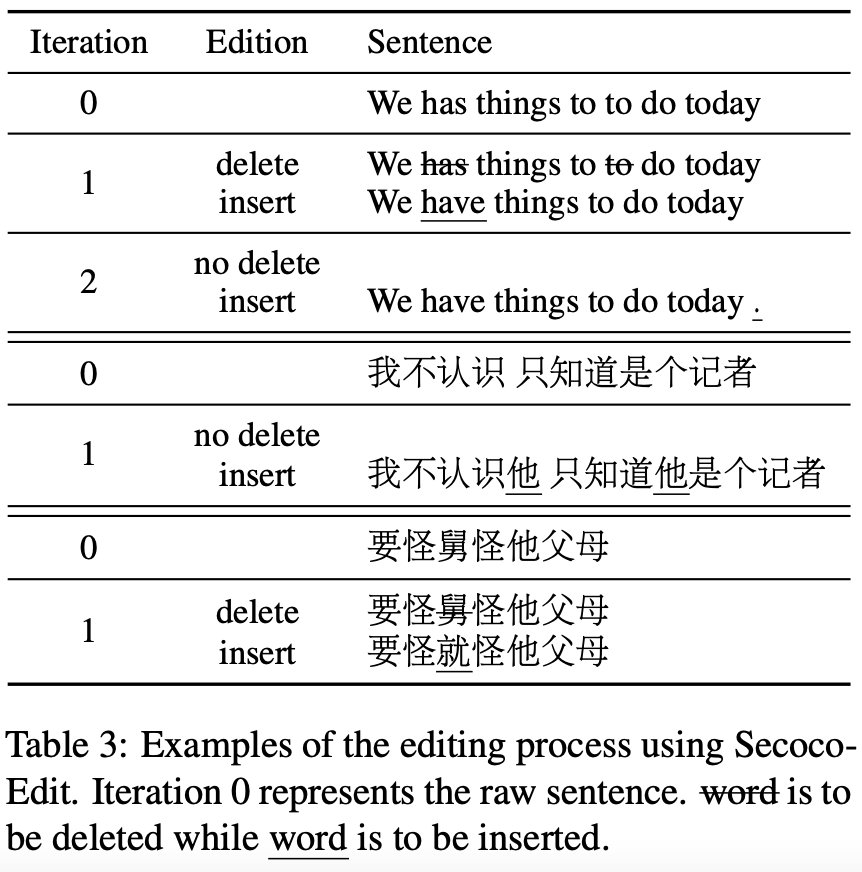
表格3中给出了一些迭代编辑的具体例子。针对每一句输入,模型对其进行迭代删除和插入操作,直到文本不再发生变化。从例子中可以看到,一次编辑操作可以同时删除或者插入多个词。此外,对于上述的测试集,平均每个句子需要2-3次编辑操作。
雷峰网
- 阿维塔|在避免患上大公司病上,字节跳动、小米保持高度一致
- 电子商务|又是欠钱不还、卷款跑路,这次连腾讯字节们都看走眼!
- 小米科技|236: 京东外卖业务;毕业生报告;新东方建供应链;字节教育业务调整
- 供应链管理|?TikTok美国用户数据已被转到甲骨文,由新团队控制,字节无法访问
- tiktok|?TikTok美国用户数据已转移到甲骨文,由新团队控制,字节无法访问
- 裁员|字节跳动大裁员:有部门2万多人 只剩1000多人
- 美国|TikTok交出美国用户数据:字节跳动自己都无法访问
- 游戏|消息称字节跳动上海游戏工作室解散:300多员工走了一半
- 张一鸣|字节跳动创始人张一鸣,4次创业失败,第五次改变6亿中国人
- 字节跳动 AI Lab 提出多模态模型:X-VLM,学习视觉和语言多粒度对齐