
ICCV|Google华博士在ICCV 2021发布新模型,打个鸡蛋就知道你要做煎饼( 二 )
研究中主要解决了未来预测的三个核心问题:
1. 手动标注视频中的时间关系是非常耗时耗力的,而且很难定义标签的正确性。所以模型应当能够从大量未标记的数据中自主学习和发现事件的变换,从而实现实际应用。
2. 对现实世界中复杂的长期事件变换进行编码需要学习更高层次的概念,这些概念通常在抽象的潜在表示中可以找到,而非只是图像中的像素。
3. 时序的事件变换非常依赖于上下文,所以模型必须能够在可变时间间隔下预测未来。
为了满足这些需求,研究人员引入了一个新的自监督训练目标函数MMCC以及一个学习表达式来解决这一问题的模型。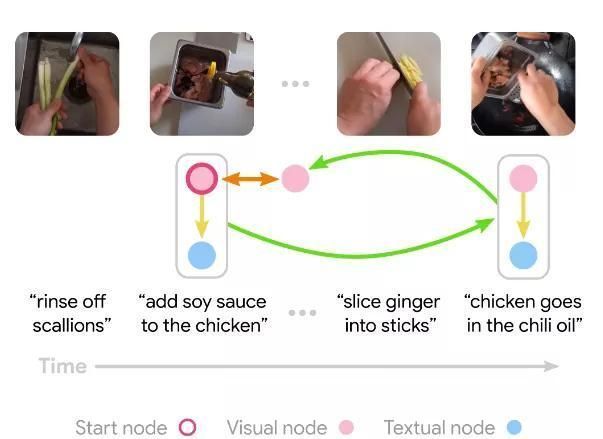
模型从叙事视频中的一个样本帧开始,学习如何在所有叙事文本中找到相关的语言表述。结合视觉和文本这两种模式,该模型能够用到整个视频来学习到如何预测潜在未来的事件,并估计该帧的相应语言描述,并以类似的方式学习预测过去帧的函数。
循环约束(cycle constraint)要求最终模型预测等于起始帧。
另一方面,由于该模型不知道其输入数据来自哪个模式,因此必须在视觉和语言上共同运作,因此无法选择较低级别的未来预测框架。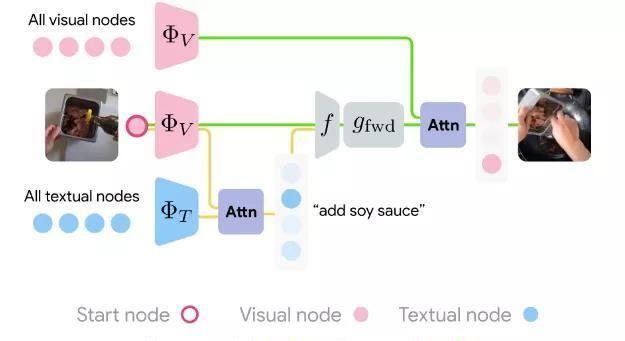
模型学习嵌入所有视觉和文本节点,然后在其他模式下仔细计算与起始节点对应的跨模式节点。这两个节点的表示都被转换为全连接层,预测了在初始模态下使用注意力的未来帧。然后重复backward过程,模型损失是通过预测起始节点来训练模型的最终输出来结束循环(cycle)。
在实验部分,由于大多数先前的benchmark侧重于具有固定类别和时间偏移的有监督行为预测,这篇论文中研究人员设计了一系列新的定性和定量实验来评估不同的方法。
首先是数据,研究人员在无约束的真实世界视频数据上训练模型。使用HowTo100M数据集的子集,其中包含大约123万个视频及其自动提取的音频脚本。此数据集中的视频大致按主题区域分类,并且只使用分类为 Recipe 的视频,大约是数据集中的四分之一。
在338033个Recipe视频中,80% 为训练集,15%在验证集,5%在测试集。Recipe视频包含了丰富的复杂对象、操作和状态转换,并且该子集能够让开发者更快地训练模型。
为了进行更多的控制测试(controlled test),研究人员使用CrossTask数据集,包含相似的视频以及特定于任务的标注。
所有视频都与任务相关,例如制作煎饼等,其中每个任务都有一个预先定义的高级别子任务序列,这些子任务具有丰富的长时间的相互依赖性,例如,要先把糊弄到碗里,然后才能把鸡蛋打成碗,再加入糖浆等等。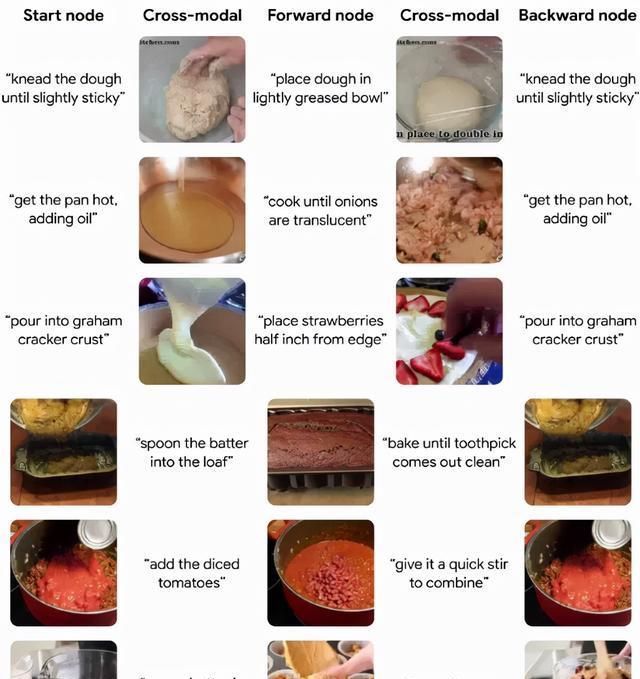
使用TOP-K召回指标评估模型预测行动的能力来衡量了模型预测正确未来的能力(越高越好)。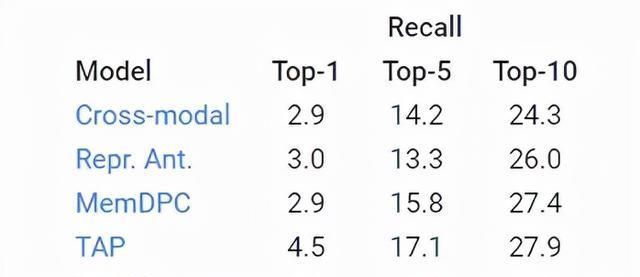
对于MMCC,为了确定整个视频中有意义的随时间推移的事件变化,研究人员根据模型的预测,为视频中的每个帧对(pair)定义了一个可能的过渡分数,预测的帧越接近实际帧,则分数越高。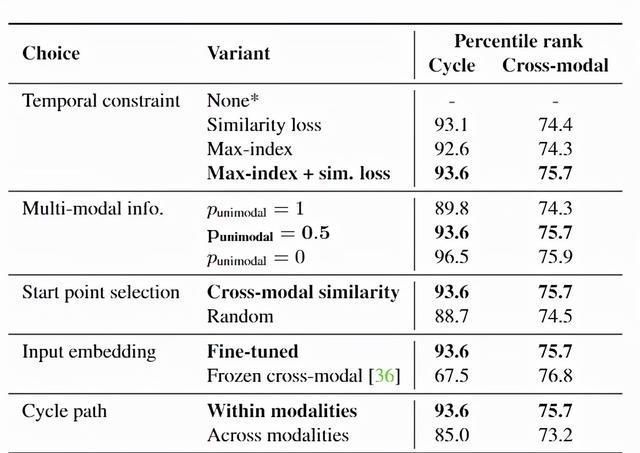
参考资料:
【 ICCV|Google华博士在ICCV 2021发布新模型,打个鸡蛋就知道你要做煎饼】https://ai.googleblog.com/2021/11/making-better-future-predictions-by.html
- 苹果|华为新一代“小方表”来了:Watch FIT 2正式官宣
- 早报:华为P50 Pocket新色预售 百度世界大会定档
- ZOL科技早餐:华为千元手表官宣,腾讯QQ回应大规模盗号
- 华为|意识到离不开中国了?外媒称华为、中兴或将重新打入美国市场
- 华为鸿蒙系统|鸿蒙3.0即将推送,Mate 50首发
- 网友热议|母亲回应3个孩子2个上清华:只能教孩子做人诚实守信 学习都靠自己努力
- 华为|重磅级新品官宣:华为全屋智能2.0将于7月4日发布 前代39999元起
- 口红|下周发布!华为P50 Pocket新版开启预订:送1699元口红耳机
- 华为|华为新款86英寸电视曝光:京东方代工 120Hz高刷4K屏
- 华为nova 10定档7月4日见!真机渲染图曝光:星耀环设计