
ICCV|Google华博士在ICCV 2021发布新模型,打个鸡蛋就知道你要做煎饼
编辑:LRS
【导读】预测未来一直是人类梦寐以求的事,而刚好机器学习模型正好擅于预测。最近Google、布朗大学的华人博士在ICCV 2021发表了他的新工作,在菜谱视频数据集中可以合理预测未来,还不受时间限制,打个鸡蛋就知道你要做煎饼!随着机器学习的模型在现实世界中的应用和部署越来越多,AI 的决策也能够用于帮助人们在日常生活中做出决策。
在计算机视觉领域的决策过程中,预测(Prediction)一直都是一个核心问题。
如何在不同的时间尺度上对未来作出合理的预测也是这些机器模型的重要的能力之一,这种能力可以让模型预测出周围世界的变化,包括其他模型的行为,并计划下一步如何行动与决策。
更重要的是,成功的未来预测(future prediction)既需要捕捉环境中的有意义的物体变化,也需要了解环境如何随着时间的推移进行变化,以便作出决策和预测。
计算机视觉中关于未来预测的工作主要受限于其输出的形式,输出可能是图像的像素或者是人工预定义的一些标签(例如预测某人是否会继续行走、坐下等)。
这些预测内容都太过详细以至于难以完全预测成功,并且对现实世界信息的丰富性也缺乏有效利用。也就是说,如果一个模型在预测「跳跃行为」时,并不知道为什么他们会跳跃,或者他们在跳什么等等,那就没办法预测成功,结果基本等于乱猜。
此外,除了极少数例外,之前的模型被设计成对未来进行固定偏移(offset)的预测,无法进行动态时间间隔的预测,虽然这是一个限制性的假设,因为我们很少知道何时会出现有意义的未来状态。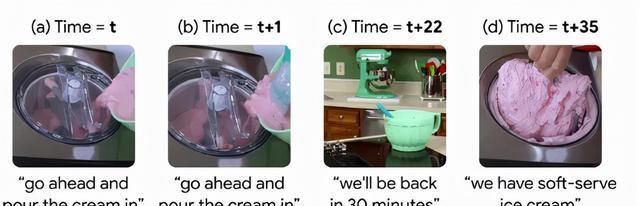
在一个制作冰淇淋的视频中,从cream到ice cream在视频中的时间间隔为35 秒,因此预测这种变化的模型需要提前35秒来预判。但这一间隔在不同的行为和视频中变化很大,例如有的博主可能用了更详细、更长时间来制作冰淇淋,也就是说在未来的任何时间都有可能制作完成冰淇淋。
此外,可以大规模、数以百万计收集此类视频逐帧标注,许多教学视频都有语音转换记录,通常在整个视频中提供简明、一般的描述。这种数据源可以引导模型关注视频中的重要部分,而无需手动标注就能够对未来事件进行灵活的数据驱动预测。
基于这个思路,Google在ICCV 2021上发表了一篇文章,提出了一种自监督的方法,使用了一个大型、未标记的人类活动数据集。所建立的模型具有高度的抽象性,可以任意时间间隔对未来进行远距离预测,并能够根据上下文选择对未来的远期预测。
模型具有多模态周期一致性(Multi-Modal Cycle Consistency,MMCC)的目标函数,能够利用叙事教学视频来学习一个强大的未来预测模型。研究人员在文中还展示了如何在不进行微调的情况下,将MMCC应用于各种具有挑战性的任务,并对其预测进行了量化测试实验。
文章的作者Chen Sun来自Google和布朗大学,目前是布朗大学计算机科学助理教授,研究计算机视觉、机器学习和人工智能,也是谷歌研究所的一名研究科学家。
他在2016年博士毕业于南加州大学,导师是Ram Nevatia教授,于2011年完成清华大学计算机科学学士学位。
正在进行的研究项目包括从无标签视频中学习多模式表示和视觉交流,识别人类活动、对象及其随时间的相互作用,并将表示转移到embodied agents。
- 苹果|华为新一代“小方表”来了:Watch FIT 2正式官宣
- 早报:华为P50 Pocket新色预售 百度世界大会定档
- ZOL科技早餐:华为千元手表官宣,腾讯QQ回应大规模盗号
- 华为|意识到离不开中国了?外媒称华为、中兴或将重新打入美国市场
- 华为鸿蒙系统|鸿蒙3.0即将推送,Mate 50首发
- 网友热议|母亲回应3个孩子2个上清华:只能教孩子做人诚实守信 学习都靠自己努力
- 华为|重磅级新品官宣:华为全屋智能2.0将于7月4日发布 前代39999元起
- 口红|下周发布!华为P50 Pocket新版开启预订:送1699元口红耳机
- 华为|华为新款86英寸电视曝光:京东方代工 120Hz高刷4K屏
- 华为nova 10定档7月4日见!真机渲染图曝光:星耀环设计