
IEEE Fellow 梅涛当选 ACM
编辑 | 维克多
最佳Demo奖:ViDA-MAN: Visual Dialog with Digital Humans
贡献:展示了一个完整的多模态数字人系统,包含语音模块、对话模块、视觉模块、驱动模块以及流模块等。
最佳开源奖:X-modaler: A Versatile and High-performance Codebase for Cross-modal Analytics
贡献:跨模态分析的多功能和高性能的代码库,统一了最先进的视觉语言技术中的全面的高质量模块。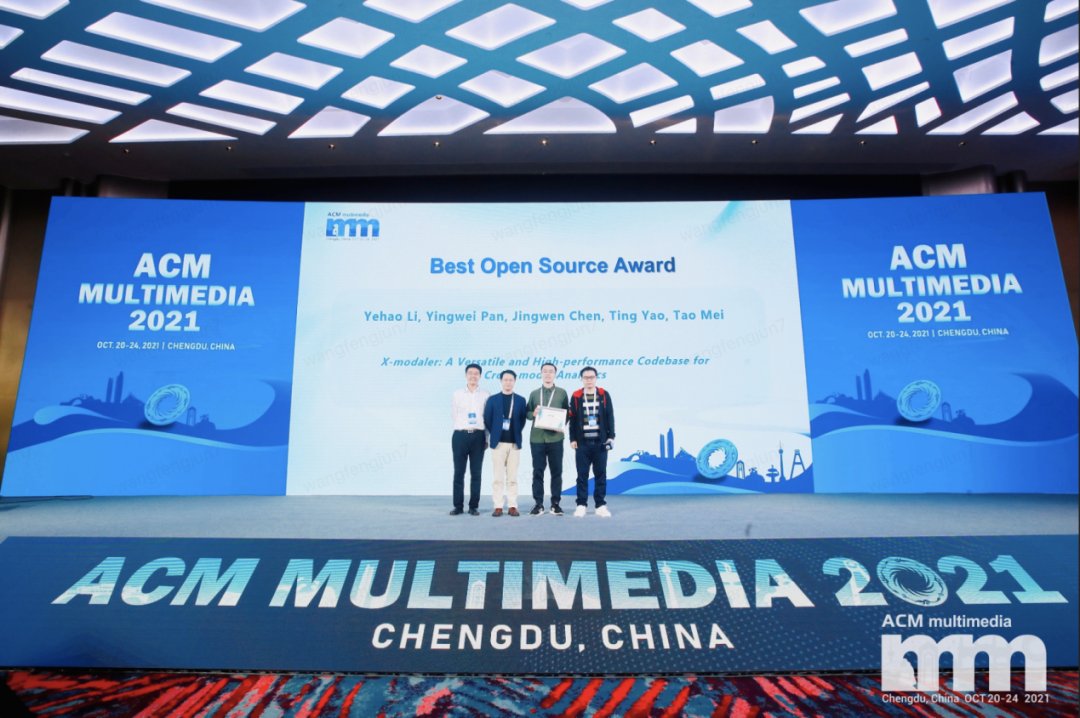
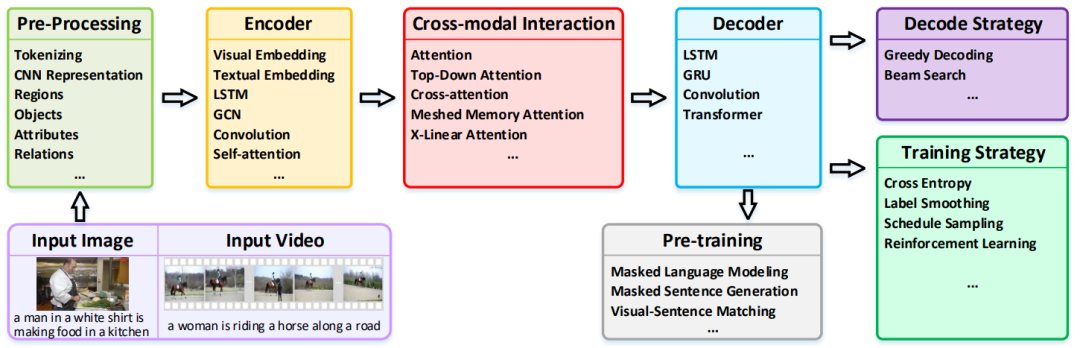
基于这七大模块,X-modaler就可以轻松支持各种多模态任务,如image/video captioning、vision-language pre-training、VQA、VCR、cross-modal retrieval,同时也能很好地复现每个多模态任务中的前沿技术,例如在image captioning的任务中X-modaler集成了京东AI团队从ICCV17的LSTM-A、ECCV18的GCN-LSTM、再到CVPR20的X-LAN。目前代码库支持的算法如下图,后续将不断加入更多最新技术的实现,整个代码库包括使用文档以及预训练模型均已开源(https://github.com/YehLi/xmodaler)。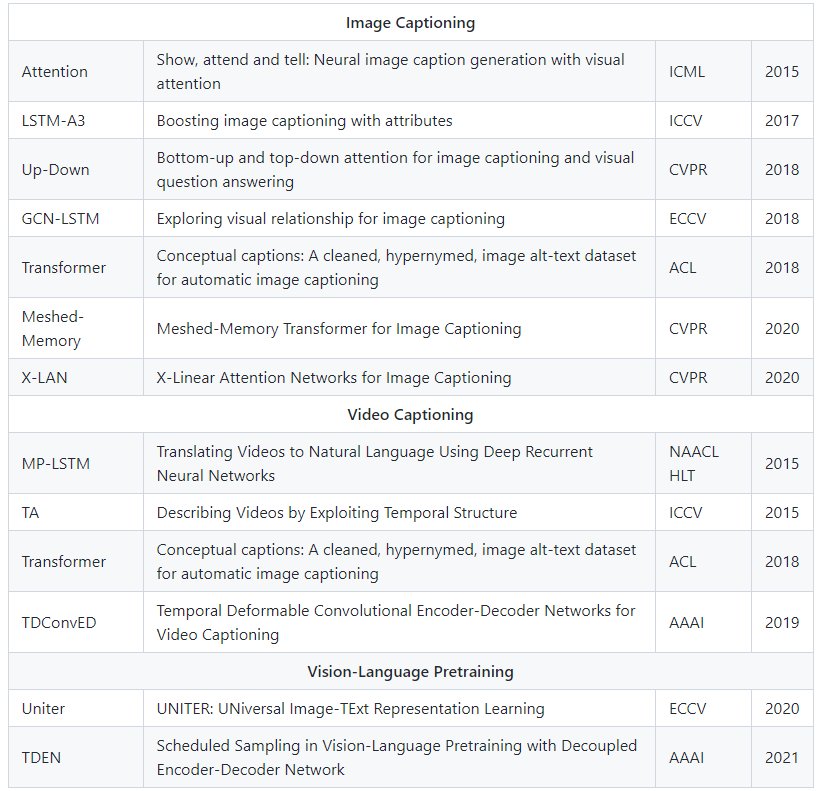
在传统的AI认知中,视觉领域、语音领域、自然语言领域等领域之前是独立演进的技术和应用,可以认为是单模态技术,而人是一个看、听、说多模态共同工作的智能体,所以多模态技术是未来人工智能应用发展的方向。
京东探索研究院多模态交互数字人技术ViDA-Man致力于打造具备多感官交互能力的人机交互系统,深入多模态交互技术研究,专注于人机交互的消费科技产品打造。基于该技术开发的多模态交互数字人形象引擎,能够提供快速的形象定制能力,从外观的数字化逐渐深入到行为的交互化、情绪的智能化。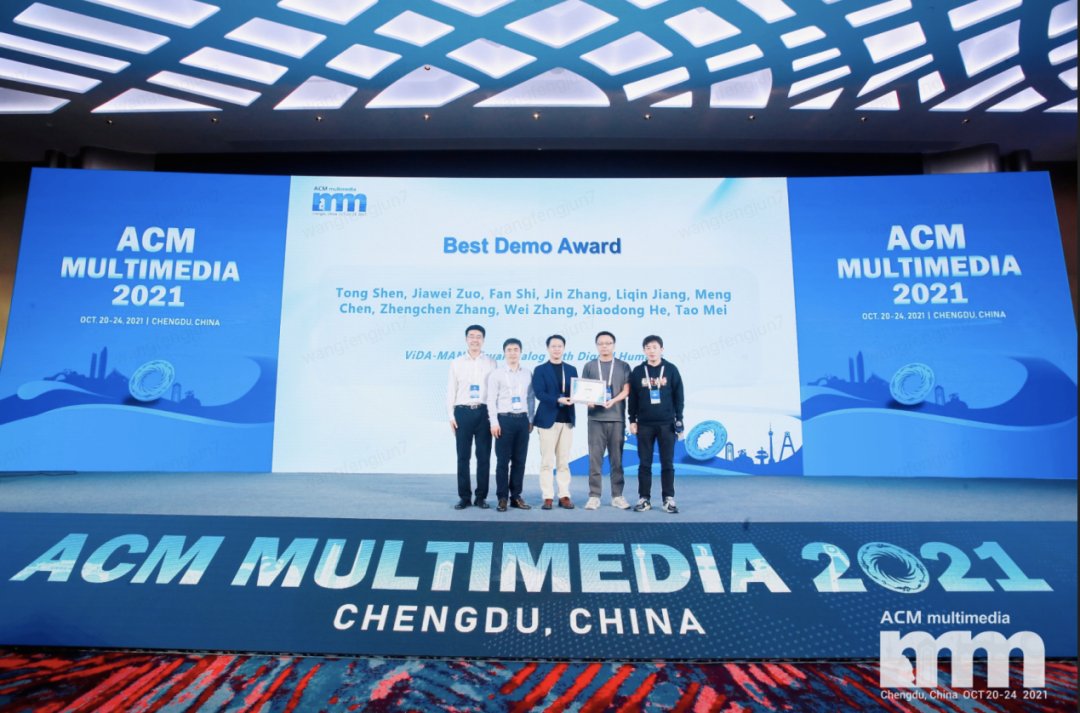
- 大咖云集! IEEE x ATEC科技思享会邀您畅谈网络欺诈的风险与对抗
- IEEE 通过”隐私计算安全需求”标准立项,蚂蚁集团牵头联合行
- Gan之父Ian Goodfellow从苹果辞职:我不想回办公室上班
- 对苹果来说|GAN之父Ian Goodfellow离职苹果
- ieee|vivoX80搭载天玑9000才3699起,走性价比路线了?
- 激发女性力量,大宇无限携手 IEEE 重新定义 她 时代
- IEEE全票通过首个隐私计算一体机国际标准立项,蚂蚁集团牵头推
- access|为什么科技工作者都应该关注IEEE Open Access?
- 默多克|IEEE Spectrum调查:AI 的 6 种最坏情况
- 阿里巴巴|继当选IEEE Fellow之后,阿里云李飞飞又新晋ACM Fellow