
范数|人工智能的梦魇:对抗攻击( 四 )
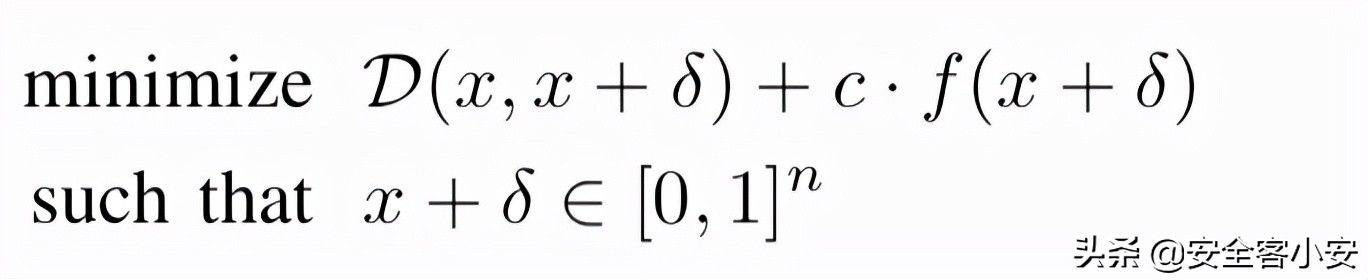
式子中的D是距离度量,f是自定义的对抗损失,只有当模型的预测为攻击目标时才满足f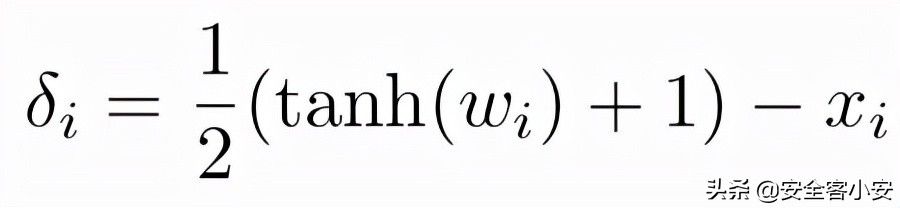
这是为了确保生成的对抗样本是有效的图像
对MNIST数据集应用L_infty范数,进行定向攻击,结果如下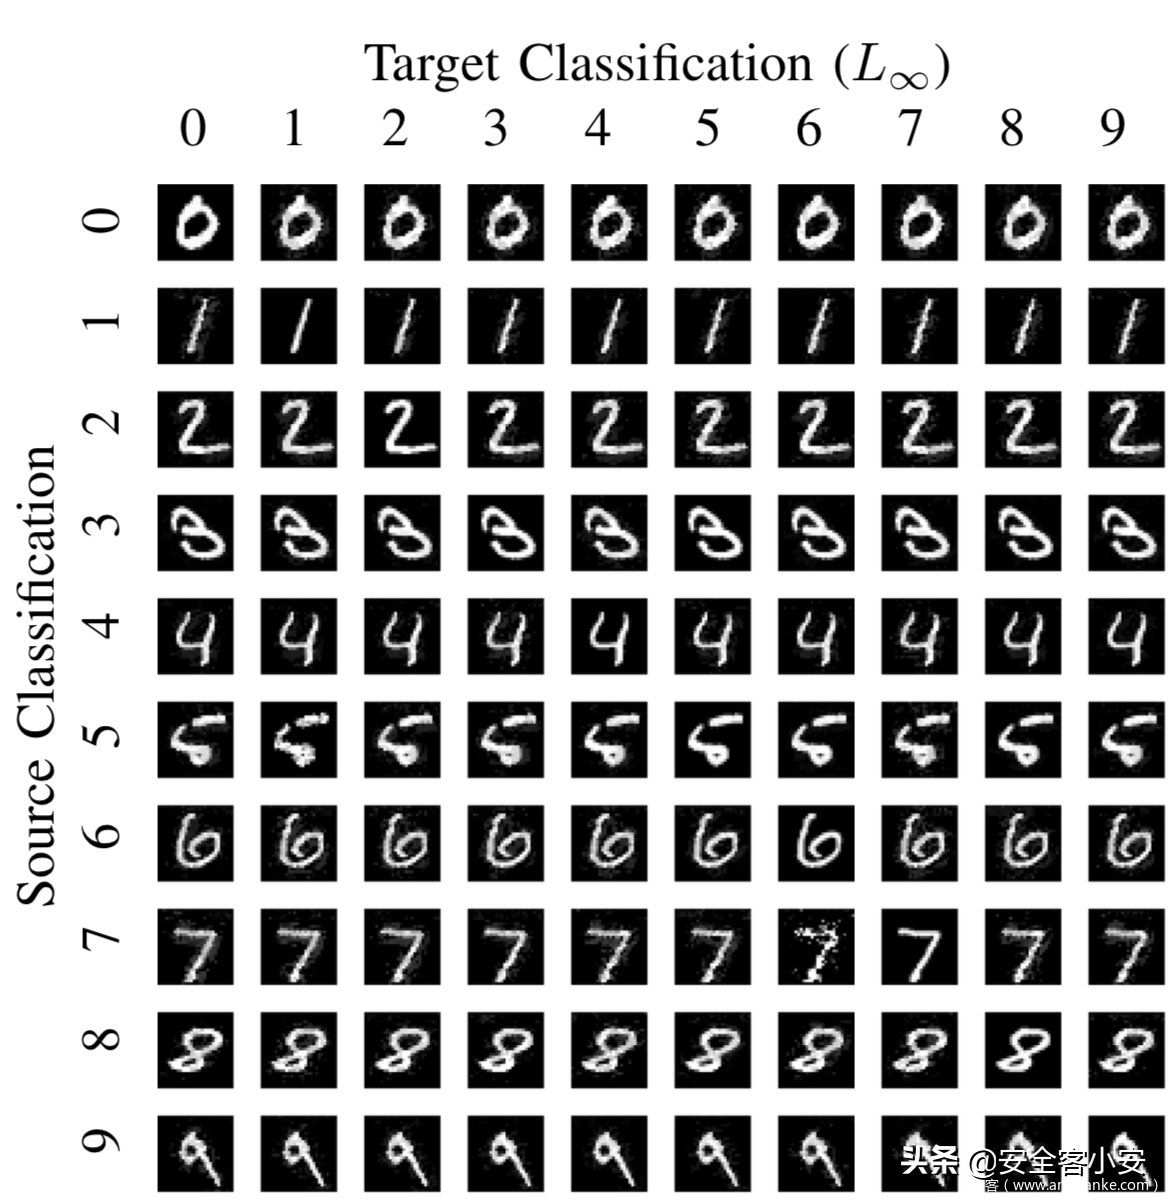
PGD[11]从鲁棒性优化的角度研究了神经网络的对抗鲁棒性,使用了一种natural saddle point (min-max) 公式来定义对对抗攻击的安全性。这个公式将攻击和防御放到了同一个理论框架中,使得我们对攻击和防御的性能有了良好的量化.作者对此鞍点公式相对应的优化场景进行了仔细的实验研究,提出了PGD这个一阶方法(利用局部一阶信息)来解决这个问题。鞍点问题如下所示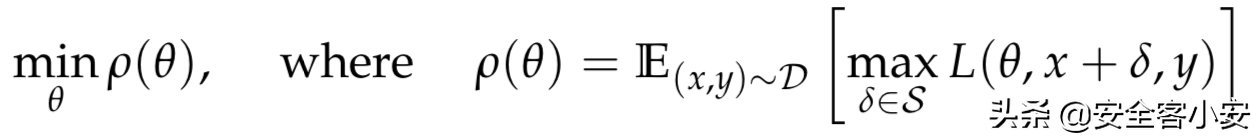
这个鞍点问题并不是那么容易解决。该问题涉及到出处理一个非凸的外部最小化问题和一个非凹的内部最大化问题。作者正是使用PGD解决最大化问题,其用下式生成对抗样本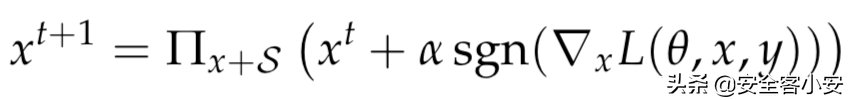
PGD是非常强的first-order攻击,能防御PGD的网络,就可以防御其他任何first-order攻击,所以在防御时很多工作都会用PGD进行对抗训练。针对MNIST训练集做的实验表明,PGD明显优于在PGD之前提出的对抗攻击方案: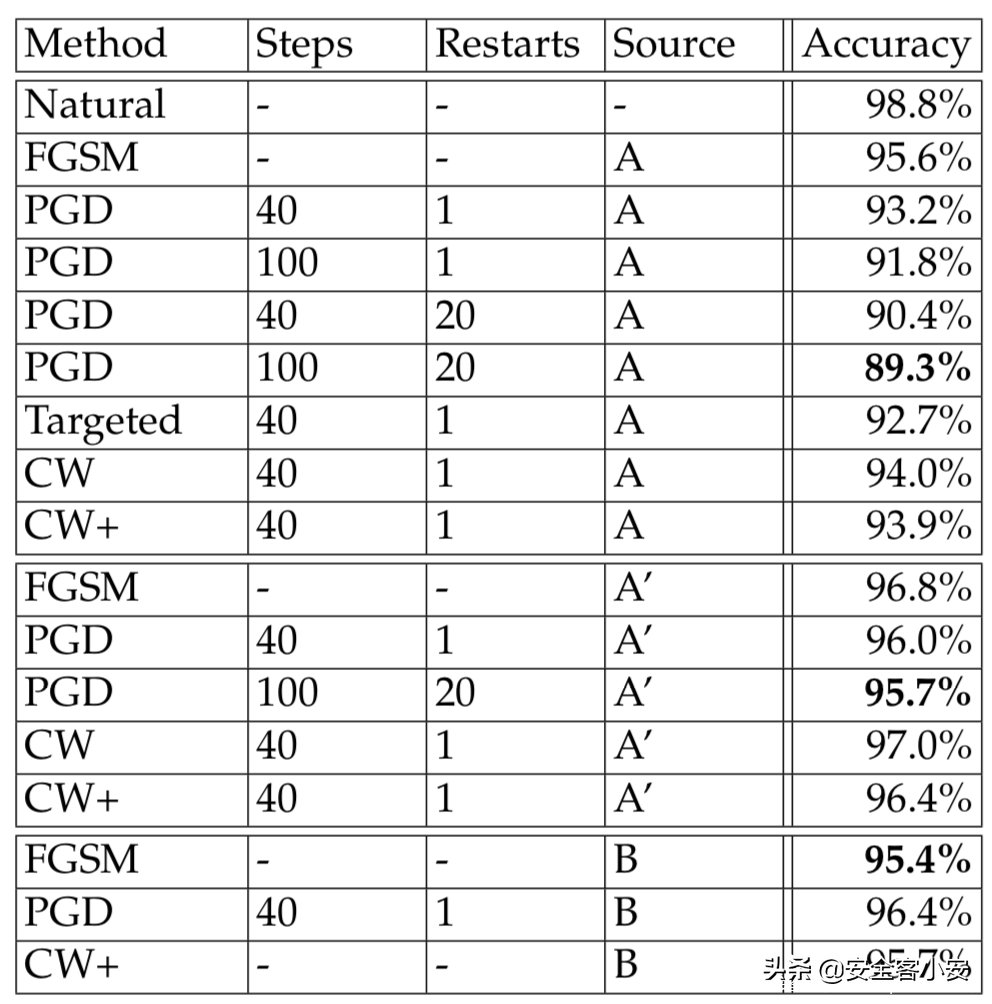
Deepfool[7]通过寻求当前的点在高维空间中离所有非真实类的决策边界中最近的一个,来作为攻击后的类,不过需要注意的是,这是一种贪心算法,并不能保证收敛到最优扰动,其通过下式迭代计算扰动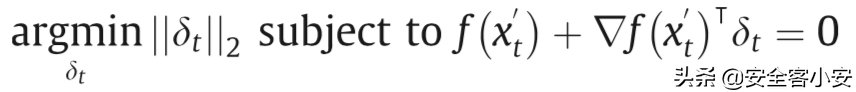
该方法只需将问题变为计算从x到所有类之间的决策边界所形成的凸多面体P表面的距离,就可以用于攻击多分类器。
下表是在不同分类器上做的比较,表中的引用文献4,18分别是本文中的[2],[1]
从表中可以看到,Deepfool的扰动是最小的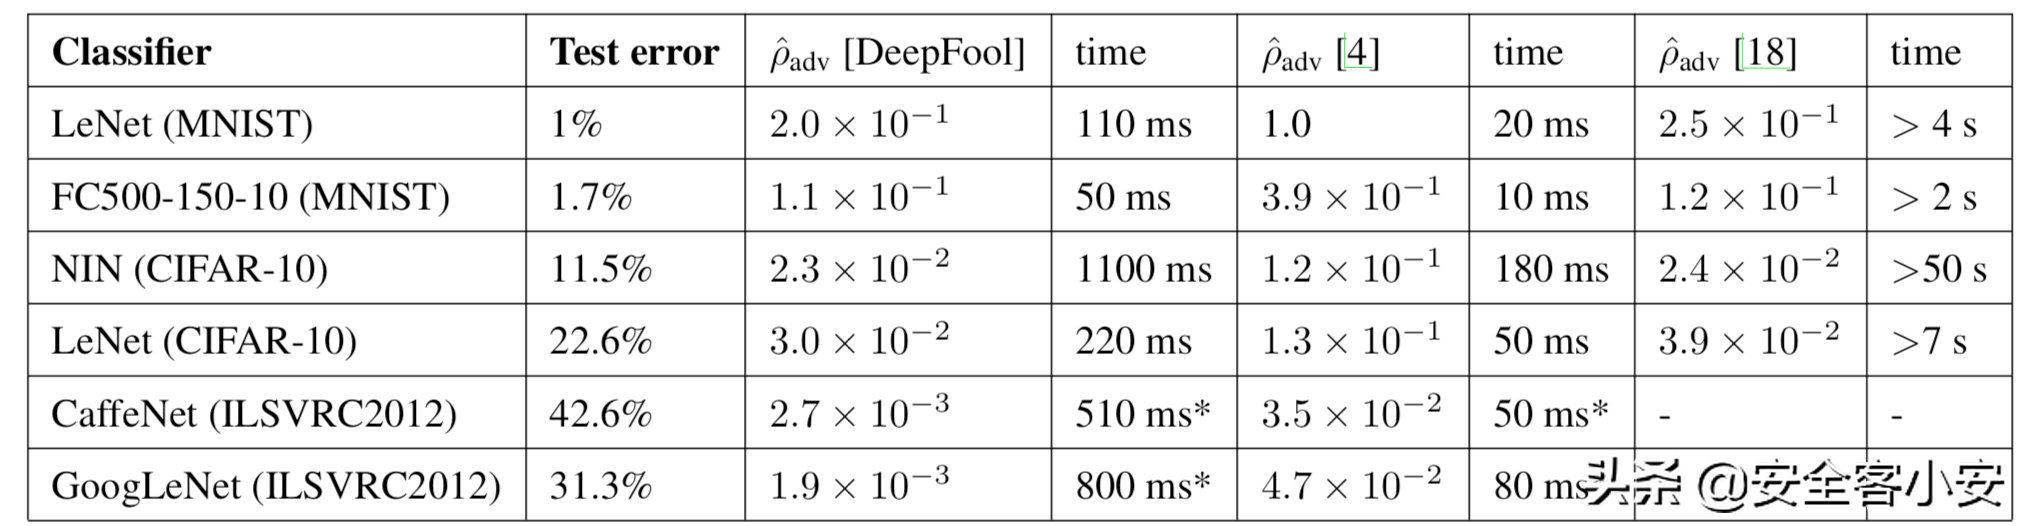
ATN[24]以自监督的方式训练前馈神经网络以生成对抗样本,其优化目标为: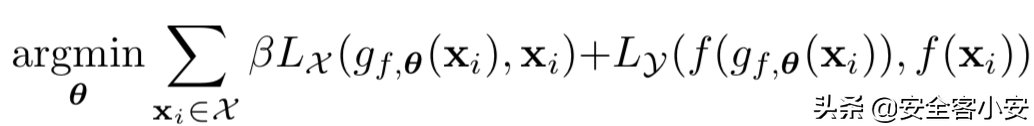
上式中的g就是我们需要的网络,输入原图像,输出对抗样本,即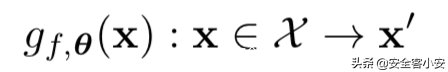
在该研究汇中,将Ly,t定义为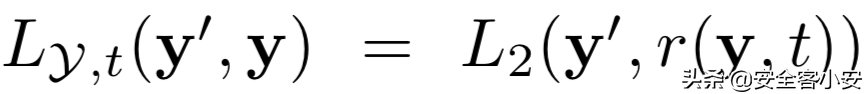
上式中的r(y,t)表示为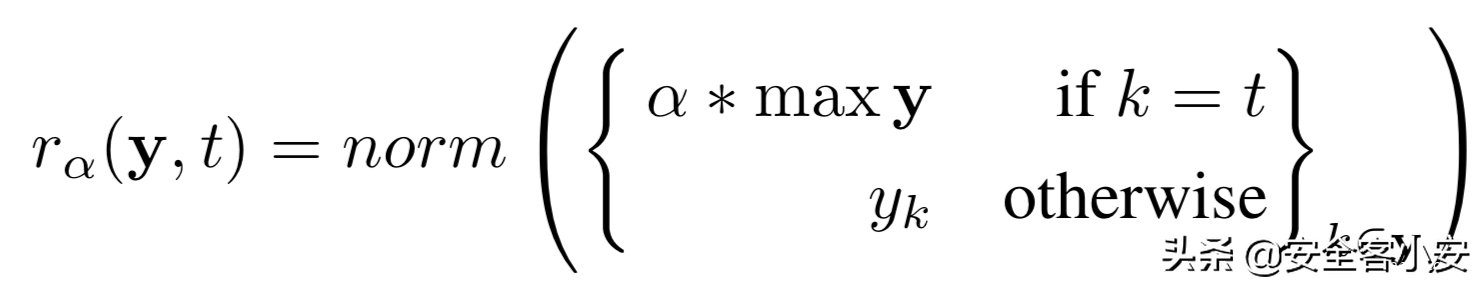
下图是对MNIST数据集0~9类分别对另外9个目标类的定向攻击,生成的对抗样本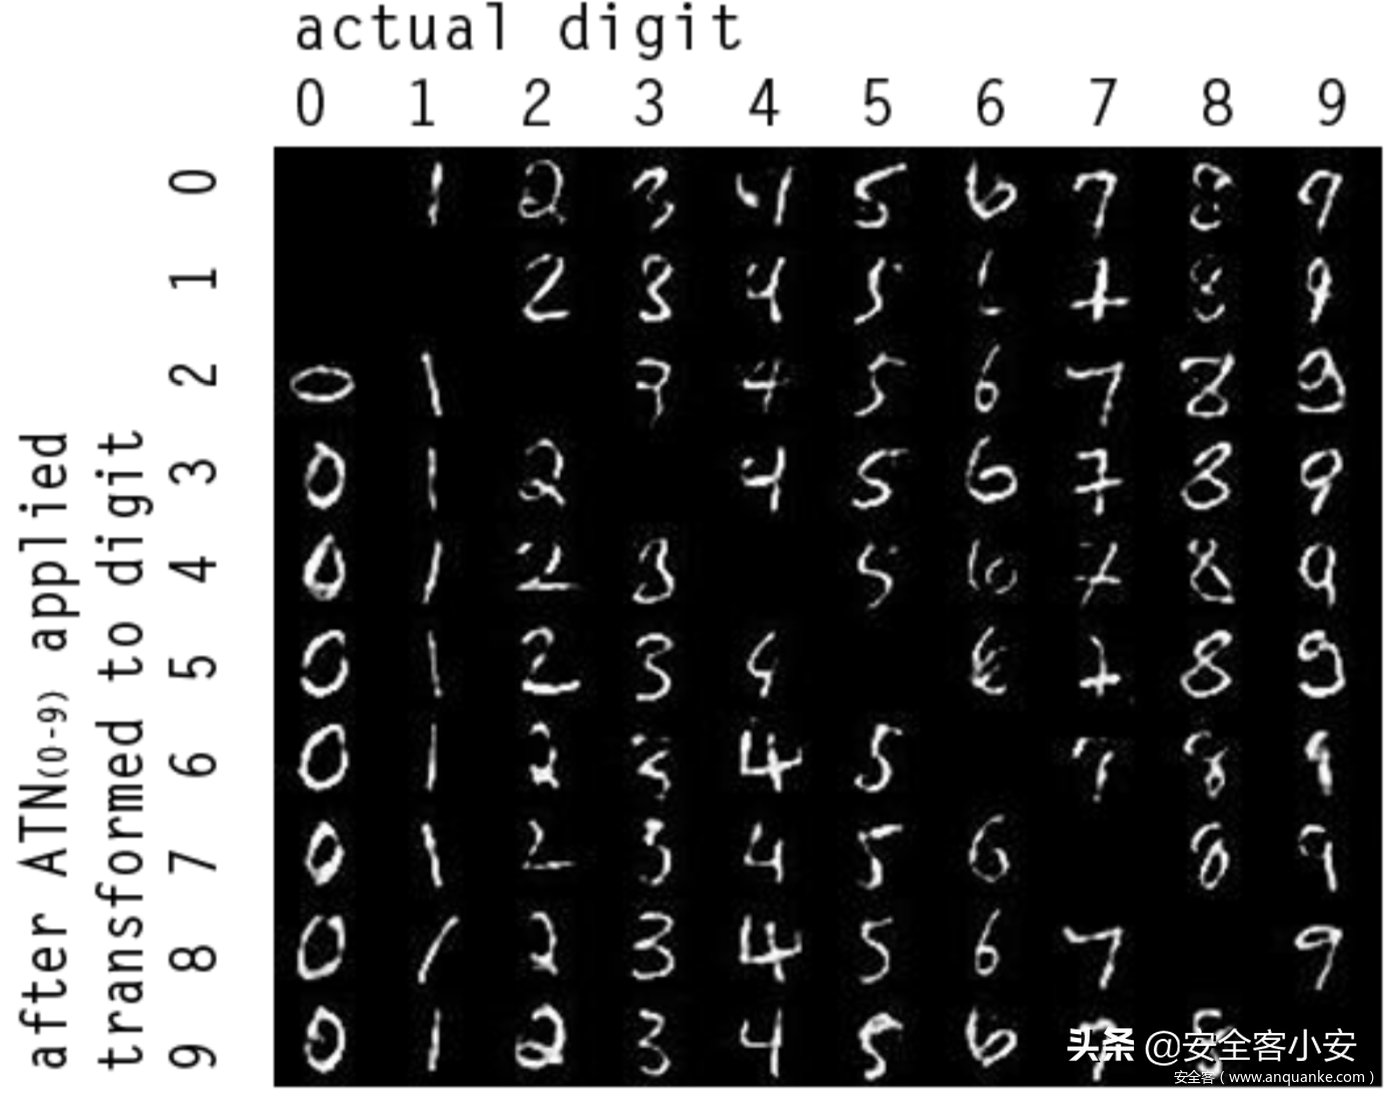
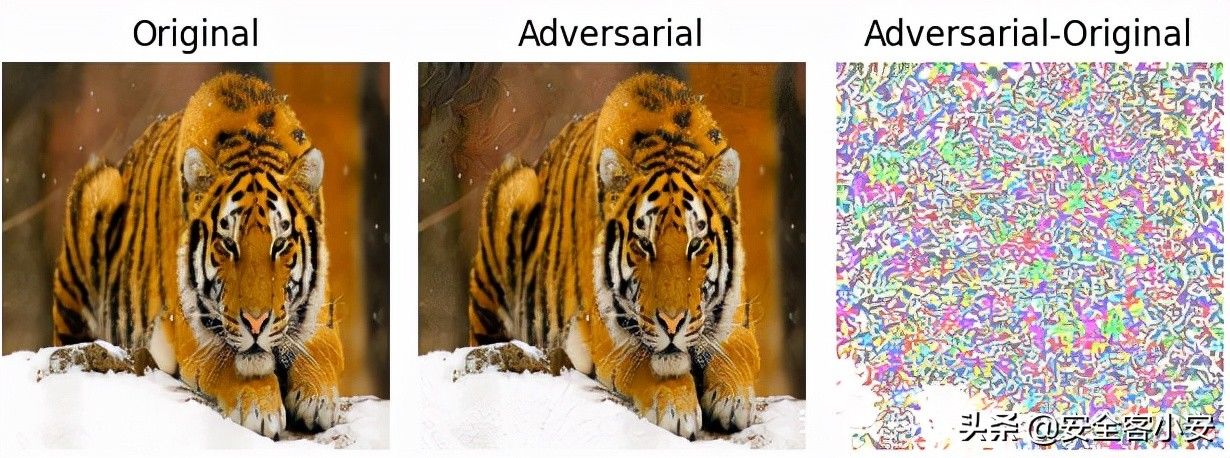
实战这部分给出几种流行的对抗攻击算法针对同一原样本实现的对抗攻击,为了便于比较,同时打印出lp范数、原样本、对抗样本以及加入的对抗扰动
L-BFGS
FGSM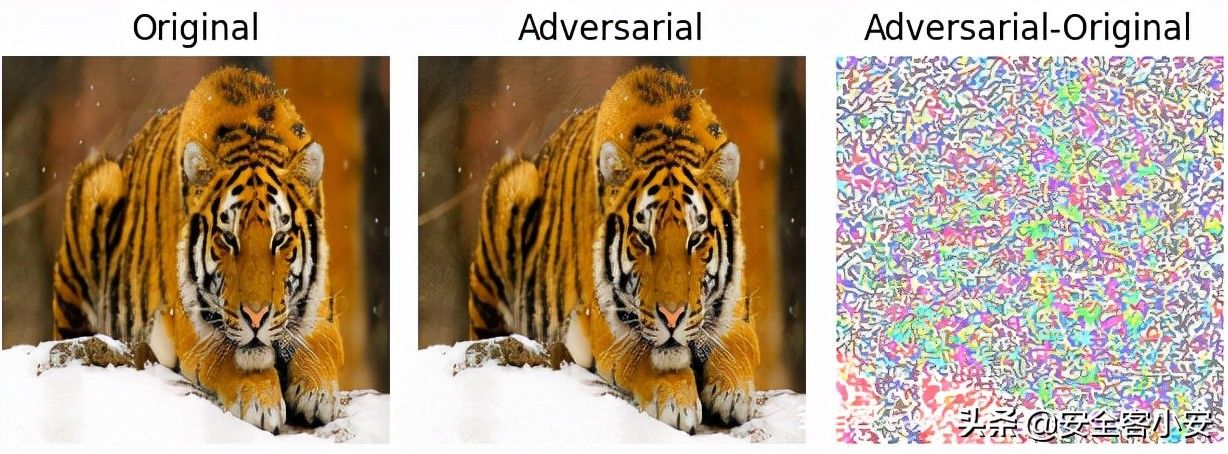
I-FGSM
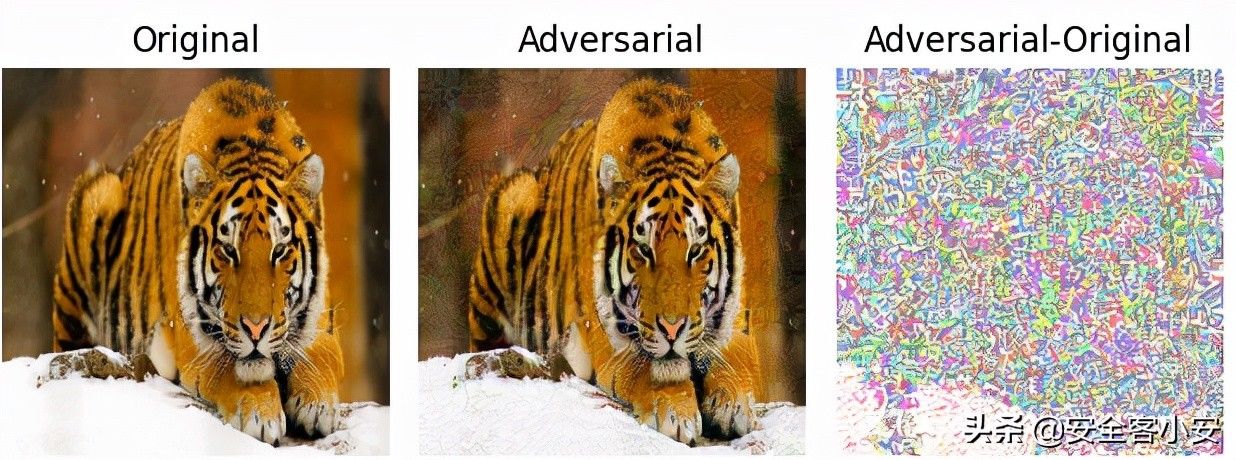
MI-FGSM
- 京东|裁员不忘膈应人,这家互联网大厂送的离职礼物恶心到我了!
- iPhone14|准大学生的数码装备推荐
- 有人觉得中暑就是热出来的,吃一些退烧药就好了,这种做法 蚂蚁庄园今日答案6月28日
- 浮甘瓜于清泉,沉朱李于寒水”描述的是什么场面 蚂蚁庄园今日答案6月28日
- 个头大的车厘子比小樱桃营养价值更高,对吗 蚂蚁新村6月28日答案最新
- 位于广东省阳江市的海陵岛自然资源丰富,景色优美,该岛没有 神奇海洋6月28日答案
- 哪种水果横着切开像星星的形状 蚂蚁庄园今日答案6月29日
- 为验证人类和黑猩猩,是否会产生新的后代,科学家找来5位姑娘!
- 喜马拉雅山出现的“雪人”是何生物?目击者:智商高、攻击性强
- 为什么科学家表示人类“灭绝”的可能性极低?这些理由你赞同吗?