PoinTr:几何敏感的多样点云补全TrICCV 2021 Or 点云

PoinTr:几何敏感的多样点云补全TrICCV 2021 Or 点云
作者 | 于旭敏
编辑 | 王晔
我们提出了一种几何敏感的点云补全Transformer,通过将点云表示成为一组无序的点代理,并采用Transformer的Encoder-Decoder结构进行缺失点云生成。除此以外,我们提出了两个更具有挑战性的点云补全Benchmark——ShapeNet-55/34。我们的论文已被ICCV接收为Oral Presentation,代码、数据集与模型均以开源。
代码仓库:https://github.com/yuxumin/PoinTr
论文链接:https://arxiv.org/abs/2108.08839
视频:https://youtu.be/mSGphas0p8g
PoinTr:几何敏感的多样点云补全TrICCV 2021 Or 点云


1

简介
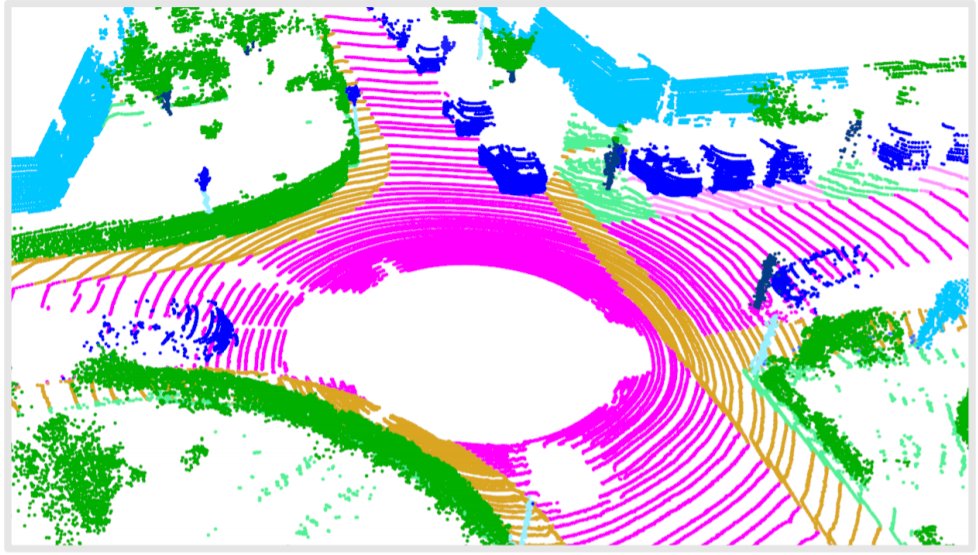
在现实场景下,现有的3D传感器由于物体自遮挡等问题只能采集到缺失且稀疏的点云数据,所以如何将这样缺失且稀疏的点云进行补全以得到高品质的点云,具有重大意义。
PoinTr:几何敏感的多样点云补全TrICCV 2021 Or 点云

想要借助无序且缺乏结构的点云数据进行3D物体形状的补全,我们需要充分挖掘已知点云中的结构信息与长程关系。为此,我们将点云补全问题建模为一个集合到集合的翻译问题,即通过已知的点云的信息翻译得到缺失部分的点云。我们提出了PoinTr模型,其核心在于通过Transformer-Encoder充分建模已知点云的结构信息与点间关系,再通过Transformer-Decoder学习缺失部分与存在部分的相互关系并以此重建缺失点云。
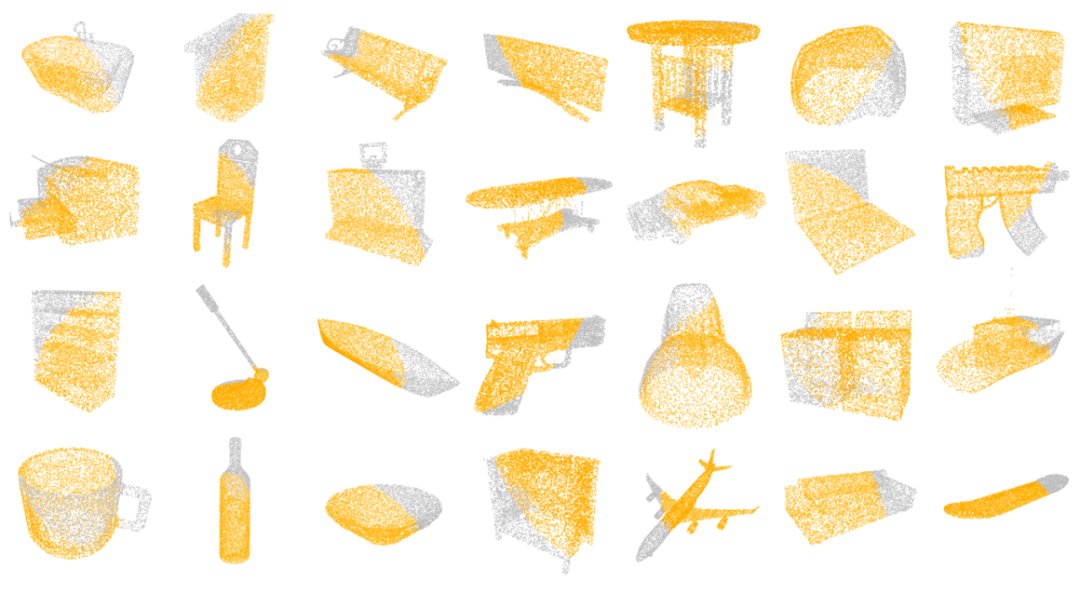
同时我们提出两个更具挑战性的点云补全Benchmark,用以检验点云补全模型在更贴近真实条件下的补全表现。其中ShapeNet-55相比于PCN数据集考虑了更多样的任务(点云补全与点云上采样)、更多样的种类(从原本的8类到55类)、更多样的缺失视角(从原本的8视角到任意可能视角)以及更多样级别的缺失(缺失25%到75%的点云);ShapeNet-34则可以测试模型在训练集中不存在的类别的物体上的补全表现。
PoinTr:几何敏感的多样点云补全TrICCV 2021 Or 点云


(ShapeNet-55/34数据集)

2

方法
下面介绍我们的整体框架,我们提出的PoinTr主体由Transformance Encoder-Decoder构成:
PoinTr:几何敏感的多样点云补全TrICCV 2021 Or 点云


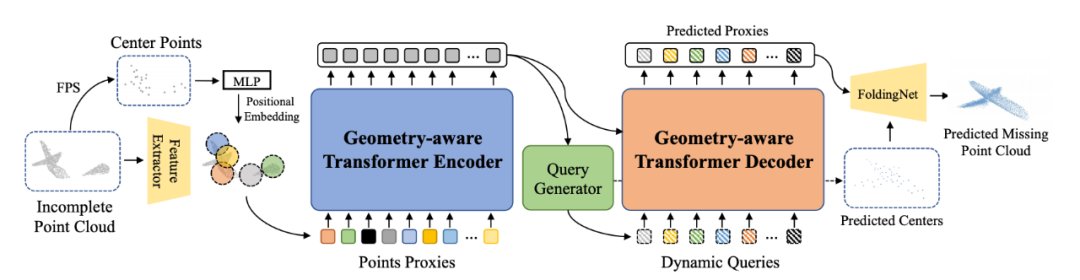
简单来说,在对点云进行补全时,我们会先将点云处理成为固定数目的点代理,方便作为Transformer的输入;然后我们通过Encoder对现有点云进行编码,通过Query Generator后生成第一阶段的点云中心和对应的动态Queries;最后这些Queries通过Decoder被翻译成点代理,点代理经过一个FoldingNet得到相对于特定中心点的偏移量,通过将对应中心进行移动,我们可以得到某个点代理对应的局部点云。
  • 点代理生成:
想要将点云作为Transformer的输入,首先我们需要将点云处理成一个序列。最简单的想法是将每一个点作为序列的一个元素作为输入,但是这样会带来非常大的计算资源负担。所以我们提出可以将点云处理成一系列的点代理,用来代表点云上的一个局部区域特征。首先,我们对点云进行最远点采样(FPS),得到固定的N个中心点;然后,我们使用一个轻量的DGCNN对局部区域进行特征提取,这样我们可以得到N个局部区域的特征,其中对应了以为中心点的区域的特征。最后,我们利用一个MLP网络,提取每一个局部特征的位置嵌入(positional embedding),相加后得到点代理,即,作为Encoder的输入。