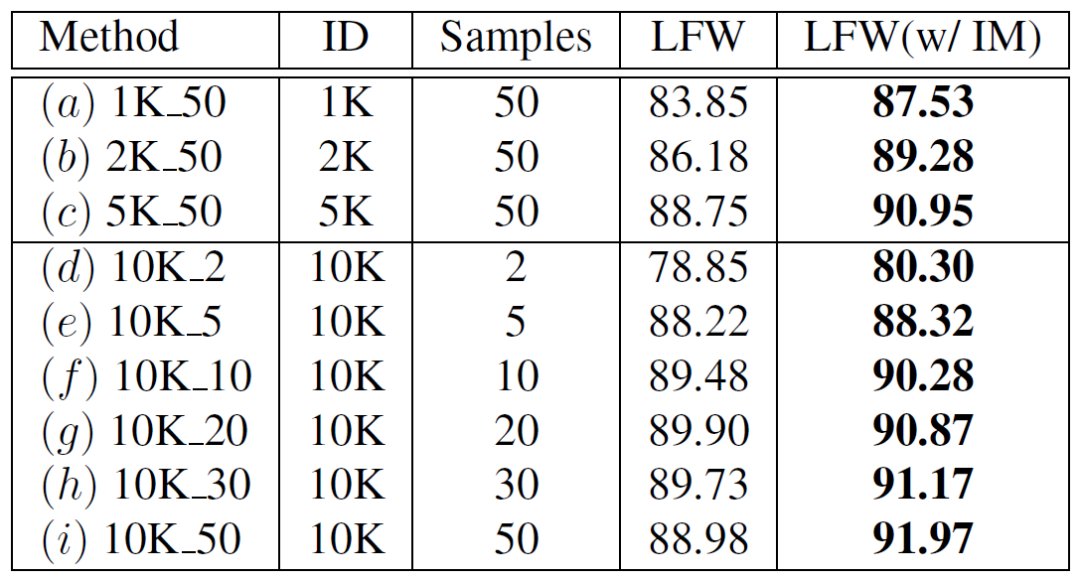
表3:生成数据集的宽度以及深度探索
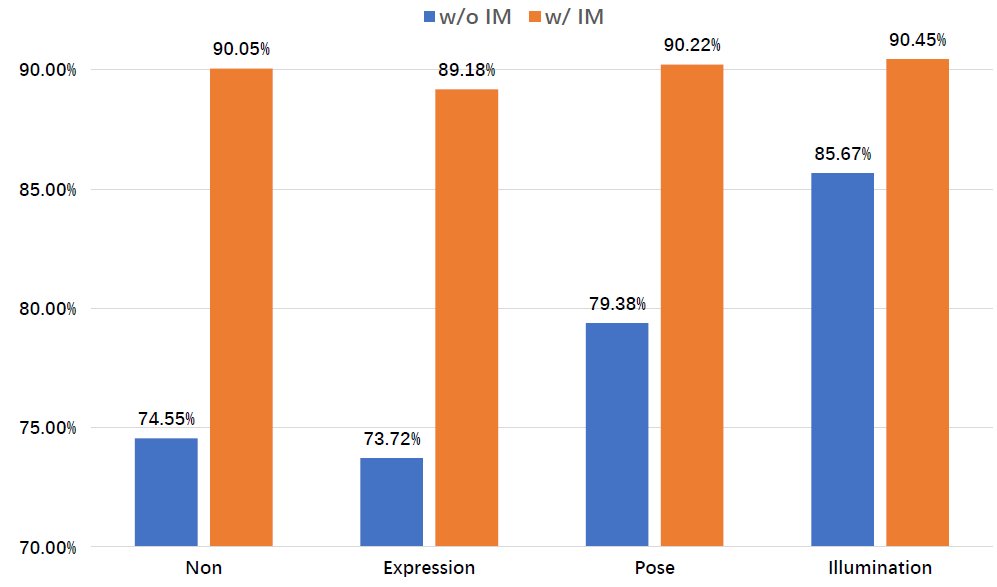
最后我们分析了生成人脸各个特性(即表情,姿态和光照)的影响,我们通过保持其他特性不变,只改变当前探索的特性。比如Expression就是该类内保持其他姿态和光照等不变,只变化表情得到的生成数据,它们训练得到的模型准确率参见图6. 可以看到什么都不变(Non)和只变表情取得了最差的结果,这是因为这里生成的表情种类十分有限,基本上是微笑,故而可以等价成什么都不变。改变姿态和光照取得了巨大提升,这可能是因为测试数据集中的姿态和光照变化非常大的缘故。同样地,引入IM带来了稳定的提升,并且都达到了相似的准确率。潜在的原因是IM可以被视作为一种很强的数据增强,减少了各个特性对最终准确率的影响。
图6:生成人脸不同特性的对比实验
在本文中我们探索了如何利用生成仿真的人脸数据来有效地训练人脸识别模型。通过相关实验结果对比分析,我们提出Identity Mixup来增加生成数据的类内距离,并引入Domain Mixup进一步缩小生成数据与真实数据的领域差异,两者皆大幅度地提升了识别准确率,极大地缩小了与真实数据训练所得到模型的差距。此外我们对于人脸的不同特性进行了系统性分析,揭示了训练数据集的深度与宽度对于最终识别率都有很大影响,随着两者的增加,识别率也会随之上升,但是饱和情况会先出现在深度维度,即说明宽度更为重要。再者就是丰富姿态和光照的变化能使得生成数据更加接近真实数据,从而大幅度提升识别率。更多实验结果分析还请参见原论文。
[1] Yandong Guo, Lei Zhang, Yuxiao Hu, Xiaodong He, and Jianfeng Gao. Ms-celeb-1m: A dataset and benchmark for large-scale face recognition. ECCV 2016.[2] Ian Goodfellow, Jean Pouget-Abadie, Mehdi Mirza, Bing Xu, DavidWarde-Farley, Sherjil Ozair, Aaron Courville, and Yoshua Bengio. Generative adversarial nets. NeurIPS 2014.[3] Yu Deng, Jiaolong Yang, Dong Chen, Fang Wen, and Xin Tong. Disentangled and controllable face image generation via 3d imitative-contrastive learning. CVPR 2020[4] Ingwer Borg and Patrick JF Groenen. Modern multidimensional scaling: Theory and applications. Springer Science & Business Media, 2005.[5] Hongyi Zhang, Moustapha Cisse, Yann N Dauphin, and David Lopez-Paz. mixup: Beyond empirical risk minimization. arXiv preprint arXiv:1710.09412, 2017.扫码添加小助手微信(AIyanxishe3),备注ICCV2021拉你进群。
【 基于生成数据的人脸识别|ICCV 2021 | 准确率】雷锋网雷锋网雷锋网