
基于生成数据的人脸识别|ICCV 2021 | 准确率( 二 )
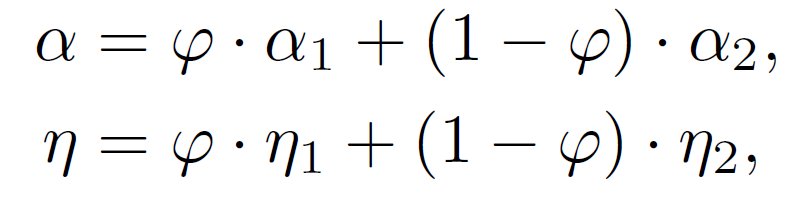
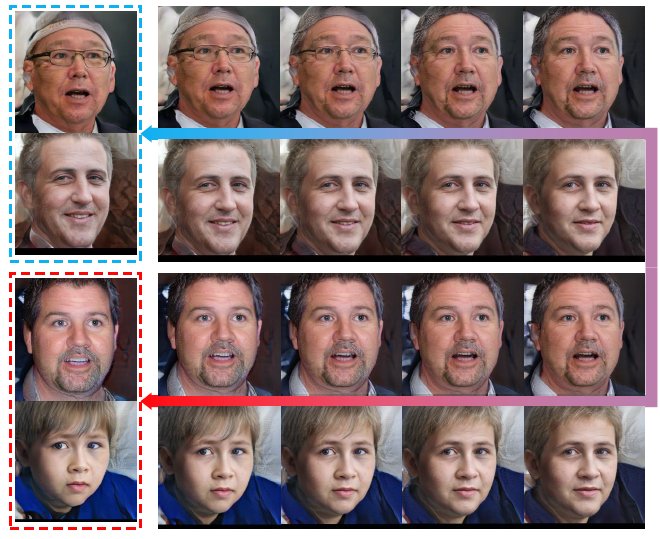
为了验证IM能够增大生成人脸数据的类内距离,我们可视化了三种不同程度(通过系数调节)IM后生成人脸的特征(参见图2)。我们可以看到从青色三角形到蓝色正方形,再到红色圆圈,它们的类内距离是逐渐增大的,相应的准确率也从88.75到89.47再到90.95,充分说明了IM能够增大类内距离从而来提高识别准确率。另外从表2也可以看到,加入IM后,识别准确率从88.98大幅度提升至91.97。后续的图5图6以及表3的实验结果也同样证明了IM的有效性。
Domain Mixup (领域混合)
为了进一步缩小用生成数据训练得到模型与真实数据得到模型之间的准确率差距,我们引入了Domain Mixup(DM)作为一种通用的domain adaptation(领域适应)的方法来缓解。具体来说,我们仅利用一小部分带有标注的真实数据加上大规模的生成数据,通过DM的方式来训练模型,DM具体数学形式参见公式2,和分别代表生成和真实的人脸图片,其对应的标签也随之线性改变。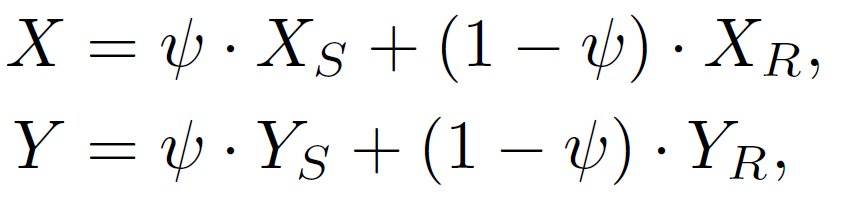
于是我们利用DM来混合真实与生成数据来进行模型训练,与只用真实数据训练模型得到的对比结果如表2. 可以观察得到,我们引入的DM能够极大且稳定地提升在各种不同设置下的准确率。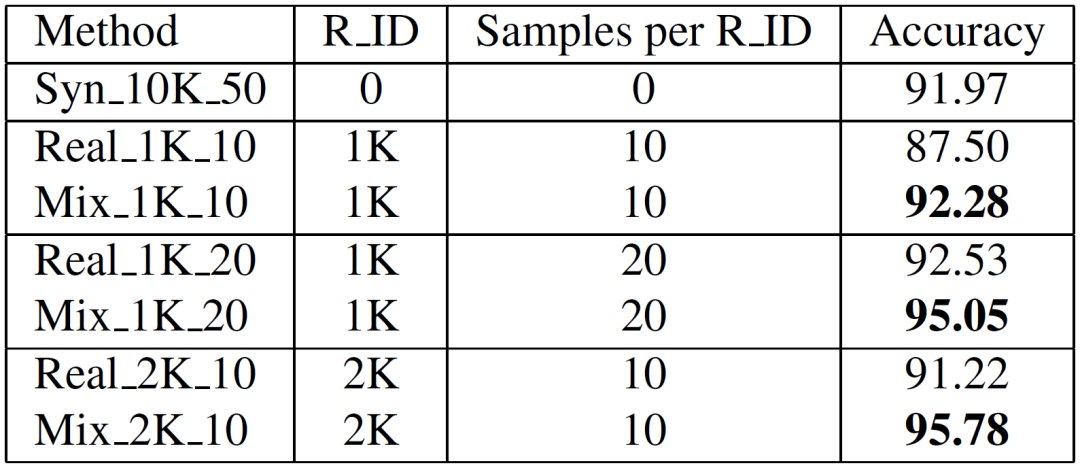
比如最后一组实验中,95.78相较于91.22的提升非常大。我们推测这是由于混合小部分真实数据能够给生成数据带来真实世界的外观信息比如模糊和光照等,如此一来缩小了两个领域的差异,进而提升了准确率。如果我们继续增加真实数据到2K_20,那么准确率可以从95.78进一步提升至97.65。整体流程图包括Identity Mixup以及Domain Mixup可参见图4.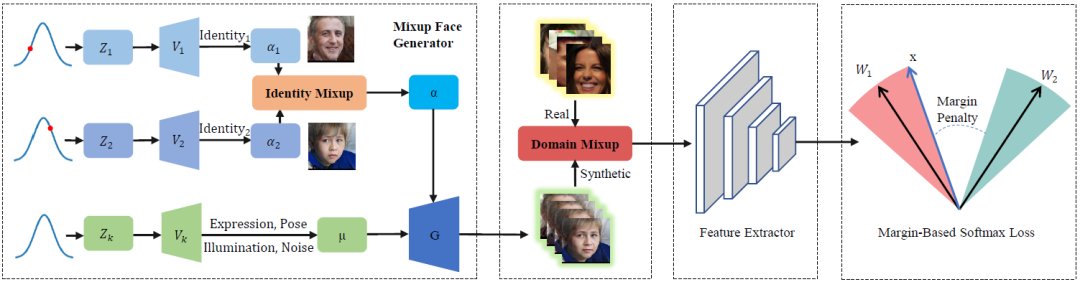
首先我们来分析长尾分布的问题,由于真实人脸数据基本都是从互联网上收集而来,导致某些类(人)拥有大量样本,某些类则只有少数几个样本,这样不平衡的分布训练得到的模型性能较差。我们控制生成数据每个类别样本数量来模拟这一问题,如图5, 2K_UB1到2K_UB2再到2K_50,它们的分布越来越平衡,可以看出它们对应的准确率也是逐步上升。通过控制生成数据的类别样本数量,我们可以天然地避免长尾分布带来的问题。此外通过引入Identity Mixup (IM),所有的设置都得到了大幅度的提升。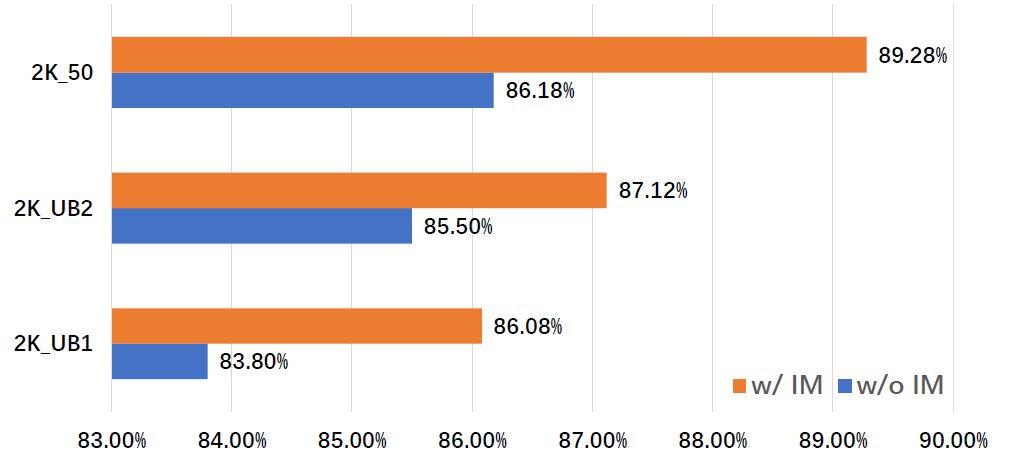
然后我们再来探索生成数据集的宽度(即类别数量)和深度(即类内样本数量)对识别准确率的影响,参见表3. 可以看到随着深度和宽度的增加,准确率都是逐步上升的。但是深度在达到20之后,准确率就开始出现饱和。另外我们通过观察(a)(e)可以看到,它们具有相同数量的总样本(50K),但是(a)极大地超过了(e),差距为4.37,说明了宽度相比深度承担了更重要的角色。另外通过引入Identity Mixup (IM),我们可以看到所有的设置都得到了很大地提升,再次说明了IM的有效性。
- One|基于Android 13打造:三星Galaxy S22抢先用上One UI 5.0
- 创业|八成互联网电视非法采集用户数据, 彩电企业怎么办?
- 新书推荐 │ 大数据算法设计与分析
- |一招教你入门数据可视化!
- 固态硬盘|PCI-E 4.0新选择,西部数据WD_BLCK SN770固态硬盘体验
- 原神|原神:说好数据互通的,为什么自己不能用电脑玩?多数人都没注意
- 客户端|多平台分析618数据,看清家居人未来方向!
- 芯片|芯片数据出炉!情况出现反转,美企们坐不住了
- 网络安全|数据安全的三大特性!重要性和意义!
- 海尔|唯品会京东的618数据中,一个“反常”现象被忽视了