为了克服这一挑战,科学家们开发了不同的方法来理解机器学习模型的决策过程。其中,一种主流的可解释性技术是生成显著图(saliency maps),它通过根据最终输出的贡献对输入数据的每个特征进行评分。例如,在图像分类器中,显著性映射将根据每个像素对机器学习模型输出的贡献进行评级。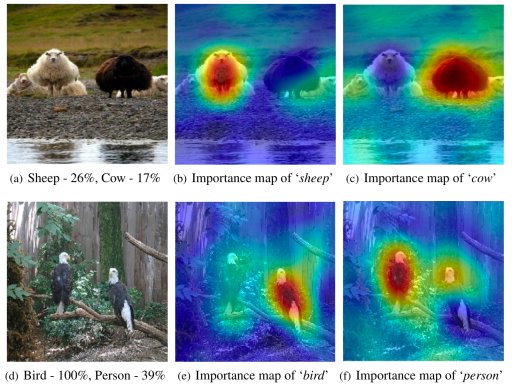
图注:Examples of 生成的显著性图借助该方法,CMU和KAIST研究人员提出的新技术的背后逻辑是:当图像受到对抗性扰动时,通过可解释性算法运行图像可产生异常结果。卡内基梅隆大学博士Gihyuk Ko表示,“我们的研究是从简单观察开始的,即在输入中加入小噪声会导致它们的解释产生巨大的差异”。根据解释图(explanation maps)检测对抗性示例分为以下几个步骤。首先,利用“检查器网络(inspector network)”和可解释性技术为用于训练原始机器学习模型的数据示例生成显著性图。然后,使用显著性映射来训练“重建网络”,重建目标模型将对每个决策给出解释。目标模型有多少输出类,就有多少个重构器网络。例如,如果该模型是手写数字的分类器,它将需要十个重建网络,每个数字一个。每个重构器都是一个自动编码器网络,每个输入的图像都会生成一张对应的解释图。例如,如果目标网络将输入图像分类为“4”,则图像将通过类“4”的重建器网络运行,并生成该类“4”对应输入的显著性映射。以上是构造器网络训练一个良性示例的过程。如果攻击者向构造器提供对抗性示例,可能会引起输出的异常,而这会帮助研究人员发现受到攻击干扰的图像。如下图所示,实验表明异常解释图在所有对抗性攻击技术中都非常显著。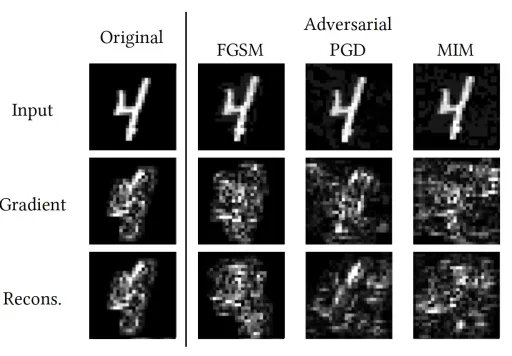
CMU团队认为,该方法的主要优点是不受攻击的影响,而且不需要训练特定的对抗技术。“在我们的方法之前,有人建议使用SHAP签名来检测对抗性示例,”Gihyuk Ko表示,然而,所有现有的方法在计算上都是昂贵的,因为它们依赖预生成的对抗性示例来分离正常示例和对抗性示例的SHAP签名。相比之下,无监督方法不需要预训练生成对抗性示例,因而在计算成本上更有优势。此外,它还可以推广到一些未知攻击(即以前未训练过的攻击)。例如,研究人员已经在MNIST数据集上测试了该方法。MNIST是一个手写数字数据集,经常用于测试不同的机器学习技术。他们的发现,无监督的检测方法能够检测各种对抗攻击,并且性能表现远超其他已知方法。“虽然MNIST数据集相对简单,但该方法也适用于其他复杂的数据集,”Gihyuk Ko说,不过他也承认,从复杂数据集中训练深度学习模型并获得显著性图要困难得多。未来,他们将在CIFAR10/100、ImageNet等更多复杂的数据集和复杂的对抗性攻击上测试该方法。总之,Gihyuk Ko认为,模型的解释性可以在修复脆弱的深度神经网络方面发挥重要作用。原文链接:https://bdtechtalks.com/2021/08/30/unsupervised-learning-adversarial-attacks-detection/【 示例|对抗样本无法被重建!CMU提出通用的无监督对抗攻击检测方法】
