
没有图纸,机器人也会搭积木桥|IROS 2021 | 积木( 二 )
状态:环境中所有物体的6自由度位姿(包括三维位置和三维旋转)、速度、尺寸;
动作:物体编号和目标位姿,它表示 blueprint policy 决定把该物体的位姿从当前状态变到目标状态;
转移关系:在物理引擎中先根据 blueprint policy 的动作,把选中的物体瞬移成动作中的目标状态,接着在重力作用下跑物理仿真,直到所有物体都稳定下来,物理引擎再把此时的状态作为转移到的新状态返回给 blueprint policy 。作者之所以让物理引擎继续模拟而不是直接返回瞬移结果,是因为 blueprint policy 指定的目标状态很可能在现实中没法稳定存在(比如积木悬浮在空中或者与其他物体有碰撞),通过物理仿真就能让 blueprint policy 知道什么样的状态是物理上可行的,帮助 blueprint policy 建立对物理规律的理解。
奖励信号:如果桥成功搭出来了,agent 会获得一个大的奖励信号。那怎么判断桥有没有成功搭起来呢?
本文沿着悬崖的中心连线均匀地采样若干个点,检查了每个采样点的上表面高度,如果所有采样点的高度都大于一定的阈值,就认为桥搭成功了。此外,agent 在建造的中途还可以获得一些比较小的奖励信号:当部分采样点的高度到达阈值的时候,可以获得正比于这部分点占总点数比例的奖励。为了鼓励 agent 用尽量节省物料的方式搭出平整的桥,作者还在判断搭桥成功的基础上给用物体少的桥和平整的桥额外的奖励。agent 收到的奖励信号是上面所有项的加和。
设计桥梁的策略学习
任务设定清楚之后,还要采用合适的策略网络结构和算法来解决它。Agent需要建立对环境中物体间的关系的理解,还需要具有一定的在不同数量物体之间泛化的能力。
为了更好地学习能在物体间泛化的策略,研究者采用了基于Transformer 编码器的网络结构来从场景中所有物体的状态提取特征。如图2左侧,把每一个物体的状态当作一个 token 来处理,将它们的嵌入表示 (embedding) 经过N个注意力块 (attention block) 处理,充分地建模物体与物体之间的关系信息,得到特征。之后再经过多个线性层得到策略网络 (policy) 和估值函数 (value) 输出。
作者采用 PPG (Phasic Policy Gradient,阶段策略梯度) 算法来训练 blueprint policy。PPG 是在 PPO (Proximal Policy Optimization,近端策略优化) 基础上提出的一种在线强化学习算法,它的长处在于能巧妙地将 value 网络学到的有用知识与 policy 网络共享,使得强大的 Tranformer encoder 同时惠及 policy 和 value 网络。PPG 有 "shared" 共享和 "dual" 非共享两种实现架构,其中 shared 架构中 policy 和 value head 共享了 feature extractor 的参数,而dual架构不共享 参数。
PPG的技术细节可以参考原文,在此不再展开。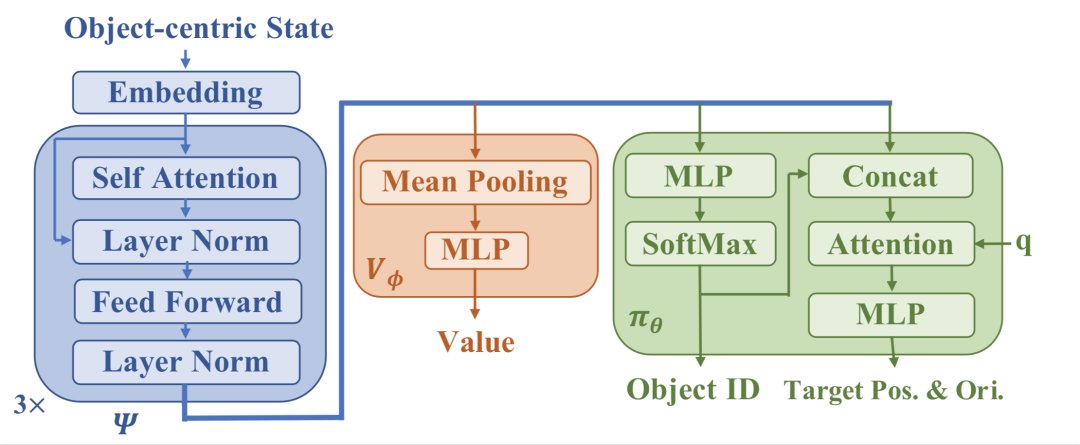
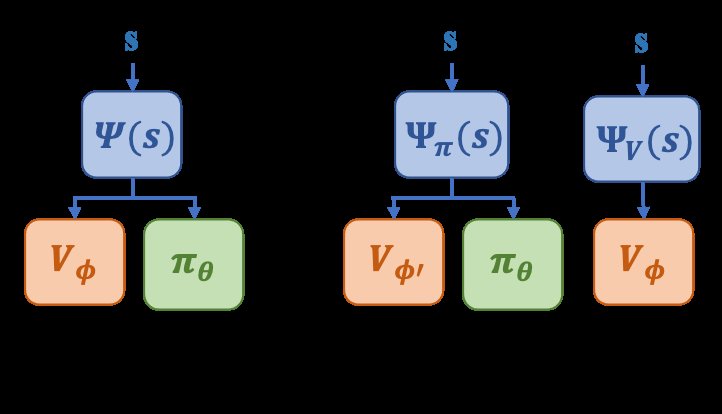
图2: Blueprint policy网络结构
虽然该文的目标是希望机器人能用很多积木搭出复杂的桥,但在训练初期 agent 水平很低的时候就提供这样的任务对它来说太困难了,就如同强行让小学生啃大学教材;因此我们采用了自适应的课程 (curriculum) 来调节训练任务的难度。最开始悬崖之间的距离是从整个任务分布中均匀采样的,有的很近有的很远;随着搭桥成功率渐渐提升,会逐渐增大采样到较远的悬崖距离的概率。
机械臂控制策略实现
机械臂底层控制策略负责用 pick and place 来完成 blueprint policy 设定的每一步目标,真正地用机械臂移动积木。研究者使用了传统的 motion planning 算法做六自由度抓取(包含抓取的三自由度位置和三自由度旋转),完成 pick and place 任务。
- 36氪首发|烹饪机器人公司「智谷天厨」获数千万元天使轮融资,羲融善道独家投资
- 位于广东省阳江市的海陵岛自然资源丰富,景色优美,该岛没有 神奇海洋6月28日答案
- 水洞中发现玛雅人残骸,可能并没有消失,或揭开玛雅消失之谜!
- 三星|没有人会在意你用的是索尼A9二代还是一代,靠作品说话
- 世界上最孤独的“手”,他握住一棵树长达50年,却从来没有松过手
- 机器人|华为机器人新专利上线 网友:先有华为后有天开上鸿蒙如升仙
- 第六届全省中小学生互联网+机器人设计活动决赛顺利结束
- 旗舰机|旗舰机的更新对于任何一家厂商都没有难度,但入门级,还得看绿厂
- Java|李佳琦消失扯下阿里“遮羞布”,原来淘宝根本就没有护城河
- “文旅机器人小i”上岗