
特斯拉|自研全球第一超算,特斯拉看到了自动驾驶的未来
如果你是一名科技爱好者,或许不会对“富岳”这个名字感到陌生。
“富岳”是什么?它是一台算力高达44.201 TFlops(万亿次运算每秒)的超级计算机。算力相当于IBM旗下Summit超算的三倍,相当于我国“神威·太湖之光”超算的近五倍。
那么“富岳”是目前全球最快的超算吗?昨天还是,但今天(2021年8月20日)它就已经丢掉了这个名号。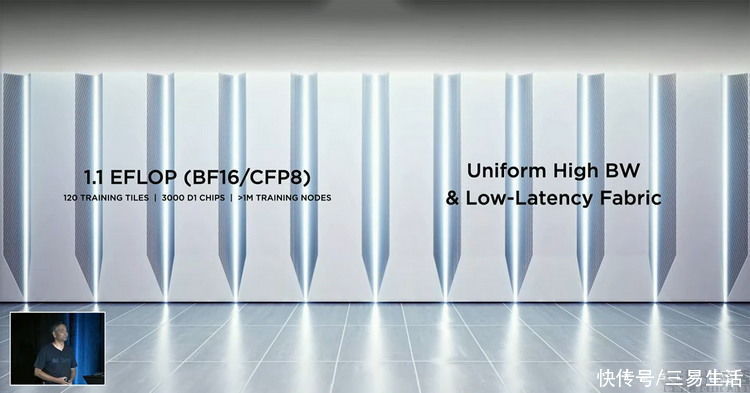
因为就在今早,大家熟悉的新能源车企特斯拉,正式发布了他们的自研AI超算ExaPOD,其算力达到了1.1EFlops(百亿亿次运算每秒),相当于“富岳”的近两万五千倍。与此同时,与此前计划中的全球首台E级超算相比,突然登场的它更是比对手足足早了两年。
最为重要的是,其处理器使用的也是特斯拉的自研方案。也就是今天与ExaPOD同台亮相的AI训练芯片——D1。
造车的特斯拉,做出了当前最强的AI加速方案
对于AI行业的从业者来说,NVIDIA的RTX A6000可能是目前能买到性能最强的AI加速卡。其基本上可以被视作一块“增强版”的RTX3090,在628mm2的芯片面积上实现了高达31.29TFlops的半精度浮点算力。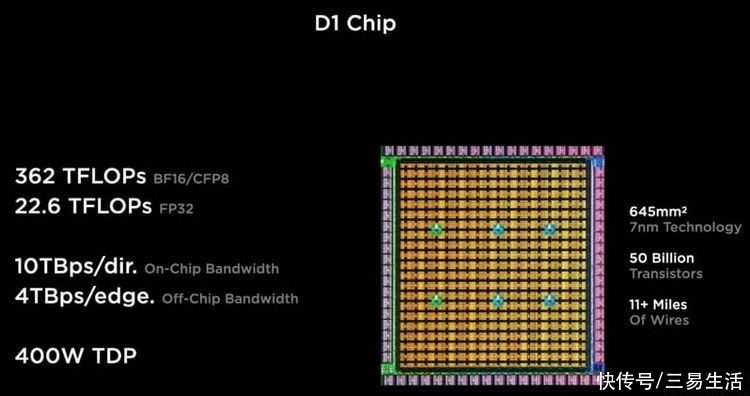
然而即便是最强AI加速卡,在今天发布的特斯拉D1面前也成为了“弟弟”。因为D1在相近的芯片面积(645mm2)上,塞进了500亿颗晶体管,实现了高达362TFlops的半精度算力。
也就是说,特斯拉的自研AI服务器芯片一“出世”,就达到了竞争对手10倍以上的单芯片性能。
正因为特斯拉的这款自研芯片本身单个性能就非常恐怖,所以只需要使用3000颗D1芯片互联,特斯拉就轻松地端出了当前全球算力最高的超级计算机,同时也是性能最强的AI训练设备——ExaPOD。
特斯拉的超算为何很强?架构和用途是关键因素
那么问题就来了,为什么特斯拉的D1以及基于D1的ExaPOD超算,性能会这么强呢?
一方面,从特斯拉方面在此次活动中公布的信息不难看出,D1这颗芯片从最初研发的时候,就已经是以“用于组成超算”为前提,其“边缘”其实都是一个速度高达40TB/s的互联连接器。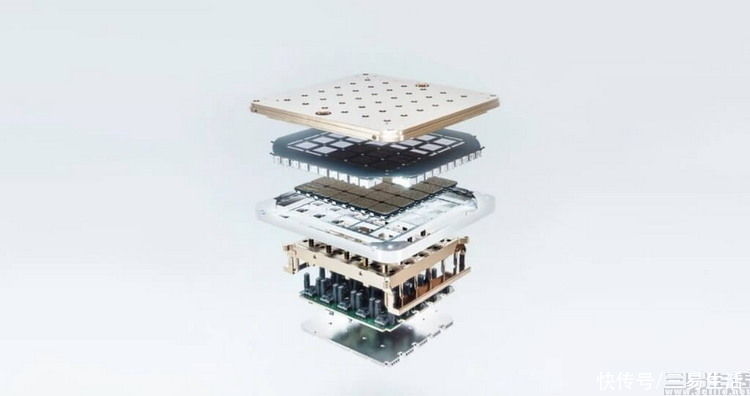
这就是Training Tile
所以D1芯片可以不需要依靠主板进行特殊设计,直接以“边对边”的形式就能紧凑地被连接在一起,形成一个由25颗D1芯片组成的模块式AI计算机“Training Tile”。而将多个模块再进行互联,就是AI计算矩阵“Training Matrix”。再将矩阵相互连接,就会构成一个规模上比ExaPOD要小一些的AI超算“DOJO”。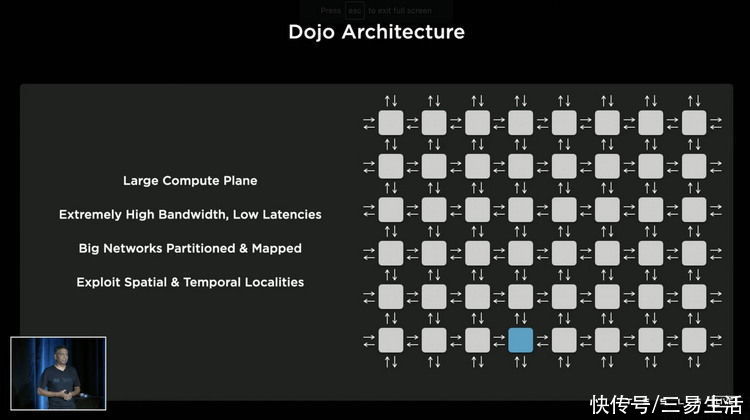
可以说,这种“四边连接”的设计使得D1芯片和基于它的计算设备,几乎可以“无脑”扩张规模,再加上其本身的单芯片性能就很高,所以堆出恐怖的总算力自然也就并不困难了。
但另一方面也必须要看到,特斯拉D1芯片的功能非常非常单一,它从一开始就是为AI计算而生,而且也只能用于AI计算,做不了别的事。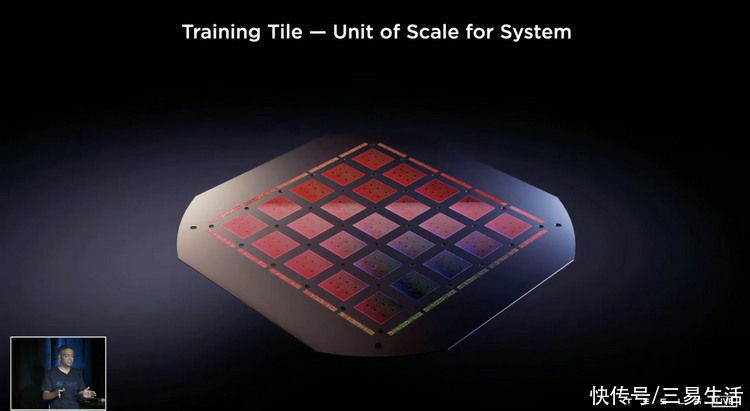
在这背后,其实涉及到了一个关于“超级计算机”的冷知识。那就是对于许多超级计算机来说,制造它们的团队其实未必需要超算,而是通过对外“出租”算力牟利。也就是说,A团队今天造了台超算,但它可能其实是要同时租给B、C、D、F……等等许多研究机构或企业使用。
- 喜马拉雅山出现的“雪人”是何生物?目击者:智商高、攻击性强
- 喜马拉雅发现新物种!科学家发现“雪人”遗物,令人感到意外
- 是恶作剧还是新物种?喜马拉雅山出现的“雪人”,到底是什么?
- 苹果|抢台积电3nm产能!苹果自研处理器M2 Pro/M3齐曝光 性能更强
- 摩托罗拉|价格屠夫上新!摩托罗拉新机入网:支持68W快充
- 疑似iQOO 10系列渲染图被曝:背部拼接设计辨识度拉满
- iqoo|iQOO 10系列搭载蓝厂自研V1 ISP芯片 有望首发天玑9000+新机版本
- 华为鸿蒙系统|意欲何为?国内两大科技巨头弃用华为鸿蒙,自研新系统
- 金字塔是时间机器?用途是拉伸和压缩时间,或能使生命延长和衰老
- 物联网|喜马拉雅首推短剧,音频平台入局微短剧赛道