
精准|预测模型,怎么做才够精准
编辑导语:在数据分析中,会碰到的一个终极难题就是“预测得不准!”那么,该怎么解决这一问题呢?作者分享了相关的方法,让预测模型做起来更加精准,我们一起来看下吧。
“预测得不准!”是数据分析领域的终极难题了。讲预测的算法有一大堆,然后遇到现实基本上都被锤成渣渣,业务方怎么都不满意。
到底该怎么破局?今天系统讲一下。
一、预测算法的本质从本质上看,预测算法只有2大类:
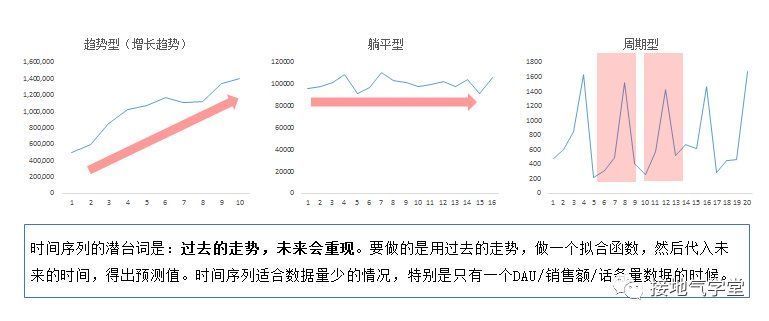
1. 基于时间序列的
- 平滑:用于相对平稳的数据。
- 自回归:用于趋势性递增、递减的数据。
- 带季节因素自回归:用于有周期性波动的数据。
2. 基于因果关系的
- 二分类问题:未来会/不会发生XX,典型如LR。
- 多分类问题:未来是ABC哪个情况,典型如决策树。
- 连续型问题:未来的数值是多少,典型如线性回归。
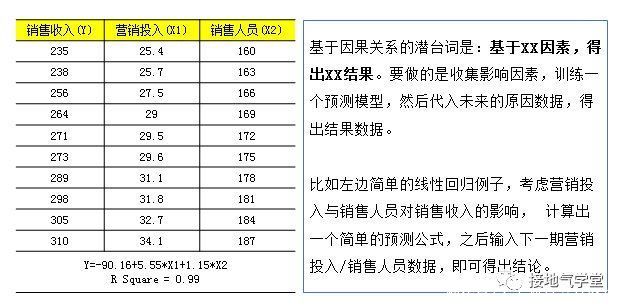
有可能建模的时候,不是一个模型包打天下,而是用二阶段建模。比如预测一个客群消费情况,可以分别用二分类模型预测会不会消费,再用连续型模型预测消费金额,这样会消费用户数*预测消费金额,就能得出总消费。这是典型的处理手法。
书本上都是这么教的,然而为啥一遇到现实就被锤成渣渣了呢?
二、预测算法的难点因为:书本为了突出模型效果,刻意选择了质量好、数据全的数据集。
现实中麻烦根本是远远不断:
- 没数据。很多时候给到的待预测数据,就一行“每月总消费”,其他数据屁都没有……
- 还是没数据。很多公司隔着天猫、抖音、亚马逊,拿不到一手数据,只能用后台导出的一点点数据瞎倒腾……
- 就是没数据。大部分公司不是头腾阿这种垄断公司,只拿了非常片面的数据。最常见的,大部分公司的用户是花钱引流来的,用户只有一个手机号+一个优惠订单……
这种结果一丢出来,一准被业务评价为:“都TM是废话,我早知道了!”
这就是现实中第二大麻烦:业务效果到底怎么衡量。
比如预测销量是1000万l业务做到900万,会说:预测得一点都不准,搞得货积压了。
业务做到1100万,会说:预测得一点都不准,还是我厉害
总之,只要你不是100%精准,他都有理由赖到你头上。甚至可以反复横跳。比如:“本来业务能达标的,看到预测说能达标,我们就省点投入,结果不达标了,都怪预测干扰了业务判断……”
怎么破局呢?问题既然由人而生,当然还得在人这里解决。避免赌命式预测,从业务场景角度出发,剔除人为影响,才是破题关键。
三、用业务运作避免预测错误有些场景,能通过业务操作直接把问题消灭掉。这时候就直接用业务手段,不要建模。
比如:
场景1:“销售数据很少,分布很散,如何预测销量?因为货物本身不耐储藏,多进货的话库存损失率会很高”——用团购呀!团购就是解决这个问题的。
场景2:“销售数据很少,少到无法计算价格弹性,业务方又想预测价格弹性,多赚钱”——用拍卖啊!拍卖就是干这个的。
- 零售业|2022年全球物联网PaaS市场现状及发展趋势预测分析(图)
- 淘宝|弘辽科技:淘宝商家必备技巧,快速精准选款测款
- 从几个月到几分钟,NLP模型运行效率暴涨,小公司也能玩大模型
- 腾讯文档|从事展览3d模型设计,你需要具备那些能力?---模大狮网
- 英伟达|NVIDIA Triton 推理引擎公开课上新:基于多实例 GPU 和 K8s 的大规模 CV 模型部署实践
- 事件:今日(6月22日)|郭明錤:quest2pro市场预测
- 肠道菌群|肠道菌群又有新“用途”:建立非酒精性脂肪肝发病预警模型
- 细胞|我科研团队发明幽门螺杆菌单细胞精准诊疗技术
- 古人是如何知道时间的?他们对月亮的精准判断,超越人类科技
- aiXcoder XL智能编程大模型发布:自然语言一键生成方法级代码