
机器|AI“读图会意”首超人类!阿里达摩院刷新全球机器视觉问题纪录( 二 )
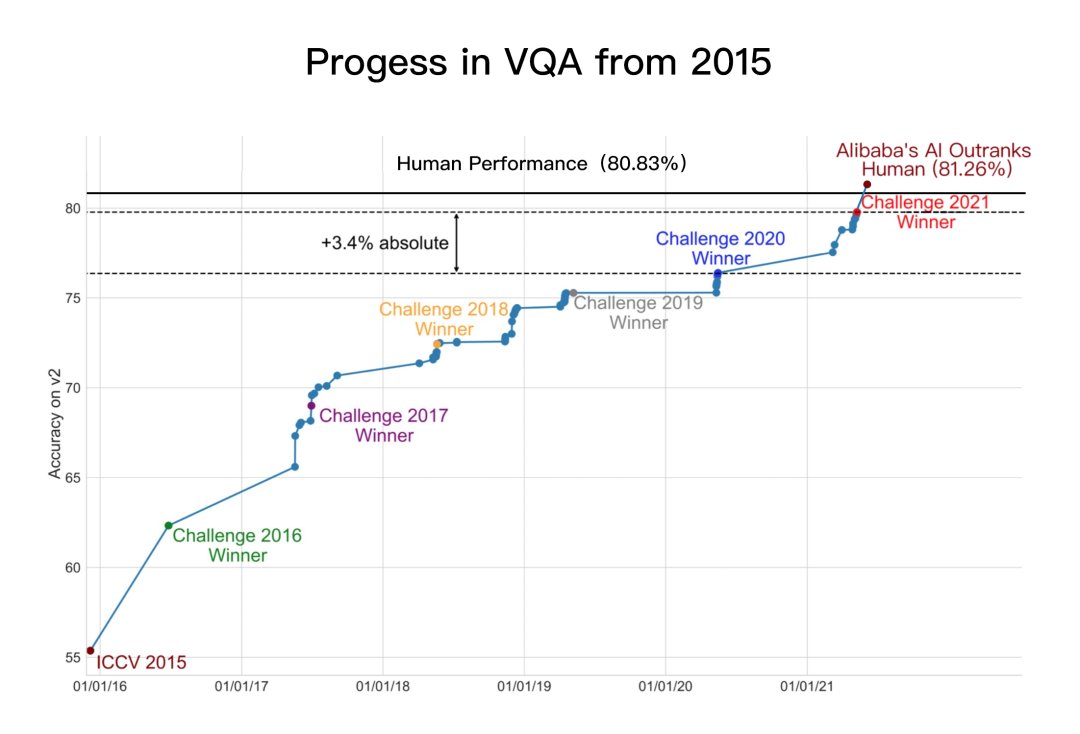
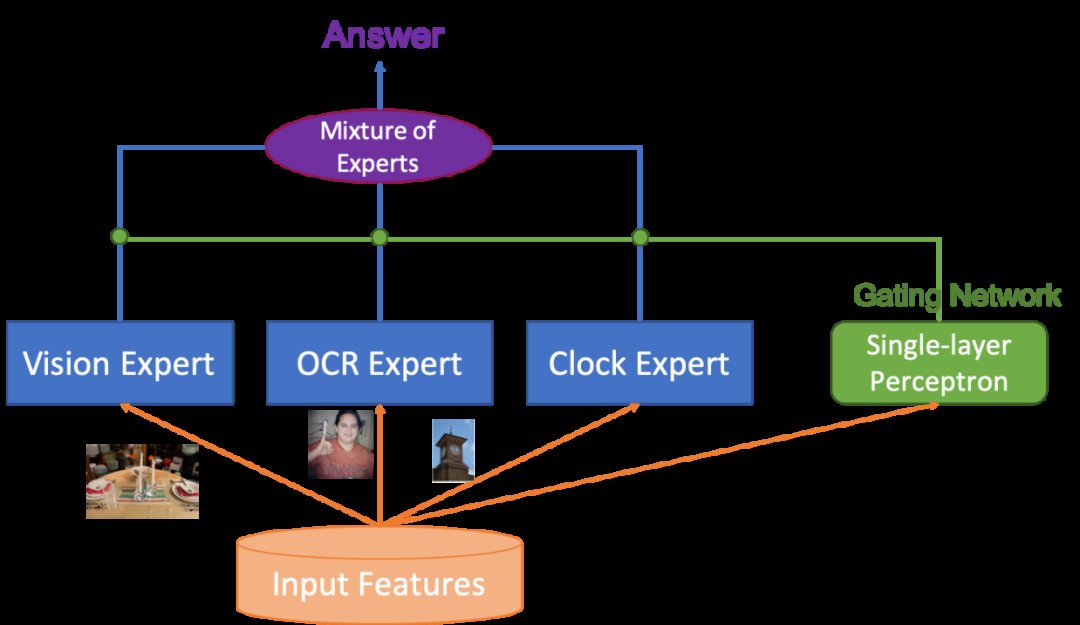
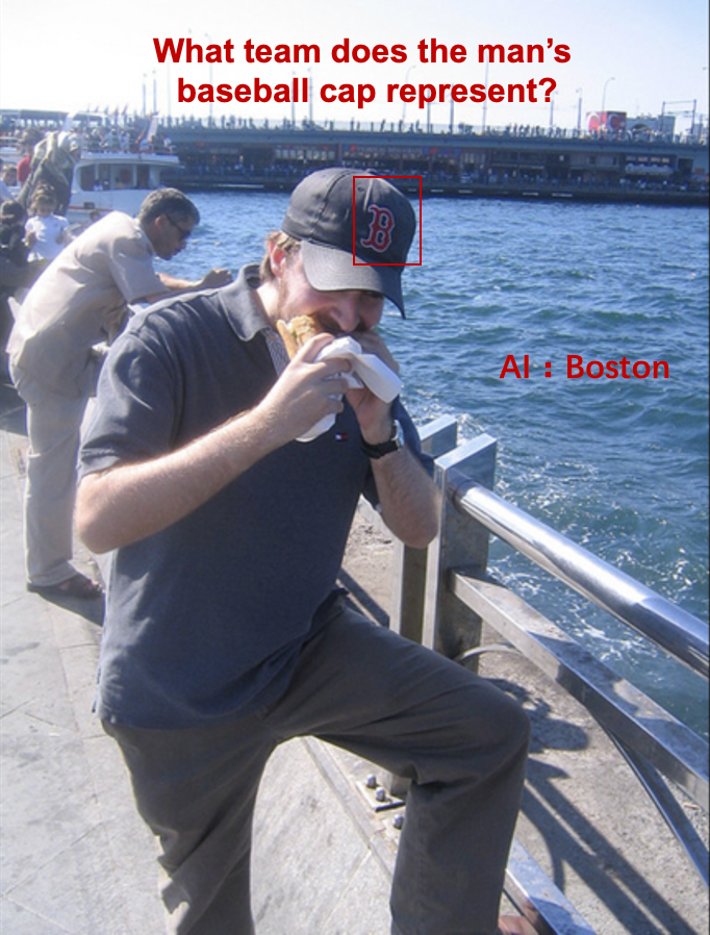
VQA挑战的核心难点在于,需在单模态精准理解的基础上,整合多模态的信息进行联合推理认知,最终实现跨模态理解,即在统一模型里做不同模态的语义映射和对齐。
据了解,为了解决VQA挑战,达摩院语言技术实验室及视觉实验室对AI视觉-文本推理体系进行了系统性的设计,融合了大量算法创新,包括:
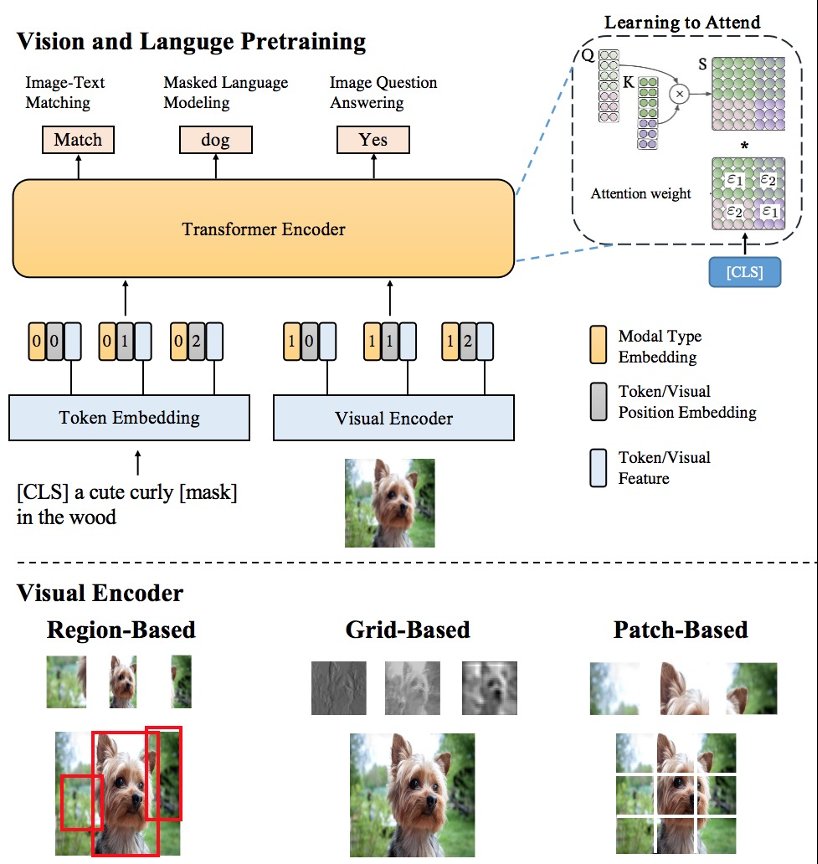
多样性的视觉特征表示,从各方面刻画图片的局部和全局语义信息,同时使用Region,Grid,Patch等视觉特征表示,以更精准地进行单模态理解; 基于海量图文数据和多粒度视觉特征的多模态预训练,用于更好地进行多模态信息融合和语义映射,创新性地提出了SemVLP,Grid-VLP,E2E-VLP和Fusion-VLP等预训练模型; 研发自适应的跨模态语义融合和对齐技术,创新性地在多模态预训练模型中加入Learning to Attend机制来进行跨模态信息地高效深度融合;
其中自研的多模态预训练模型E2E-VLP,StructuralLM已被国际顶级会议ACL2021接受。
模型大图如下:
- 36氪首发|烹饪机器人公司「智谷天厨」获数千万元天使轮融资,羲融善道独家投资
- 苹果|华为新一代“小方表”来了:Watch FIT 2正式官宣
- 纸质表格|“数字化”助推火箭升空
- 炸锅|酷暑之下,莫让这些谣言再增“热”度
- 户外|“小眼镜”增多 专家支招教你科学用眼
- 单项冠军|再添三家“小巨人”,青岛高新区梯度培育见成效
- 陨石|小行星“打水漂”闯入地球 形成世界最长陨石陨落带
- 科技入黔|“科技入黔”助力贵州高质量发展
- 踩线|主播不“踩线” 直播才有未来
- 套餐资费|广电放号 5G套餐竞争告别“三国时代”