
机器|AI“读图会意”首超人类!阿里达摩院刷新全球机器视觉问题纪录
AI 科技评论报道
编辑 | 陈大鑫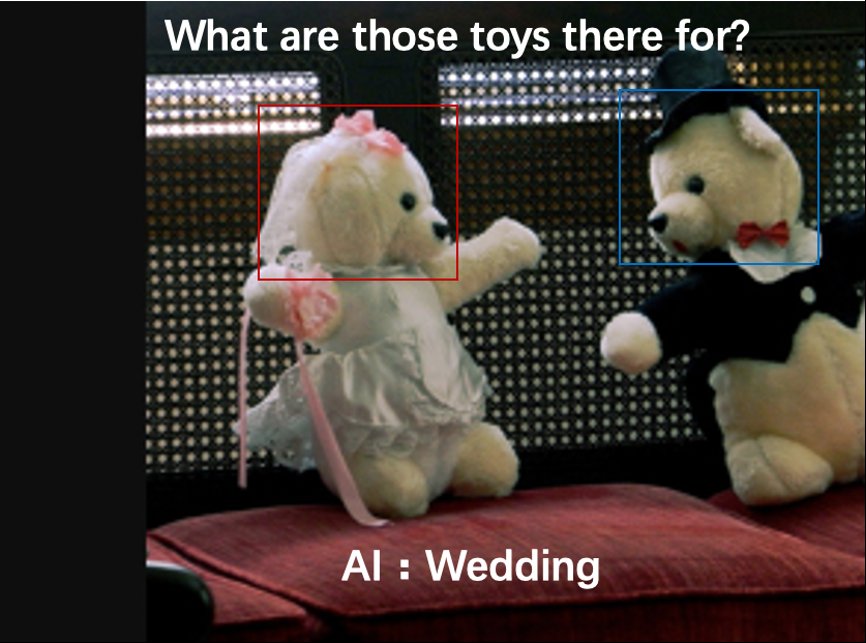
比较难得的是,3年前,让中国AI在文本理解领域历史性超越人类的,同样是达摩院AI研究团队。
近10年来,AI技术保持高速发展,AI模型已在多个任务和技能上达到超越人类的水平,比如在游戏领域,强化学习智能体 AlphaGo 2016 年击败了世界顶尖棋手李世石;在视觉理解领域,以 CNN 为代表的卷积类模型 2015 年在 ImageNet视觉分类任务上超越了人类成绩;在文本理解领域,2018年微软与阿里几乎同时在斯坦福SQuAD挑战赛上让 AI 阅读理解超越了人类基准。
然而,在视觉问答VQA(Visual Question Answering)这一涉及视觉-文本多模态理解的高阶认知任务上,AI 过去始终未取得超越人类水平的突破。
“诗是无形画,画是有形诗。”宋代诗人张舜民曾如此描绘语言与视觉的相通之处。随着深度学习、视觉理解、文本理解等领域高速发展,自然语言技术与计算机视觉交融逐渐成为多模态领域重要的前沿研究方向。其中,VQA是多模态领域挑战极高的核心任务,解决VQA挑战,对研发通用人工智能具有重要意义。
为鼓励攻克这一难题,全球计算机视觉顶会CVPR从2015年起连续6年举办VQA挑战赛,吸引了包括微软、Facebook、斯坦福大学、阿里巴巴、百度等众多顶尖机构参与,形成了国际上规模最大、认可度最高的VQA数据集,其包含超20万张真实照片、110万道考题。
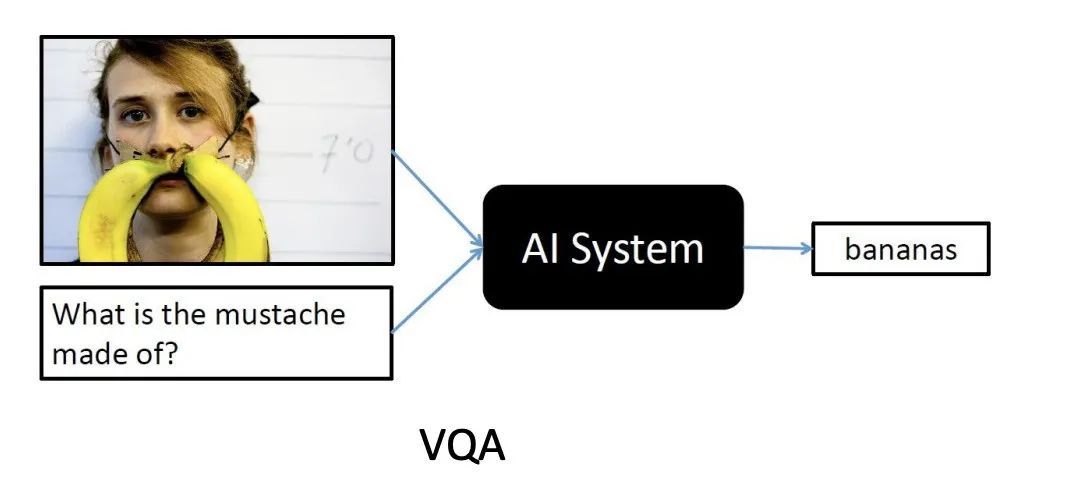
VQA 是AI领域难度最高的挑战之一。在测试中,AI需根据给定图片及自然语言问题生成正确的自然语言回答。这意味着单个AI模型需融合复杂的计算机视觉及自然语言技术:首先对所有图像信息进行扫描,再结合对文本问题的理解,利用多模态技术学习图文的关联性、精准定位相关图像信息,最后根据常识及推理回答问题。
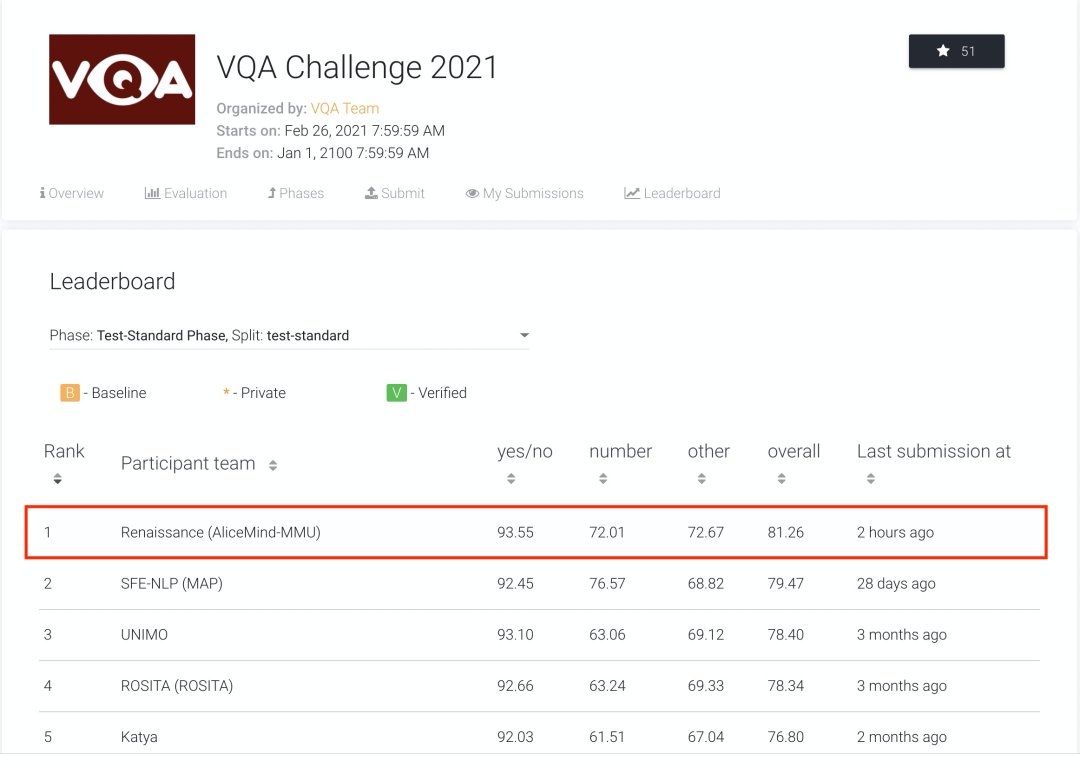
【 机器|AI“读图会意”首超人类!阿里达摩院刷新全球机器视觉问题纪录】今年6月,阿里达摩院在 VQA 2021 Challenge 的55支提交队伍中夺冠,成绩领先第二名约1个百分点、去年冠军3.4个百分点。两个月后,达摩院再次以81.26%的准确率创造VQA Leaderboard全球纪录,首次超越人类基准线80.83%。
这一结果意味着,AI 在封闭数据集内的 VQA 表现已媲美人类。
面对更开放的现实世界,AI一定会遇到新的挑战,需要喂更多的数据、进一步提升模型。但和 CV 等领域的发展一样,这一结果依然具有标志性意义,相信VQA技术在现实中的表现提升只是时间问题。
- 36氪首发|烹饪机器人公司「智谷天厨」获数千万元天使轮融资,羲融善道独家投资
- 苹果|华为新一代“小方表”来了:Watch FIT 2正式官宣
- 纸质表格|“数字化”助推火箭升空
- 炸锅|酷暑之下,莫让这些谣言再增“热”度
- 户外|“小眼镜”增多 专家支招教你科学用眼
- 单项冠军|再添三家“小巨人”,青岛高新区梯度培育见成效
- 陨石|小行星“打水漂”闯入地球 形成世界最长陨石陨落带
- 科技入黔|“科技入黔”助力贵州高质量发展
- 踩线|主播不“踩线” 直播才有未来
- 套餐资费|广电放号 5G套餐竞争告别“三国时代”