
基于相似样本检索的在线更新机器翻译系统|EMNLP 2021 | 样本( 三 )
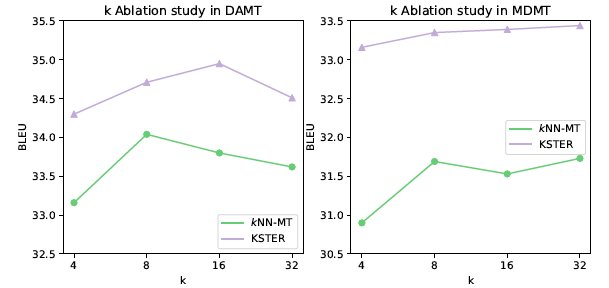
图8 检索不同数量样本 k 时,kNN-MT 和 KSTER 的翻译效果
图9 验证了检索丢弃这种训练策略的必要性。在不使用检索丢弃策略时,KSTER模型产生了严重的过拟合。而使用检索丢弃策略后,过拟合的现象得到明显缓解。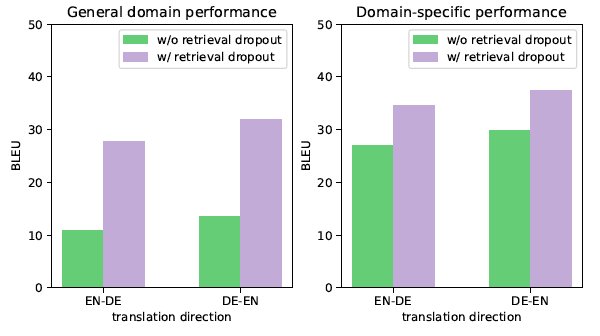
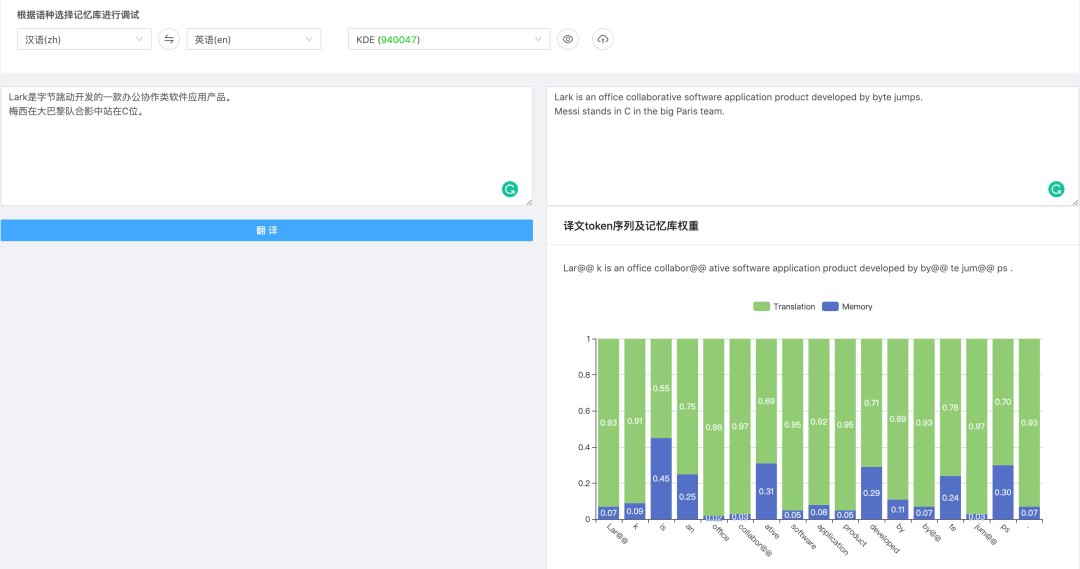
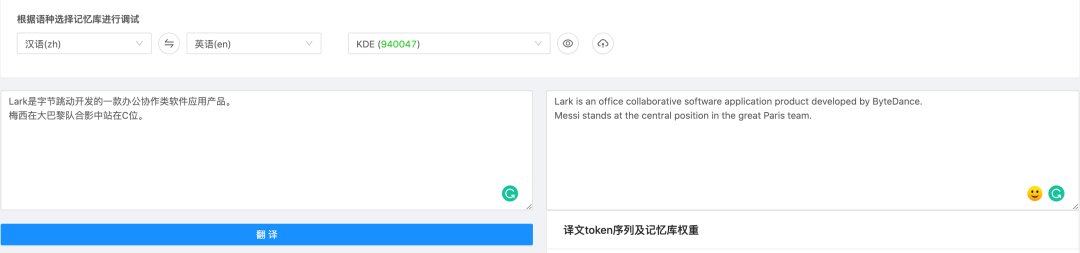
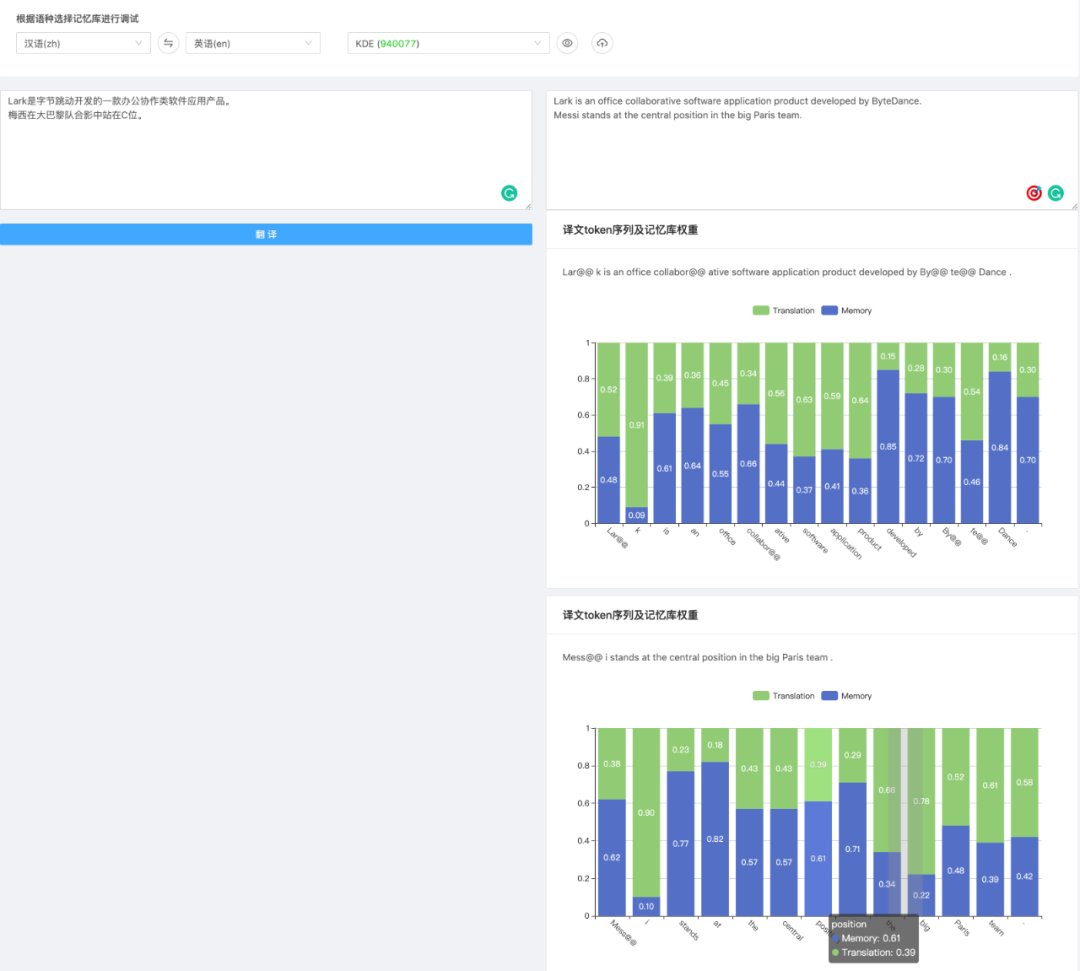
如 图10 所示,由于训练数据中没有出现过“字节跳动”这种新兴实体,以及“C位”这类新词,翻译系统对它们的翻译效果是不好的。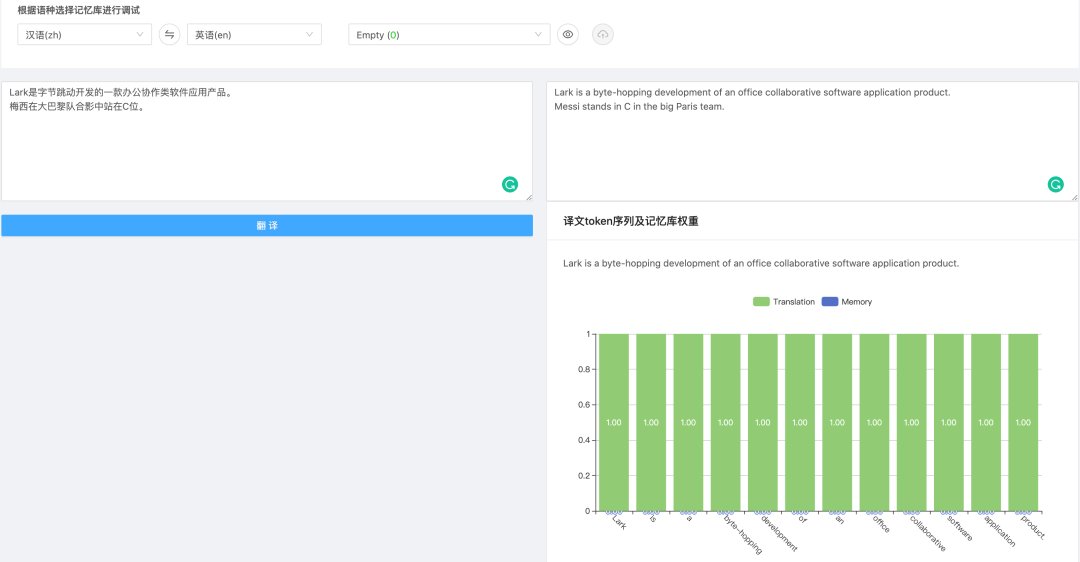
- One|基于Android 13打造:三星Galaxy S22抢先用上One UI 5.0
- 大脑和宇宙两者本质相同?为何它们结构如此相似?细思极恐(下)
- 英伟达|NVIDIA Triton 推理引擎公开课上新:基于多实例 GPU 和 K8s 的大规模 CV 模型部署实践
- 苹果|澳大利亚成功制造了可控光流组件,基于光的通信设施将迎来革新
- 致远互联|跨时空协作的利器——基于生命周期管理的基础设施BIM平台
- 基于深度学习的点云分割网络及点云分割数据集
- OPPO|杀后台问题有救了!OPPO新系统曝光:基于Android 13
- 基于Android 13定制 OPPO ColorOS 13曝光:彻底解决杀后台问题
- 三星计划在2025年开始大规模生产基于GAA的2nm芯片
- Java|基于java的格式转换word 转 pdf、word 转图片等