
数据|风控中必做的数据分析( 二 )
在这,申请流程假设为填写个人信息,再手机号认证,再人脸识别,再进行强规则审批,再到模型审批,通过之后再绑卡,后进行借款。这套流程设计控制了客户转化链路,审批前除必要的信息外,绑卡操作进行了后置,尽量减少转化损失。
这个漏斗分析很容易就可以计算出来,我们可以区分关注的渠道,在贷前场景中我们一般很关注不同渠道的转化情况,以便对渠道进行优化。转化链路还可以往后追加。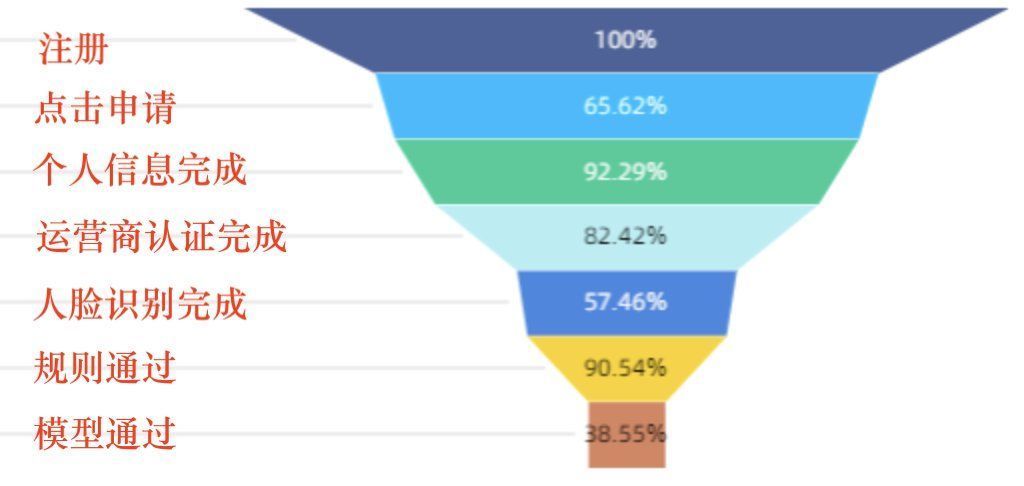
你的产品形式也许需要关注的点会和上面有所差异,但思路应该没有区别。漏斗转化能帮助你了解到用户容易在什么环节发生流失。转化流和行业一般情况做对比,就可以快速了解你的产品设计有没有大的问题。
不同时期业务的重心可能不同,需要关注的转化也可能不同。
三、前端分析前端指的是用户在申请时就可以统计得到的数据,例如申请量、通过率、PSI、CSI 和拒绝瀑布流等,漏斗分析一般也是前端分析。
申请流量和质量的变化,可以关注到天的粒度,甚至可以是小时的粒度。一张折线图就可以表现出来,不同渠道可以放在同一张图里方便对比。用户质量可以通过模型分的分布或者查询的重要变量的分布衡量出来,如多头、收入等。
PSI是群体稳定性指标(Population Stability Index),刻画了不同期样本在各分数段分布的稳定性。每个月申请流量的评分分布差异大不大,直接影响了决策结果的分布。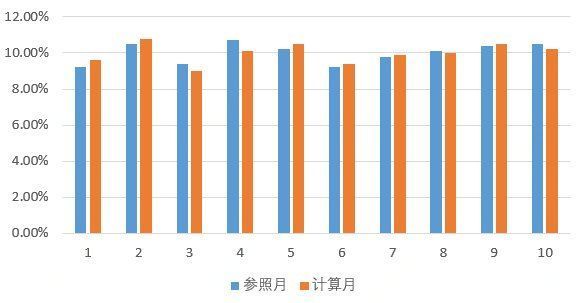
CSI是特征稳定性指标(Characteristic Stability Index),用来衡量特征层面的变化。PSI 对应模型分,CSI 对应特征变量。特征有时候不像模型分能分布地那么开,像性别就只有男、女,如果还有未知,也就三种。
因为模型分是由特征经过一套算法流计算出来的,模型分是一系列特征的表现。PSI 异常的话,必然是某个或者某些特征发生异常,通过 CSI 分析就可以定位到哪些特征出现了问题。后续就是针对性排除原因。
在申请环节,拒绝是一个瀑布流的过程。反欺诈拒绝的人,不用往后进入到政策审批环节,政策拒绝也不用在考虑模型拒不拒绝,因而这个流程可以统计出来,以监控拒绝瀑布流的稳定性。
四、后端分析后端指的是用户在申请时,你无法得知,需要后延一个表现期才能计算得到的数据,例如逾期率、模型效果等。表现期可长可短,也可以是首逾,取决于具体的业务目标和数据情况。
逾期率,各家定义可能不太一样,例如当季逾期贷款剩余本金/当季度放款总剩余本金,可以用来从横向比较一下坏账的波动。对于模型层面,逾期率往往指的是坏用户占比,是人数而非金额的比例。
这个指标计算是需要经过一个时间窗口的,今天的用户会是什么风险,需要以后才能知道。这也就是为什么前端分析很重要了,申请通过用户的质量通过模型分和重要特征分布已经进行了一轮刻画了。当然,这些前端信息并不能完全衡量出后端的风险。
Vintage分析是反映不同账龄周期用户的风险情况,直白地说,是各个时间阶段(如月份)申请人在往后各个账龄下有没有出现过 M1+逾期(或其他)的统计结果。
vintage 分析把不同期的样本放在了一起,可以用来观察不同期客群风险的变化,然后确定是流量本身的变化,还是宏观形形势的变化,还是风控策略的变化等等。
另外,vintage 最常见的用途是确定表现期,因为你观察到了各个账龄下的风险表现,取一个合适的账龄长度就有据可循了。
- 创业|八成互联网电视非法采集用户数据, 彩电企业怎么办?
- 新书推荐 │ 大数据算法设计与分析
- |一招教你入门数据可视化!
- 固态硬盘|PCI-E 4.0新选择,西部数据WD_BLCK SN770固态硬盘体验
- 原神|原神:说好数据互通的,为什么自己不能用电脑玩?多数人都没注意
- 客户端|多平台分析618数据,看清家居人未来方向!
- 芯片|芯片数据出炉!情况出现反转,美企们坐不住了
- 网络安全|数据安全的三大特性!重要性和意义!
- 海尔|唯品会京东的618数据中,一个“反常”现象被忽视了
- 数据资产管理和数据治理是什么关系?