
国科大|国科大提出首个CNN和Transformer双体基网模型 准确率高达84.1%
来源:arxiv 编辑:好困 Priscilla
【导读】Transformer和CNN在处理视觉表征方面都有着各自的优势以及一些不可避免的问题。因此,国科大、鹏城实验室和华为研究人员首次将二者进行了融合并提出全新的Conformer模型,其可以在不显著增加计算量的前提下显著提升了基网表征能力。论文已被ICCV 2021接收。卷积运算善于提取局部特征,却不具备提取全局表征的能力。
【 国科大|国科大提出首个CNN和Transformer双体基网模型 准确率高达84.1%】为了感受图像全局信息,CNN必须依靠堆叠卷积层,采用池化操作来扩大感受野。
Visual Transformer的提出则打破了CNN在视觉表征方面的垄断。
得益于自注意力机制,Visual Transformer (ViT、Deit)具备了全局、动态感受野的能力,在图像识别任务上取得了更好的结果。
但是受限于的计算复杂度,Transformer需要减小输入分辨率、增大下采样步长,这造成切分patch阶段损失图像细节信息。
因此,中国科学院大学联合鹏城实验室和华为提出了Conformer基网模型,将Transformer与CNN进行了融合。
Conformer模型可以在不显著增加计算量的前提下显著提升了基网表征能力。目前,论文已被ICCV 2021接收。
论文地址:https://arxiv.org/abs/2105.03889
项目地址:https://github.com/pengzhiliang/Conformer
此外,Conformer中含有并行的CNN分支和Transformer分支,通过特征耦合模块融合局部与全局特征,目的在于不损失图像细节的同时捕捉图像全局信息。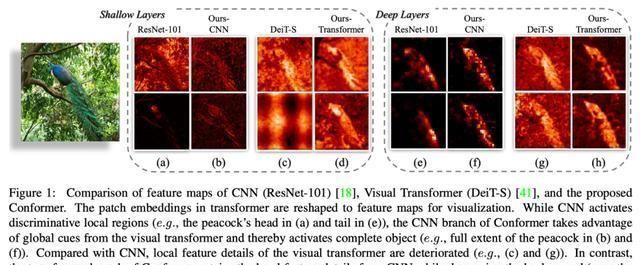
特征图可视化
对一张背景相对复杂的图片的特征进行可视化,以此来说明Conformer捕捉局部和全局信息的能力:
- 浅层Transformer(DeiT)特征图(c列)相比于ResNet(a列)丢失很多细节信息,而Conformer的Transformer分支特征图(d列)更好保留了局部特征;
- 从深层的特征图来看,DeiT特征图(g列)相比于ResNet(e列)会保留全局的特征信息,但是噪声会更大一点;
- 得益于Transformer分支提供的全局特征,Conformer的CNN分支特征图(f列)会保留更加完整的特征(相比于e列);
- Transformer分支特征图(h列)相比于DeiT(g列)则是保留了更多细节信息,且抑制了噪声。
网络结构图
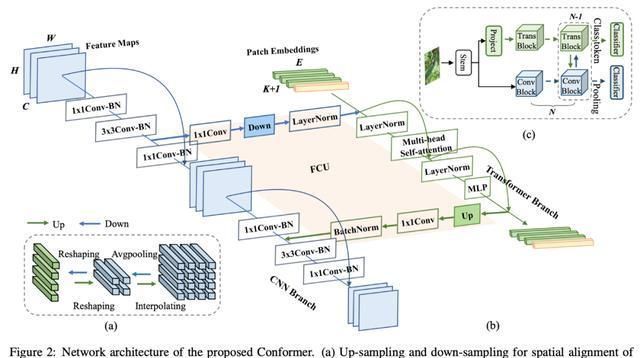
(c)展示了Conformer的缩略图:一个标准的ResNet stem结构,两条并行分支,两个分类器。
(b)展示了每个block中Trans和Conv的连接关系:以2个bottleneck为例,经过第一个bottleneck 3x3卷积后的局部特征经过特征耦合模块(FCU)传给Transformer block。
Transformer block将此局部特征与前一个Trans block的全局特征相加通过当前的trans block,运算结束后再将结果通过FCU模块反传给Conv block。
Conv block的最后一个bottleneck将其与经过1x1卷积后的局部特征相加,一起输入3x3卷积。
之所以将Transformer block夹在两个3x3卷积之间的原因有两个:
- bottleneck中3x3卷积的channel比较少,使得FCU的fc层参数不会很大;
- 3x3卷积具有很强的位置先验信息,保证去掉位置编码后的性能。
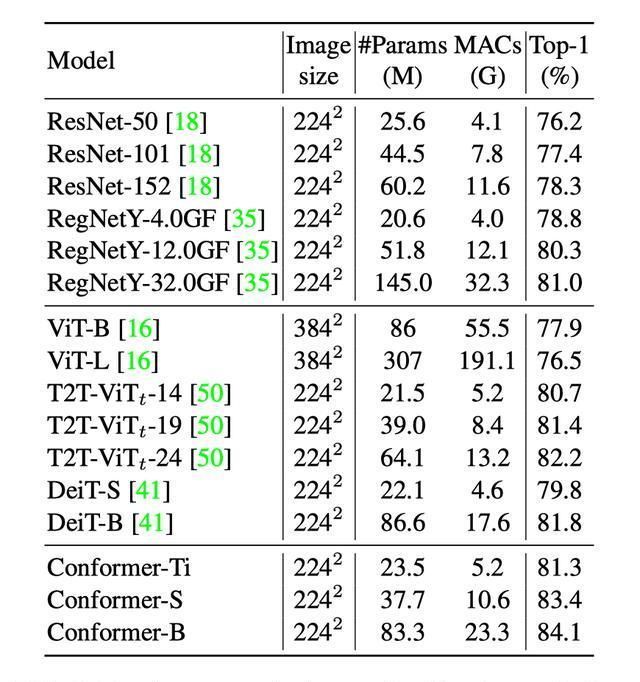
分类准确率对比
- 滴滴出行|裁员真能拯救中国互联网?
- 北斗|中国航天进入发展快车道
- 领军企业|30个!中国科协发布2022年科技领域重大问题难题
- 套餐资费|广电放号 5G套餐竞争告别“三国时代”
- Flyme|“国产系统之光”Flyme迎来十周年,纪念海报上线引发热议
- 零售业|确定涨价!iPhone14四款新机全面涨价!国行也在其中!
- 华为|意识到离不开中国了?外媒称华为、中兴或将重新打入美国市场
- 恒大|中国恒大回应被清盘呈请:极力反对 预期不影响重组计划
- 我国首个海洋油气装备投产!还有一批重大工程取得新进展→
- 第四大运营商|第四大运营商登场!中国广电官网上线:开启选号