
数据库|谈一谈数据分片

前言一般情况下 , 项目都是从一个小项目不断迭代成一个庞大的、复杂的大项目 , 比如我们做一个电商系统的时候 , 首先会把所有的业务表(比如订单表、用户表、商品表等等)放在同一个数据库中 。
但后来项目越做越大 , 这样把所有数据存储到单一数据节点的解决方案 , 在性能、可用性和维护成本这三个方面无法满足互联网海量数据的应用场景 。
性能以MySQL的innerDB存储引擎来讲 , 由于大多数关系型的数据库采用的是B+树的索引 , 在数据量超过超过阈值的情况下 , 索引深度的增加也将使得磁盘访问的IO次数增加 , 进一步会导致查询性能的下降(一般B+树的控制在1-3之间 , 也就是说 , 一次主键索引查询 , 可能会出现1-3次IO , 一张表存2000万条数据就要掂量掂量了);与此同时 , 高并发访问请求也使得单一数据节点成为系统瓶颈 。
可用性服务的无状态化 , 能够达到很小成本的随意扩容 , 这将会导致系统的最终压力都落在数据库 。 然而单一数据节点 , 很难承担 。 数据节点的可用性 , 是整个系统的关键 。
运维成本在一个数据库实例中的数据达到阈值以上 , 对于DBA的运维压力就会增大 。 数据备份和数据恢复时间成本都将随着数据量的大小而愈发不可控 。 一般来讲 , 单一数据库实例的数据的阈值在1TB之内 。
在传统的关系型数据库无法满足互联网场景需要的情况下 , 将数据存储在天然支持分布式的 NoSQL 数据库(比如我公司的订单表就存储到MongoDB上) 。 但 NoSQL 对 SQL 的不友好以及事务等问题 , 使得它们始终无法完全的替代关系型数据库 。
数据分片【数据库|谈一谈数据分片】数据分片是指按照某个维度将存放在单一数据节点中的数据分散地存放在多个数据节点或表中 , 来达到提升性能瓶颈以及可用性的目的 。
数据分片的核心手段就是对关系型数据库进行分库和分表 。 分库和分表均可以有效的避免由数据量超过可承受阈值而产生的查询瓶颈 。 除此之外 , 分库还能够用于有效的分散对数据节点单点的访问量(你想想看 , 查订单的去订单节点查 , 查用户的去用户节点去查);
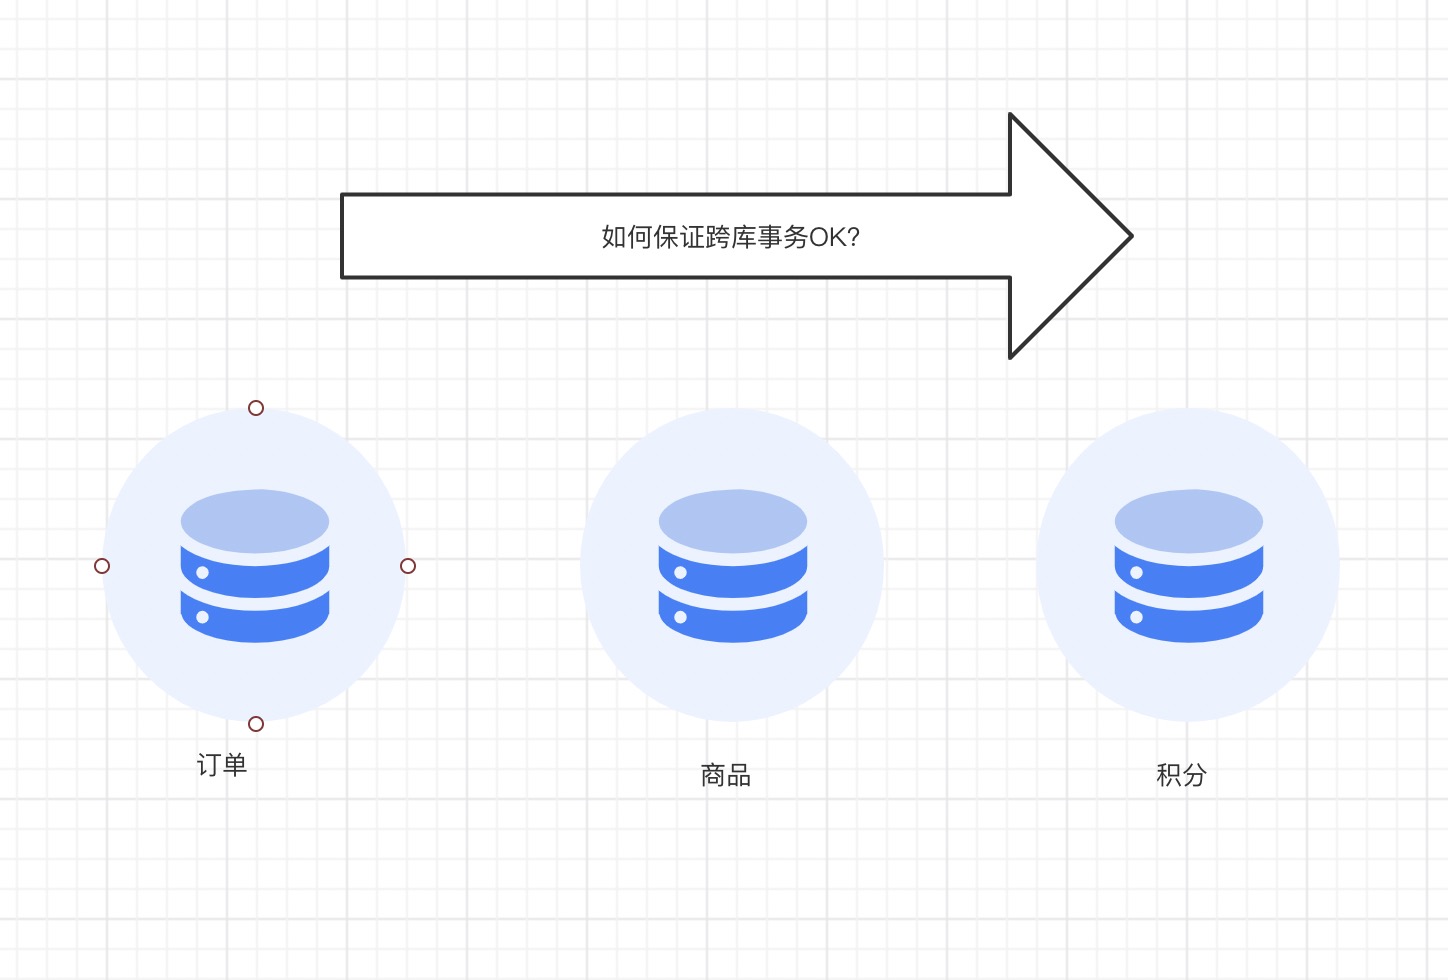
分表虽然无法缓解数据节点的压力 , 但却能够提供尽量将分布式事务变为本地事务来处理 , 一旦涉及到跨库的更新操作 , 分布式事务往往会使问题变得复杂(比如用户下订单时 , 扣积分、减库存就够你喝一壶了) 。
使用主从的分片方式 , 可以有效的避免数据单点 , 从而提升数据架构的可用性(更新操作去主节点 , 查询操作去从节点) 。
通过分库和分表进行数据的拆分来使得各个表的数据量保持在阈值以下 , 以及对流量进行疏导应对高访问量 , 是应对高并发和海量数据系统的有效手段 。
数据分片的拆分方式又分为垂直分片和水平分片 。
垂直分片按照业务拆分的方式叫做垂直分片 , 又叫做纵向拆分 , 就是专库专用的意思(有点像公司各个部门的意思 , 各司其职) 。 拆分之前 , 一个数据节点由多个业务表构成 , 每个表存储着不同的业务数据 。 而拆分之后 , 我们把表按照业务进行归类 , 分布到不同的数据节点中 , 从而将压力分散至不同的数据节点 。 比如与用户相关的放到用户库 , 订单相关的放到订单库 。
- 数据库|饿了么免单活动上热搜,是薅还是被薅羊毛?
- 算法|侃侃而谈| 为什么视频网站必然走向兼并整合?
- 北京市|36氪首发|云原生数据库公司「拓数派」完成新一轮战略融资,估值已达准独角兽级别
- 明码标价|3000元可购买整个学习通数据库?我们的信息被公开售卖,明码标价
- 数据库|撤离中国市场!美国科技巨头已全面关店,居然被一个小水杯击败
- |烘干机可以替代晾晒吗?入手烘干机2年,谈谈我的使用体验
- 数据库|真国产之光?曝小米12 Ultra将搭载三款自研芯片,全方位加强!
- 数据库|云正日益主导IT格局,中国云服务市场继续保持强劲增长!
- 数据库|想要商店的顾客源源不断?试试UGC,让顾客成为品牌的最佳代言人!
- 苹果|为什么女生更喜欢苹果手机,与手机店老板交谈后,他说了这些原因