
np-hDeepMind与谷歌又出大招!用神经网络解决NP-hard的MIP问题( 三 )
他们的方法将机器学习应用于 MIP 求解器的两个关键子任务:a) 输出能满足约束条件的所有变量的赋值(如果存在这样的赋值);b)证明变量赋值与最优赋值之间的目标值差距范围。这两个任务决定了该方法的主要组件,即 Neural Diving 与 Neural Branching(见图1)。 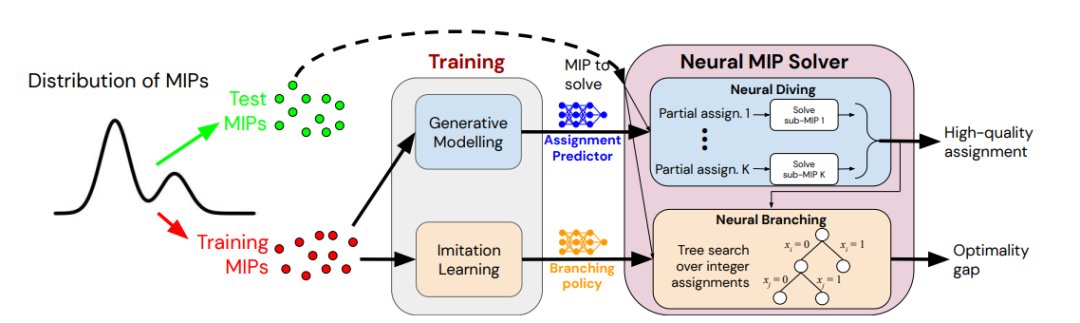
Neural Diving:该组件可找到高质量的联合变量赋值。它是原始启发式算法 (Berthold 2006) 的一个示例,而原始启发式是一类对有效 MIP 求解器十分关键的搜索启发式算法 (Berthold 2013)。
作者团队训练一个深度神经网络来生成输入 MIP 的整数变量的多个部分真值(partial assignments)。其余未赋值的变量定义了较小的“sub-MIPs”,它们是用现成的 MIP 求解器(例如 SCIP)求解来完成赋值。如果计算预算允许,sub-MIPs 可以并行求解。模型经过训练,使用现成求解器离线收集的训练示例,为灵活的、拥有更优目标值的赋值提供更高的概率。模型是基于所有可用的可行赋值而不是最优赋值来进行学习,且不一定要用到最优赋值(因为收集的成本可能非常昂贵)。
Neural Branching:该组件主要用于缩小最好赋值与最优赋值的目标值之间的差距。
在整数变量上,MIP 求解器使用了一种树搜索的形式,即“分支定界”,逐渐收紧边界并帮助寻找可行的赋值。在给定节点上,分支变量的选择是决定搜索效率的关键因素。
他们训练了一个深度神经网络策略来模仿专家策略所做出的选择。模仿目标是一个著名的启发式算法,称为“全强分支”(FSB),实践已证明,FSB 可以生成小型搜索树。虽然对实际的 MIP 求解来说,它的计算成本往往过高,但它仍可以被当成一种缓慢且昂贵的一次性计算,用于离线生成模仿学习数据。一旦经过训练,这个神经网络就能够在测试时以一小部分计算成本来接近专业表现。即使是在离线数据的生成上,基于 CPU 的 FSB 实现在大规模 MIP 上也可能过于昂贵。他们用交替方向乘子法 (ADMM) 开发了 FSB 的变体,可以通过在 GPU 上以批处理方式执行所需的计算来扩展到大规模 MIP。
DeepMind与Google Research的团队在许多包含大规模 MIP 的数据集上对这个方法进行了评估,包括来自 Google 生产系统的两个数据集,以及 MIPLIB(一个异构数据集和标准基准)。
来自所有数据集的大多数 MIP 组合集在预求解后都有 10^3-10^6 个变量和约束,明显大于早期工作(Gasse et al. 2019, Ding et al. 2020)。一旦 Neural Diving 与 Neural Branching 模型在给定数据集上进行了训练,它们会被整合到 SCIP 中,形成专门针对该数据集的“神经求解器”(Neural Solver)。SCIP是基线,重点参数分别在每个数据集上经过网格搜索进行调整,他们将其称为“Tuned SCIP”。
比较 Neural Solver 和 Tuned SCIP 在一组hold-out实例上原问题对偶问题的差距平均值 (如图2),在他们所评估的、具有最大 MIP 的4个数据集(一共有5个数据集)上,神经求解器(Neural Solver)在相同的运行时间内提供了明显更好的差距,或在更少时间内提供了相同的差距,同时在第5个数据集上媲美 Tuned SCIP 的表现。他们介绍,据他们所知,这是第一项在大规模现实世界应用数据集和 MIPLIB 上,使用机器学习比使用 SCIP 具有更大改进的工作。 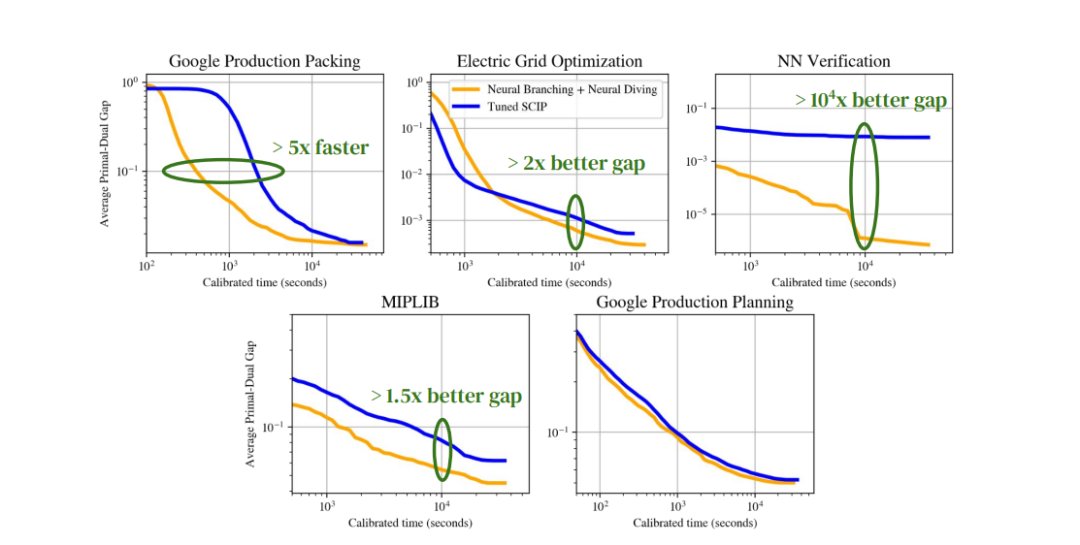
- 小米|小米12S系列官宣7月4日正式发布:小米与徕卡联合研发
- 新书推荐 │ 大数据算法设计与分析
- 最前线 | 腾讯游戏发布40余款产品与项目,《王者荣耀》发布全新规划
- 为了证明人类可与黑猩猩结合,女科学家亲身试验,结果怎么样?
- 腾讯游戏发布40余款产品与项目,《王者荣耀》发布全新规划
- 宇宙大爆炸与理解生命起源和进化有什么关联?
- 谷歌警告运营商小心Hermit间谍软件
- 湖北|巅峰摩擦?i9 12950HX与R9 6900HX专业应用差距有多大?
- FL Studio水果Cubase与Studio one三款编曲混音软件对比
- 南极洲第二入口被发现?谷歌人为掩盖地点,真有秘密基地?(上)