
rew数据科学家直指DeepMind:“强化学习无法实现通用人工智能”( 三 )
Silver 等人认为,如果一个智能体可以不断调整其行为以提高其累积奖励,那么其环境反复要求的任何能力最终都必须在智能体的行为中产生。
在Silver 等人在自然智能和通用人工智能之间进行了类比,并指出 “动物的经验流足够丰富和多样的,它可能需要一种灵活的能力来实现各种各样的子目标(例如觅食、战斗或逃跑),以便成功地最大化其整体奖励(例如饥饿或繁殖)。类似地,如果一个人工智能代理的经验流足够丰富,那么许多目标(例如电池寿命或生存)可能隐含地需要实现同样广泛的子目标的能力,因此奖励的最大化应该足以产生一种通用的人工智能。”
Roitblat 反驳道,只靠奖励本身其实是不够的,至少环境也发挥了作用。但适应的内容远不止这些。适应需要一个变异性的来源,从中可以选择出某些特征。进化生物学中这种变异的主要来源是突变和重组。任何生物体的繁殖都涉及到将基因从父母那里复制到孩子身上。复制的过程并不完美,并且会出现错误。其中许多错误是致命的,但也有一些不是,然后可用于自然选择。在有性繁殖的物种中,每一个亲本都贡献了其基因的一个副本(以及任何潜在的错误),这两个副本允许通过重组产生额外的变异性,一些来自一个亲本的基因,一些来自另一个亲本的基因传递给下一代。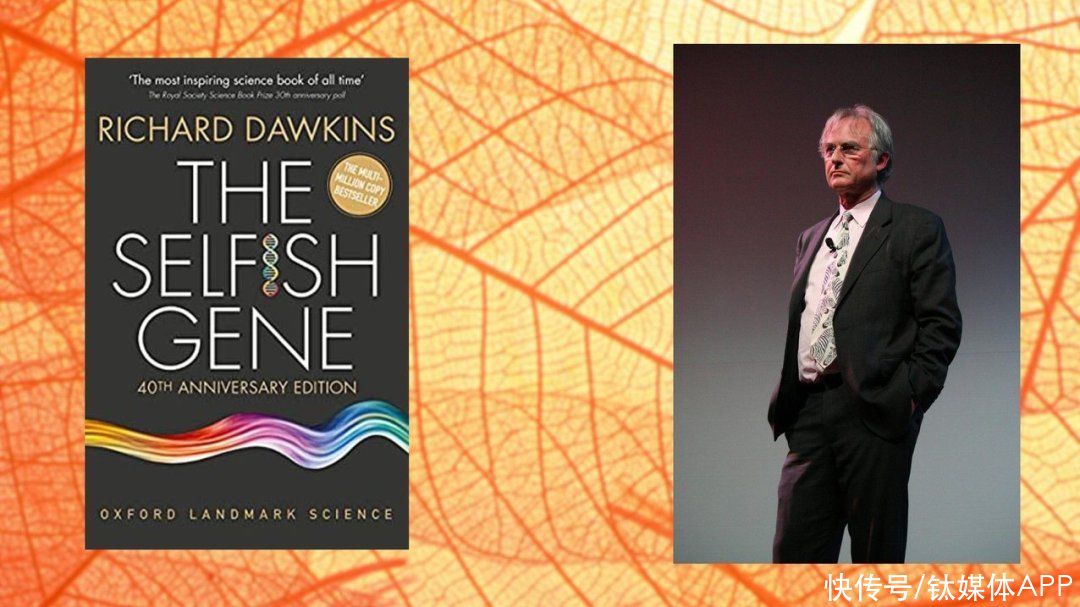
图 |英国生物学家 Dawkins(来源:Flickr)
奖励是选择。仅此而已,这是不够的。正如 Dawkins 所指出的,进化奖励是将特定基因传递给下一代。奖励是在基因层面,而不是在生物体或物种层面。任何能增加基因从一代传给下一代的机会的东西,都是对这种奖赏的调解,但请注意,基因本身并没有能力成为智能。
除了奖励和环境,其他因素也在进化和强化学习中发挥着作用。奖励只能从现有的原材料中进行选择。如果我们将一只老鼠扔进一个洞穴,它就不会像蝙蝠一样学会飞行和使用声纳。积累足够的突变需要多代甚至数百万年的时间,即便如此,也不能保证它能进化出与蝙蝠一样的解决洞穴问题的方法。强化学习是一个纯粹的选择性过程。强化学习是提高行动概率的过程,这些行动共同构成了处理某种环境的政策。这些行动必须已经存在,才能被选中。至少就目前而言,这些行动是由进化中的基因和人工智能中的程序设计师提供的。
针对这一问题,Silver 等人在论文中也提到,在不同的环境中实现不同的奖励最大化可能会导致不同的、强大的智能形式,每一种智能都会表现出自己令人印象深刻的、但又无法比拟的一系列能力。一个好的奖励最大化的代理将利用其环境中存在的任何元素,但某种形式的智能的出现并不以它们的具体内容为前提。
理论与现实的结合正如 Lachter 和 Bever 所指出的那样,学习并不像 Silver 等人所声称的那样从 "白板"( Tabula rasa )开始,而是从一组代表性的承诺开始。Skinner 的大部分理论都基于动物的强化学习,尤其是鸽子和老鼠。他和许多其他研究人员在严酷的环境中研究了它们。对于老鼠来说,那是一个房间,里面有一个供老鼠按压的杠杆和一个提供奖励的喂食器。老鼠除了在短距离内徘徊并接触杠杆外,没有什么其他可以做的。鸽子也在一个包含啄食键(通常是墙上的一个有机玻璃圈,可以被照亮)和一个提供奖励的谷物喂食器的环境中接受了类似的测试。在这两种情况下,动物都有一种预先存在的偏见,即以行为学家希望的方式作出反应。事实证明,即使没有奖励,老鼠也会接触杠杆,鸽子也会在黑暗的盒子里啄食发光的钥匙。这种以理想方式做出反应的倾向使得训练动物变得容易,研究者可以不费吹灰之力地研究奖励模式的影响。但多年后人们才发现,选择杠杆或啄食钥匙并不只是一种任意的便利,而是一种未被承认的 "幸运选择"。
- 为验证人类和黑猩猩,是否会产生新的后代,科学家找来5位姑娘!
- 为什么科学家表示人类“灭绝”的可能性极低?这些理由你赞同吗?
- 喜马拉雅发现新物种!科学家发现“雪人”遗物,令人感到意外
- 为什么科学家知道太阳的原理,却无法制造出人造太阳
- 土耳其发现四肢爬行人群,这是咋回事?科学家警告:人类要留心了
- 创业|八成互联网电视非法采集用户数据, 彩电企业怎么办?
- 新书推荐 │ 大数据算法设计与分析
- 为了证明人类可与黑猩猩结合,女科学家亲身试验,结果怎么样?
- 在南极3500米的深海,科学家发现新物种,这是个透明的肉球?
- 太空中的真菌毒素是否危害宇航员健康?科学家:尚不明确