
模型|继LSTM之父用世界模型来模拟2D赛车后,谷歌又推出全新世界模型助力导航:360度无死角,就问你怕了没?( 二 )
2、Pathdreamer的诞生
受到 Jürgen Schmidhuber 等人的工作启发,谷歌团队开始将世界模型的研究思想应用在同样是智能体控制的机器人导航任务中,使用世界模型来获取周围环境的信息,使智能体能够在特定的环境中预测自己的行为后果。
图 / 世界模型的工作原理
在了解Pathdreamer之前,我们不妨设想一下:
如果你出去旅游,住进一间完全陌生的民宿,你会如何判断房子的方位?
一般来说,当我们推开大门,我们会知道首先映入眼前的是客厅,然后顺着客厅猜测卧室、厨房、阳台等等空间的方位。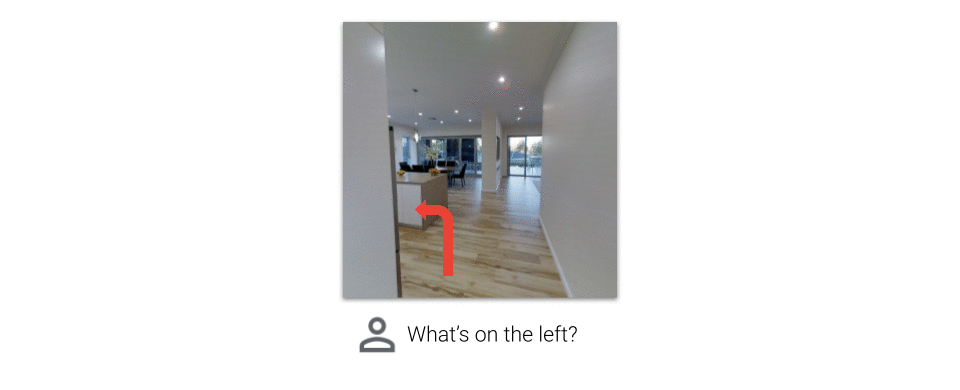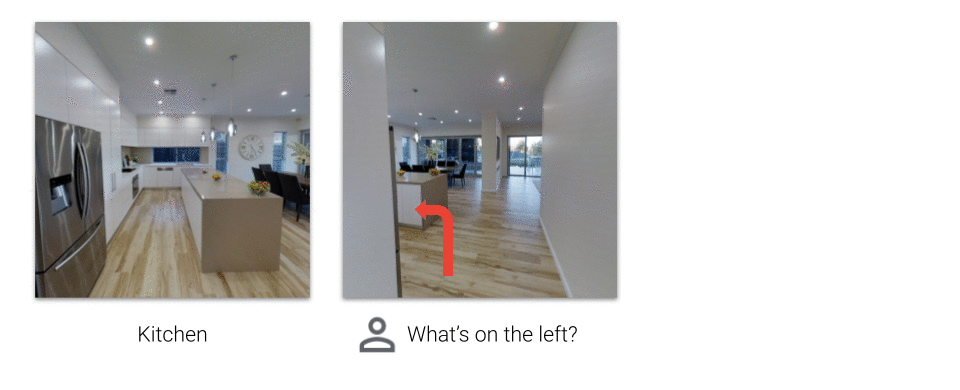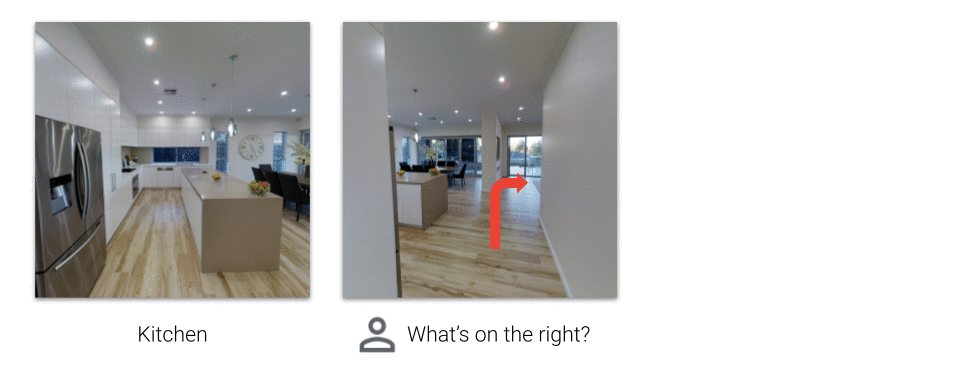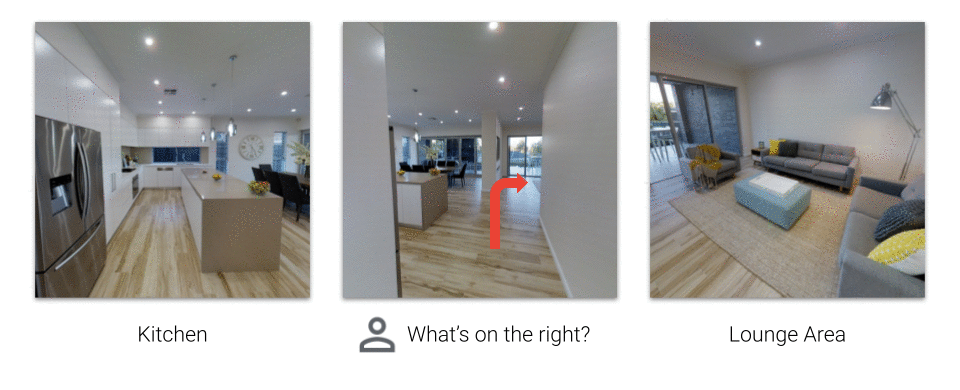
图 / 人的导航习惯是依据眼前所见之物来判断
那么,机器人呢?如果一个机器人来到一个完全陌生的房子里,它会如何导航?
人在判断方位时,善于利用视觉与常识,通过眼前的事物推理出空间的布局,从而找到自己的目标。但是,对于机器人来说,在一个新的建筑里,要利用语义线索与事物的规律分布来定位,并不是一件容易的事。
此前,针对上述问题,Facebook AI 提出了一个算法,叫“DD-PPO”,主要是:通过无模型强化学习(model-free reinforcement learning),以端到端的方式让智能体学习辨认一个空间内的线索、并利用这些线索来完成导航的任务。
但是,这种方式的学习成本高,难以检验,而且泛化难,另一个智能体必须从头开始学习同样的方式、才能掌握依据理解线索来定位的能力。
相比之下,Pathdreamer 模型可以从单一视角合成一幅沉浸式场景图,预测当智能体移动到一个新的视点、或是移动到一个完全看不见的区域(比如角落)时,智能体可能会看到什么。
这不仅可以用于视频编辑、使照片看起来栩栩如生,最重要的是,它还可以将人类环境的知识告诉机器智能体,帮助机器人在现实世界中定位导航。
比如,如果我们给机器人一个任务,让它在一栋陌生的建筑里寻找某个房间或物体,那么它就可以先在世界模型中进行模拟,学习识别物体在空间中可能的位置,减少实际投入后的导航错误。
除了模拟导航以外,机器人在Pathdream等世界模型中训练,还可以增加训练数据的数量。
3、Pathdreamer的工作原理
Pathdreamer 将原来的一个或多个观察序列作为输入,生成通往目标位置的预测路线。预测的路线是事先提供,或由智能体在返回途中接触到的观察迭代更新。输入与预测均包含 RGB、语义分割与深度图像。
在内部,Pathdreamer 使用了 3D 点云来表示环境的表面。云中的点都标了它们的 RGB 颜色值和它们的语义分割类,比如墙壁、椅子或桌子。
要在新的建筑物里预测即将映入眼前的事物,首先要将点云重新投射到新建筑的 2D 图像中、以提供“指导”图像,然后,Pathdreamer 会从中生成逼真的高分辨率 RGB、语义分割和深度。
随着模型的“移动”,点云会积累新的观察结果(要么是真实的,要么是预测的)。使用点云来记忆的一个优势是时序一致性(temporal consistency)——重新访问的区域会以与先前观察一致的方式呈现。
为了将指导图像转换为合理、真实的图像输出,Pathdreamer 分为两个阶段运行:第一阶段,用结构生成器生成分割和深度图像;第二阶段,用图像生成器将分割与深度图像渲染为 RGB 输出。
从概念上讲,就是第一阶段提供了关于场景的合理高级语义表示,第二阶段再将其渲染为逼真的彩色图像。这两个阶段都用到了卷积神经网络(CNN):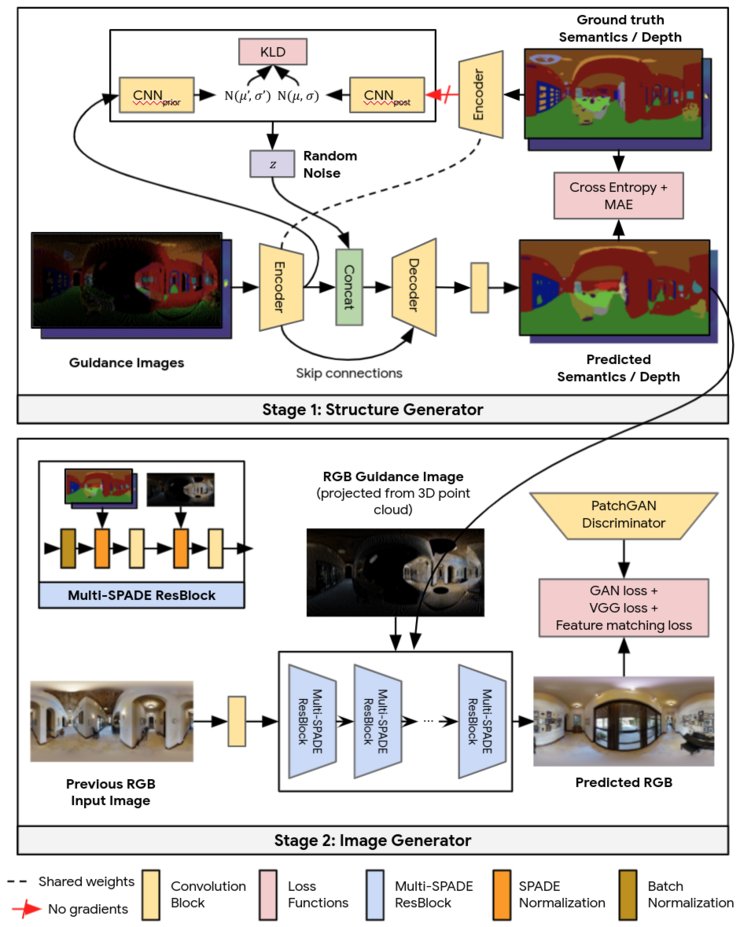
- Java|Gamamobi CEO黄继德:我们的元宇宙游戏不担心体验落差
- 继华为nova10系列线下物料曝光后|华为nova 10真机上手图曝光:后摄神似“双星伴月”
- 联想|手机黑马真我GT2大师探索版 继小米12Ultra骁龙8gen1plus首发机型
- 显示器|刹不住车?爆腾讯下半年将继续大规模裁员
- 抖音|信号继电器如何分类? 信号继电器的工作原理及作用
- 5G|狂欢继续 嗨购不停 6月购三星Galaxy S21 FE 5G享好礼
- 奥拓电子|刹不住车?爆腾讯下半年将继续大规模裁员
- 从几个月到几分钟,NLP模型运行效率暴涨,小公司也能玩大模型
- 腾讯文档|从事展览3d模型设计,你需要具备那些能力?---模大狮网
- 电动自行车|iPhone14今年屏幕需求或超2.05亿块,京东方继续供货