
阿里巴巴|阿里云数据湖3.0:数据价值归于“原点”
对企业来说 , 数据作为一种“无形资产”的重要性也变得比以往更加凸显 。 企业的数字化战略开始从“业务驱动”转向“数据驱动” 。 数字化转型的前提是数据化 , 所以数据成为了一种新的生产资料 , 也成为了数字化业务新的“原点” 。
如果将数据比作自然世界中的水 , 无论是江川还是河流 , 数据的流动都像是“涓涓细流” , 所以“河道”治理 , 也相当于数据处理的难度并不大 。
当来自江川和河流的水源源不断地汇聚 , 大量的水域形成一片湖泊 , 大数据的理念就此产生 , 这片“数据湖”显然就是为了处理大数据而生 。
数据湖逐渐成为新的标准
如同数据湖概念的提出者James Dixon所说:“如果数据集市是一个商店的瓶装水 , 数据被过滤包装结构化以供使用——数据湖则是在更自然状态下的大量的水 。 数据湖中的数据来源于不同地方 , 用户可以进入数据湖中按需提取所需要的数据” 。
简单地说 , 数据湖的概念 , 代表了一种新的数据存储理念 , 它是一个存储企业的各种各样原始数据的大型仓库 , 其中的数据可供存取、处理、分析及传输 。 Hadoop则是最常用的部署数据湖的技术 。
数据湖之所以被很多企业寄予众望 , 在于它的部署简单 。 过去的企业存储和数据库有各种各样的复杂标准 , 而数据湖通常只是企业所有数据的单一存储 , 包括源系统数据的原始副本 , 以及用于报告、可视化、分析和机器学习等任务的转换数据 , 等于包含了结构化数据 , 半结构化数据 , 和非结构化数据 。
显然这种对数据的兼容并包 , 能给企业很快带来多种能力 , 如数据湖结合数据科学与机器学习技术 , 能帮助企业构建更多优化后的运营模型等等 。
正因为如此 , 很多企业都在计划构建自己的数据湖 , Gartner 2020年发布的报告显示目前已经有39%的用户在使用数据湖 , 34%的用户考虑在1年内使用数据湖 。 也有数据预测数据湖市场规模在2024年将增长到201亿美金 。
云服务商是数据湖技术发展的主要倡导者 , 也是主要是的受益者 , 如AWS、微软Azure和阿里云都有备受用户认可的数据湖服务 。 云服务商的数据湖服务可以满足企业业务的高弹性需求 。 企业无需先期购买服务器、存储等硬件设备 , 降低了运维成本使用成本 , 提高了资源利用率 , 同时可以支持数据多元集成和迁移 , 大幅带动提升了企业原有分析和治理系统的性能优化 。
从1.0到3.0从“成本中心”到“创新中心”
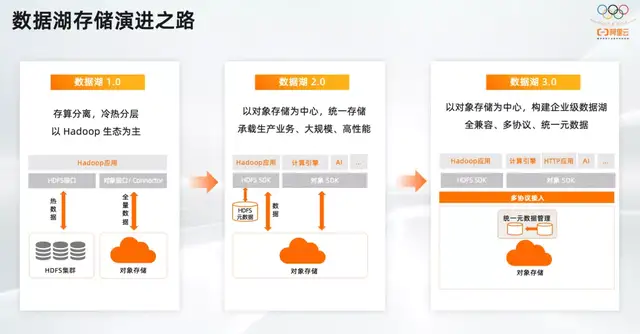
与很多技术的发展趋势一样 , 数据湖也经历过初期的粗放式发展 。 数据湖的1.0时代主要是开源Hadoop数据湖架构 , 原始数据统一存放在 HDFS 系统上 , 引擎以 Hadoop 和 Spark 开源生态为主 , 存储和计算一体 。
对象存储的发展为数据湖提供了强有力的支撑 , 由于对象存储对于文件数量、存储容量没有限制 , 极大突破了HDFS(Hadoop分布式文件系统)因为Namenode设计机制无法支撑大量小文件的困境 , 通过冷热数据分层模式 , 可以显著优化成本 。
但缺点同样明显 , 因为原始数据统一存放在HDFS系统上 , 引擎以Hadoop和Spark为主 , 受到开源软件本身能力的限制 , 传统技术无法满足企业用户在数据规模、存储成本、查询性能以及弹性计算架构升级等方面的需求 。
在此背景下 , 数据湖2.0架构应运而生 , 用户在此架构下不再需要搭建HDFS数据集群 , 同时数据湖可以直接接入业务生产中心 , 如业务系统中的原始数据、日志数据等 , 数据可通过互联网直接入湖 , 无需经过中间处理 , 提升业务效率 。
- 阿里巴巴|电商转折点出现?神秘消失23天的李佳琦,意外暴露了阿里的问题
- 华为|云计算的到来,在你身边有哪些相关联的。怎么看云计算呢(十九)
- 马云|马云自己\打脸\之前所说的,如今现身西班牙,开12亿游艇!
- 云厂商为什么都在冲这个KPI?
- Java|李佳琦消失扯下阿里“遮羞布”,原来淘宝根本就没有护城河
- 云计算|云计算的到来,在你身边有哪些相关联的。怎么看云计算呢(十五)
- 金山云|2000元的手机也搭载4nm芯片,为啥还要买四五千元的?看完明白了
- 嘉定这家专业用品市场推出“云逛店”模式
- 蚂蚁森林|马云承诺每年在沙漠里“种树”,如今6年过去了,现在怎么样了?
- 阿里巴巴|李佳琦消失扯下阿里“遮羞布”,原来淘宝根本就没有护城河