
open图像版GPT3问世,一句话就能变成图!打破语言与视觉界线,AI将更加聪明( 二 )
OpenAI 团队在其博客文章中称展示的结果并不是人工挑选的,而是通过另一款模型 CLIP 进行排序的,CLIP 会选出它认为最符合描述的 32 张图像。此过程也可以看作是一种语言指导的搜索,会对样本质量产生巨大影响。
如下图所示,使用 CLIP 对 DALLE 中的样本进行重新排序,可以大大提高样本的一致性和质量。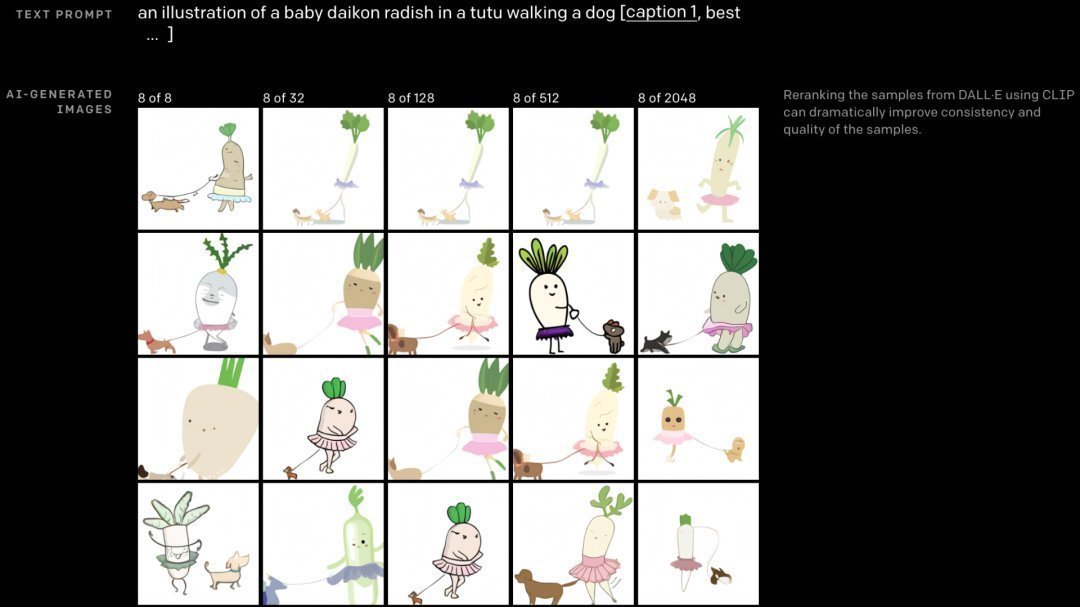
图|CLIP 可以对 DALLE 中的样本进行重新排序
据悉,OpenAI 计划在下一篇论文中提供有关 DALLE 架构和训练过程的详细信息。
DALLE 和 CLIP 是从两个不同的方向来解决这个问题的。CLIP 是对搜集到的图片进行理解、分类,而 DALLE 是根据文本生成图片,两个模型可以理解为互为逆过程。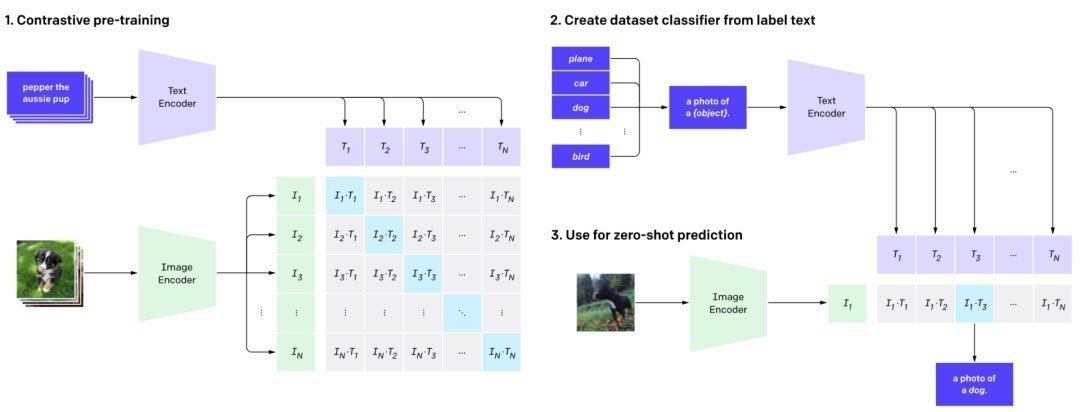
图|CLIP 的预训练过程
据了解,OpenAI 用高达 4 亿的数据集来训练 CLIP,它可以在各种各样的图像上进行训练,主打零样本学习,攻克了计算机视觉领域中数据集昂贵和狭窄的问题。
将语言建立在视觉理解上是让 AI 更加聪明的好方法
OpenAI 这次推出的多模态模型成果惊人,但仍然不尽完美。比如 DALLE 根据 “画着蓝色草莓的彩色玻璃窗” 这一文本创建的图像就有些让人迷惑,不仅掺杂着红色草莓,而且有些图像抽象到看不出是窗户或者草莓。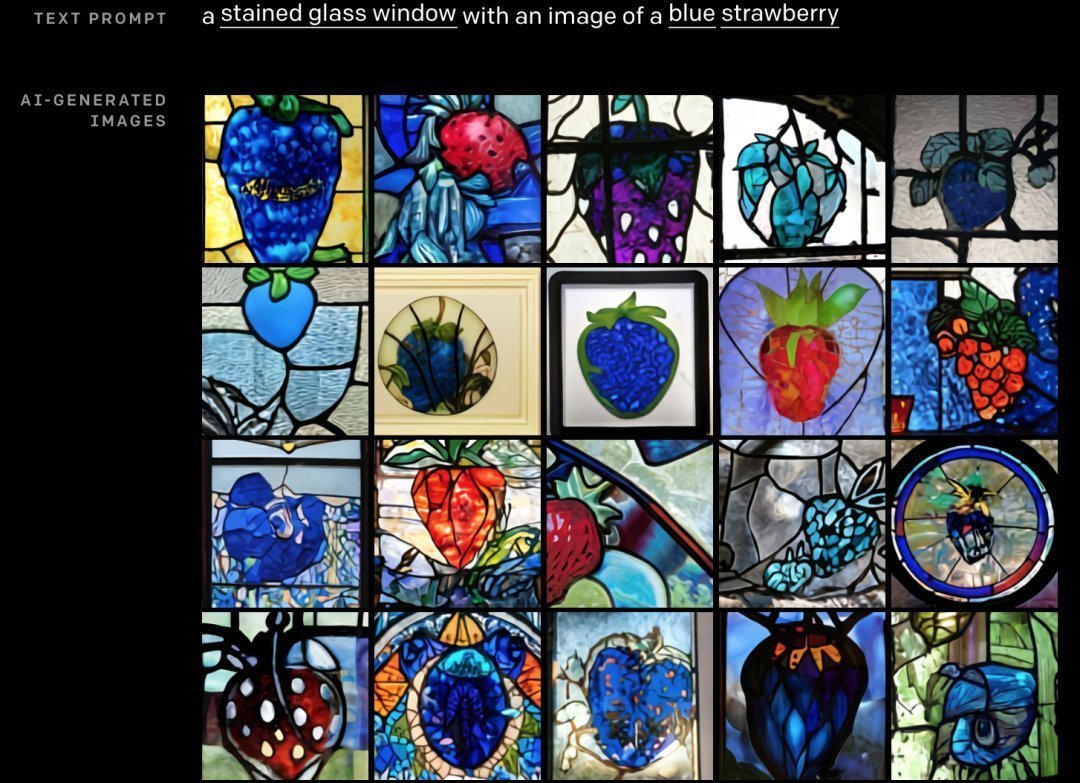
图|DALLE 根据 “画着蓝色草莓的彩色玻璃窗” 这一文本创建的图像
再比如,OpenAI 工作人员 Aditya 认为以 “竖琴做成的蜗牛” 为文本生成的图像就很别扭,图像中蜗牛和竖琴以奇怪的方式结合在一起。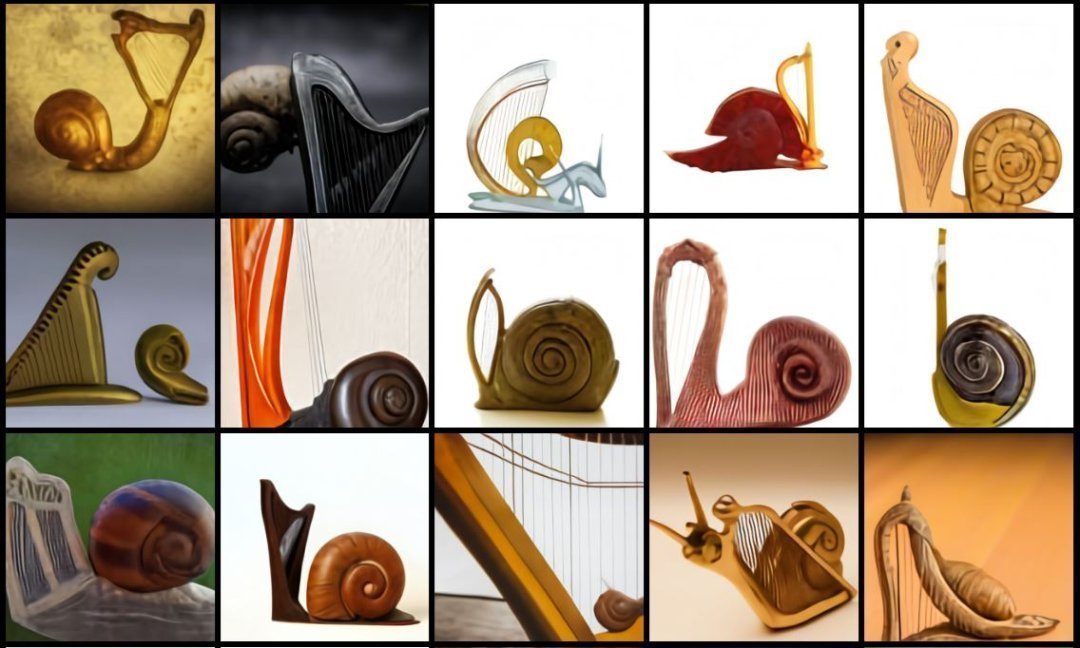
图|DALLE 生成的 “竖琴制成的蜗牛”
艾伦人工智能研究所的阿尼肯布哈维(Ani Kembhavi)说:“这个模型能从相当异想天开的文本中生成合成图像,这在我看来非常有趣。” 他的同事 Jaemin Cho 也对此印象深刻,“现有的文本 - 图像生成器还没有显示出绘制多个对象的控制水平,也没有 DALLE 的空间推理能力,” 他说。
佐治亚理工学院从事自然语言处理和计算创造力的 马克里德尔(Mark Riedl )则大胆质疑该模型生成的卡通图像,“我对萝卜的例子有点怀疑,从风格上看,它可能记住了一些来自互联网的艺术作品。DALLE 所基于的 GPT-3 在记忆方面可是出了名的。” 他说。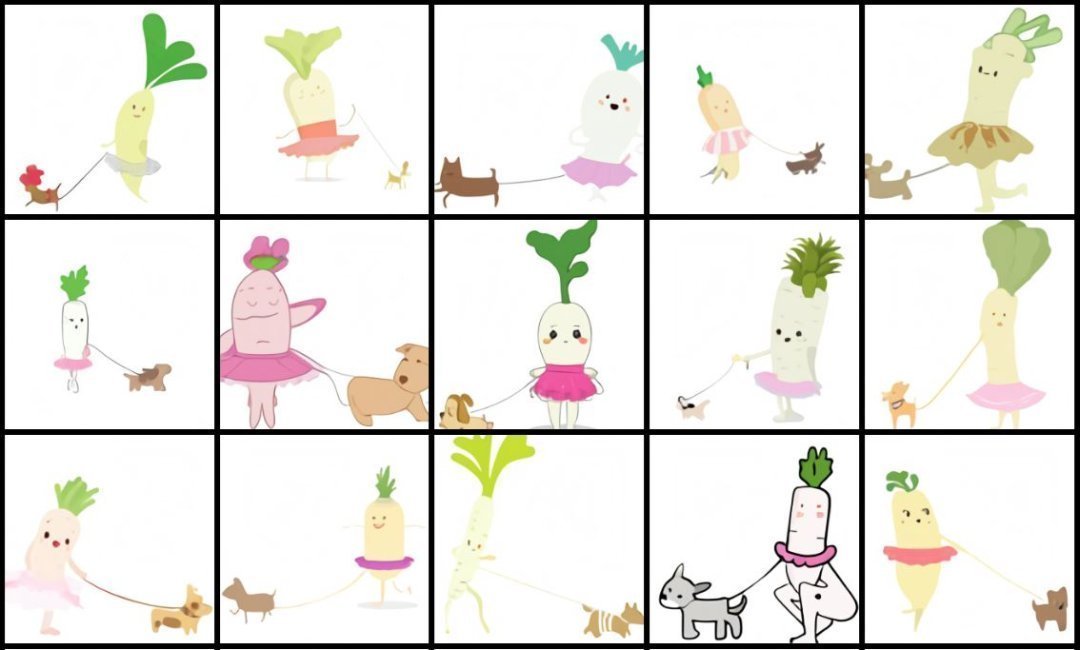
图|DALLE 根据 “穿着芭蕾舞短裙遛狗的小白萝卜” 这一文本生成的图像
尽管如此,大部分 AI 研究人员仍然认为,将语言建立在视觉理解上是让 AI 更加聪明的好方法。
【 open图像版GPT3问世,一句话就能变成图!打破语言与视觉界线,AI将更加聪明】“未来的系统将由这样的模型组成,它们都是朝着那个系统迈进的一步。”OpenAI 首席科学家 Ilya Sutskever 说。
- 图像传感器|到手1849元重量189g这才是高性价比的骁龙870直屏手机
- 微信更新正式版!“清理缓存”功能变强,小程序终于能分享到朋友圈
- 口红|下周发布!华为P50 Pocket新版开启预订:送1699元口红耳机
- 拼多多|拼多多推出PC网页版商城,或只为缓解增长焦虑
- 苹果|9999元!M2版苹果新MacBook Pro升级开倒车 固态盘性能测试非常慢
- GeForce|英伟达GeForce RTX 4090系列渲染图曝光:FE版将超过三槽规格
- iqoo|iQOO 10系列搭载蓝厂自研V1 ISP芯片 有望首发天玑9000+新机版本
- 拼多多|拼多多网页版终于上线,最大短板补足了吗?
- 图像处理|懂点AI或图像处理,一般性抠图作图连PS都不用了
- 物联网|微信iOS版8.0.24正式发布:iOS16闪退问题已解决,并有新功能