
翻译|这年头,机器翻译都会通过文字脑补画面了( 二 )
在这这种情况下,纯文本的翻译模型只能通过丢失词语的上下文和偏置来推理句子的翻译。
多模态机器翻译则会利用标注的图片进行翻译。
而ImagiT在缺少图片标注的情况下,还能根据退化的文本想象并恢复丢失的信息。
通过这一特殊的探索实验,可以看到ImagiT能在训练阶段学习特定词语(色彩,可被具象化的实体词等)与其他词语之间相关性和共现。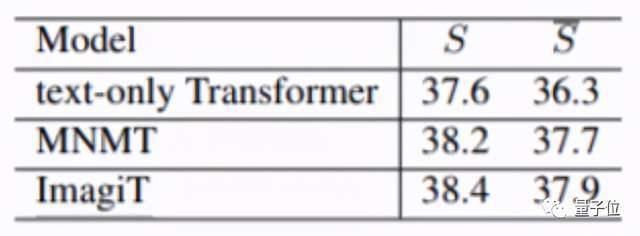
△将源语言文本中所有的色彩词全部替换为特殊字符。而对比纯文本翻译,通过想象恢复被替换文本的ImagiT模型在翻译质量上下降的幅度也最少。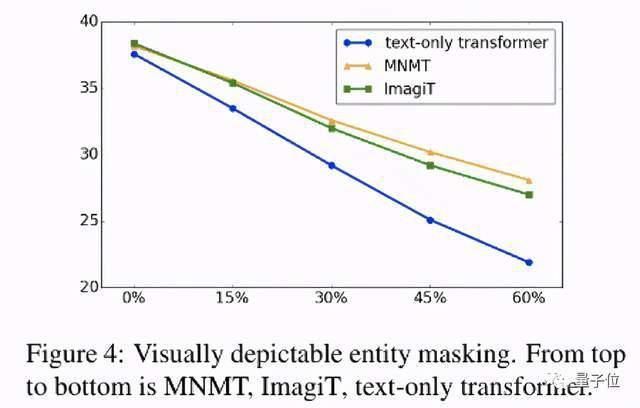
效果如何?由于ImagiT不需要图片作为输入,所以在测试时选用纯文本的transformer模型作为baseline。
在Multi30K的英法、英德Test2016,Test2017上进行测试时,ImagiT得到了与SOTA多模态翻译系统相当的表现: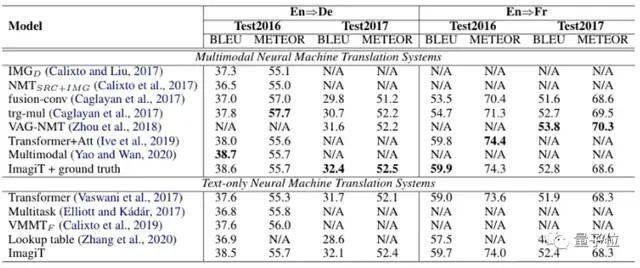
而在Ambiguous COCO上也展现出了不错的测试结果: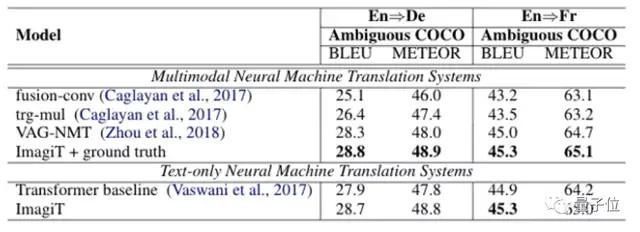
论文地址:【 翻译|这年头,机器翻译都会通过文字脑补画面了】https://arxiv.org/abs/2009.09654
- 京东|裁员不忘膈应人,这家互联网大厂送的离职礼物恶心到我了!
- 炸锅|酷暑之下,莫让这些谣言再增“热”度
- 有人觉得中暑就是热出来的,吃一些退烧药就好了,这种做法 蚂蚁庄园今日答案6月28日
- 为什么科学家表示人类“灭绝”的可能性极低?这些理由你赞同吗?
- 显卡|这就是RTX 4090 Ti显卡?又厚又重,超过三槽要1200W电源
- 土耳其发现四肢爬行人群,这是咋回事?科学家警告:人类要留心了
- 图像传感器|到手1849元重量189g这才是高性价比的骁龙870直屏手机
- ios16|一步到位能用5年,目前这3款手机能闭眼入,买手机不要太小气
- 微信阅读口袋电子书599元
- 在南极3500米的深海,科学家发现新物种,这是个透明的肉球?