
模型|北大校友马里千:计算机视觉商用的下一个十年,AI 生成应占有一席之地( 三 )
发表于NIPS 2017的工作“Pose Guided Person Image Generation”是马里千在博士期间的代表工作之一。这篇工作主要研究 2D 人体姿势迁移,首次定义了人体姿势变换这一问题。
【 模型|北大校友马里千:计算机视觉商用的下一个十年,AI 生成应占有一席之地】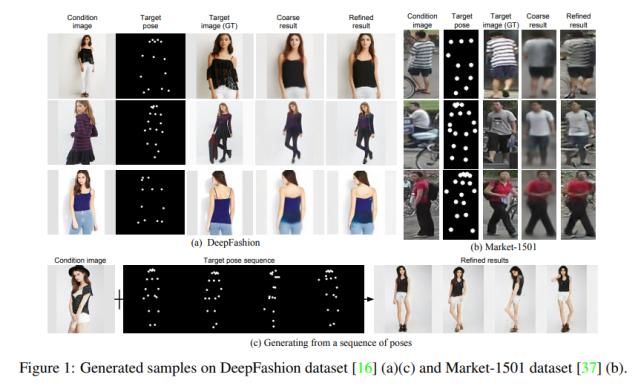
论文地址:https://arxiv.org/pdf/1705.09368.pdf
自此,马里千打开了“图像内容生成”的大门。
正式转为博士生后,(非欧盟硕士到欧洲大学读博需要经历预博士时期),马里千在人体生成方向继续发力,又在 CVPR 2018 上发表了一篇通过解耦来进行图像编辑、“无中生有”的工作,即“Disentangled Person Image Generation”。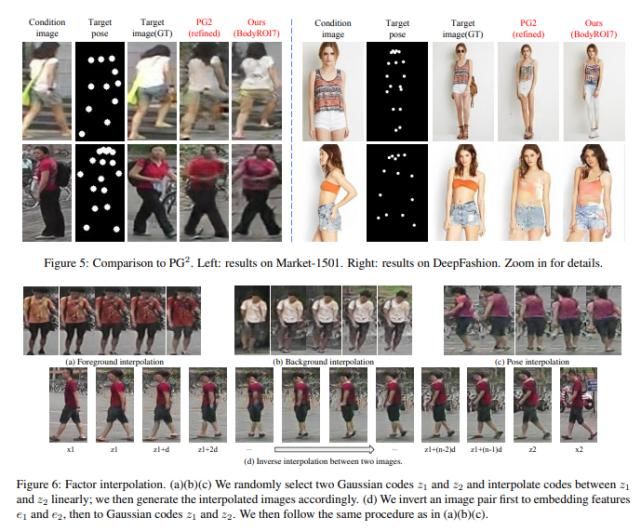
论文地址:https://arxiv.org/pdf/1712.02621.pdf
NIPS 2017的工作需要使用同一个人的不同姿势的数据(即“pair data”,配对数据)对模型进行训练,这就造成一个限制:如果从网上爬数据,那么爬到的数据很可能是一个人在一个场景上的单个姿势照片,而无法获取 Ta 在同一个场景的不同姿势照片。针对这种情况,马里千便想到使用“unpair data”(非配对数据)来进行模型训练。
新的训练方式延伸出其他的技术效果。CVPR 2018的文章提出了一种基于自监督的解耦表达人体前景、背景、姿态特征的生成式模型。模型可以将人体的不同要素(五官、手臂、脚等等)进行解耦,然后通过分别控制这些要素来进行图像编辑,而不再局限于修改输入人体的姿势。总的来说,该模型可以用于人体图像生成与编辑,样本插值,人体姿态变换,以及行人重识别。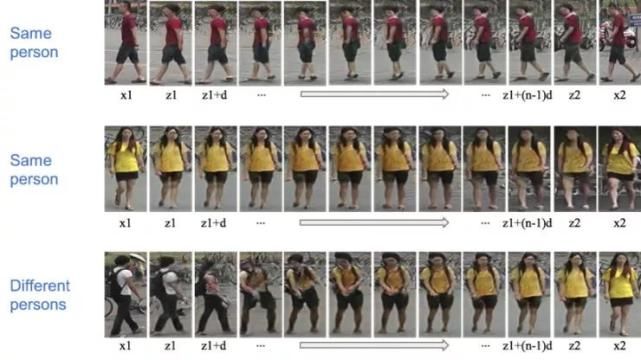
图注:人体图片样本插值(x1 和 x2 是真实图片)
此外,他们提出一种「高斯噪声-> 特征 ->图像」的映射方式,使得模型可以分别从高斯空间采样得到对应的前景、背景、姿态。学习方法分为一阶段(解耦图像重建)与二阶段(嵌入特征映射),其中,一阶段模型可以完成对人体图像的编辑,例如变换姿态和外观。但二阶段可以从先验分布中进行采样,生成一个完全不存在的人。
除了人体识别生成,马里千的研究工作还包括场景识别生成。
人体的运动更多是动态的、非刚体的,而场景研究则聚焦于静态物体,且更多是刚体运动。比如,一辆车的形变不会太大,但人体的形变非常不规则(这也是人体识别研究的主要难点之一)。
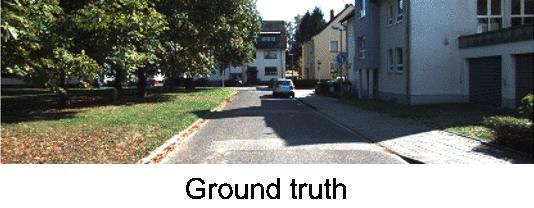
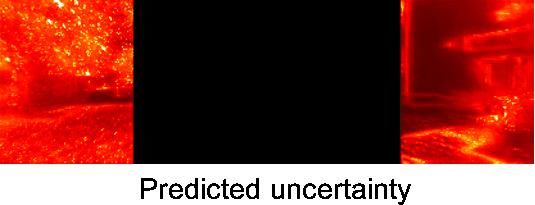
根据场景研究的特点,马里千与团队成员从场景的3D信息入手,以进行场景视野的拓展。比如,最新发表的工作“Field-of-View Extrapolation Using Self-Attention and Uncertainty”(RAL-ICRA 2021,已申请欧洲和美国专利)可以将一个窄视频自动生成宽视频,有望应用于电影特效场景的合成: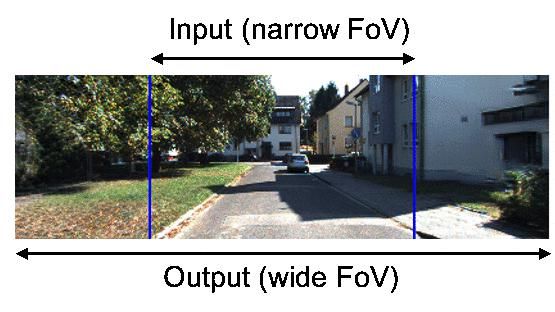
马里千认为,人体与场景的结合研究是必然的:场景解读可以促进人体行为理解,人体理解也能促进场景解读。比如,如果一个人的旁边有一张椅子,那么这个人的动作很可能是坐着;又或者,一个正在打篮球的人,很大概率身处在篮球场中。
“我一直想做的是实现影视自动化。”马里千兴奋地说道。
3
生逢其时的“生成式AI”时代
在马里千看来,影视自动化涵盖内容生成的各项技术,是考验AI内容生成水平的最佳平台。如果 AI 技术能够根据脚本自动生成一部影视作品,那一定非常震撼:“对我来说,从技术层面来看,影视自动化方向就代表了内容生成的终极目标。”
- 从几个月到几分钟,NLP模型运行效率暴涨,小公司也能玩大模型
- 腾讯文档|从事展览3d模型设计,你需要具备那些能力?---模大狮网
- 英伟达|NVIDIA Triton 推理引擎公开课上新:基于多实例 GPU 和 K8s 的大规模 CV 模型部署实践
- 肠道菌群|肠道菌群又有新“用途”:建立非酒精性脂肪肝发病预警模型
- aiXcoder XL智能编程大模型发布:自然语言一键生成方法级代码
- AI自己写代码让智能体进化!OpenAI的大模型有“人类思想”那味了
- 字节跳动 AI Lab 提出多模态模型:X-VLM,学习视觉和语言多粒度对齐
- 电子商务|虚拟化身动作不协调?Meta开源肌肉骨骼动力学模型MyoSuite
- 小米科技|小米汽车露真容:雷军迫不及待,先晒模型图,是一台SUV
- 百度APP数字人上线个性化AI陪聊功能 文心大模型助力对话交互式搜索创新